本期数字:新增 119 篇 / 119 项独立工作 · 主线:VLN 14 篇 / 具身 Agentic 导航 5 篇 · 其他方向 100 篇 · R2R-CE 2 篇 · 公众号 0 条 · 另更新已有论文 6 篇
一、本期要点
- 连续导航性能与指令忠实度开始分开检验。 SimpleVLN报告连续基准成绩,NavBind 则固定场景和历史、改变分叉指令,检验动作是否随语言改变;本期两项 R2R-CE 工作提供了不同层面的证据。
- 找到候选物体之后,还需要主动确认。 CLOSER把停止前的核验变成多视角取证;目标识别、距离判断与停止决策被单独研究,而非全部归入探索失败。
- 可达与可通过是两种条件。 PASS-VLN改变机器人宽度检验到达或停下,VeSTA则在严格接触反馈下优化候选轨迹,分别处理本体约束与碰撞执行。
- 记住对话不等于找得到对象。 DialogMem中,把对话追加到视觉记忆明显改善问答,却几乎不改善导航;对象关联、正确检索和位置恢复仍是独立瓶颈。
二、精读
1. SimpleVLN:保留原生架构,联合优化记忆、数据与训练
论文 · 主线:VLN · 我的导读 · 指令跟随 · R2R-CE / RxR-CE(连续环境)
问题。 增加专用模块之前,原生多模态模型的导航潜力是否已被充分挖掘?
方法。 固定预算的全局与局部记忆配合动作块;专家示范、随策略变化的 DAgger 数据与合成任务,支持 IL→DAgger→RL 的渐进训练。
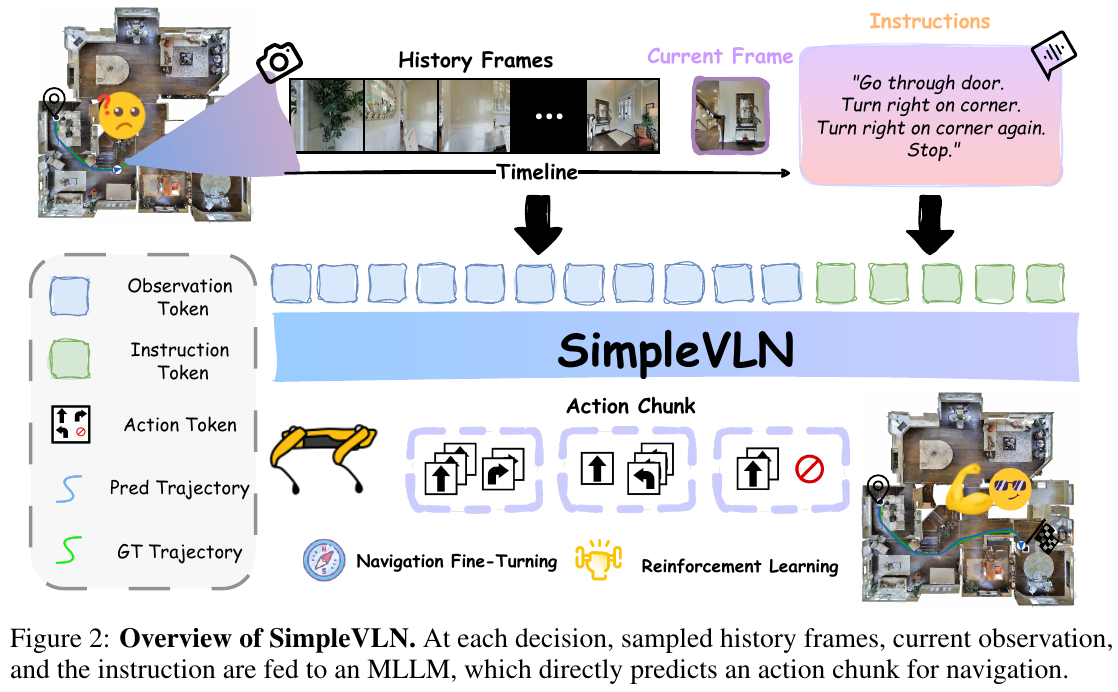
证据。 摘要报告 R2R-CE SR 76.7%、RxR-CE SR 80.1%,未注明具体划分。
判断。 适合作为检验新增架构收益的地面 VLN 基线。训练与数据因素同时改变,仍需查消融、数据预算及接触设置;摘要未给真机指标。
下一步。 精读:先核对评测划分,再分离记忆、DAgger 与 RL 各自的增益。
2. CLOSER:把停止决策改成主动取证
论文 · 主线:VLN · ObjectNav · Gibson / Habitat-Matterport 3D
问题。 检测器会把相似物体认成目标,单帧高置信判断可能导致错误停止。
方法。 经微调的 VLM 为跟踪候选的各视角输出目标、非目标或不确定;多样性门控与概率融合整合证据,不确定时由扩散策略继续接近观察。
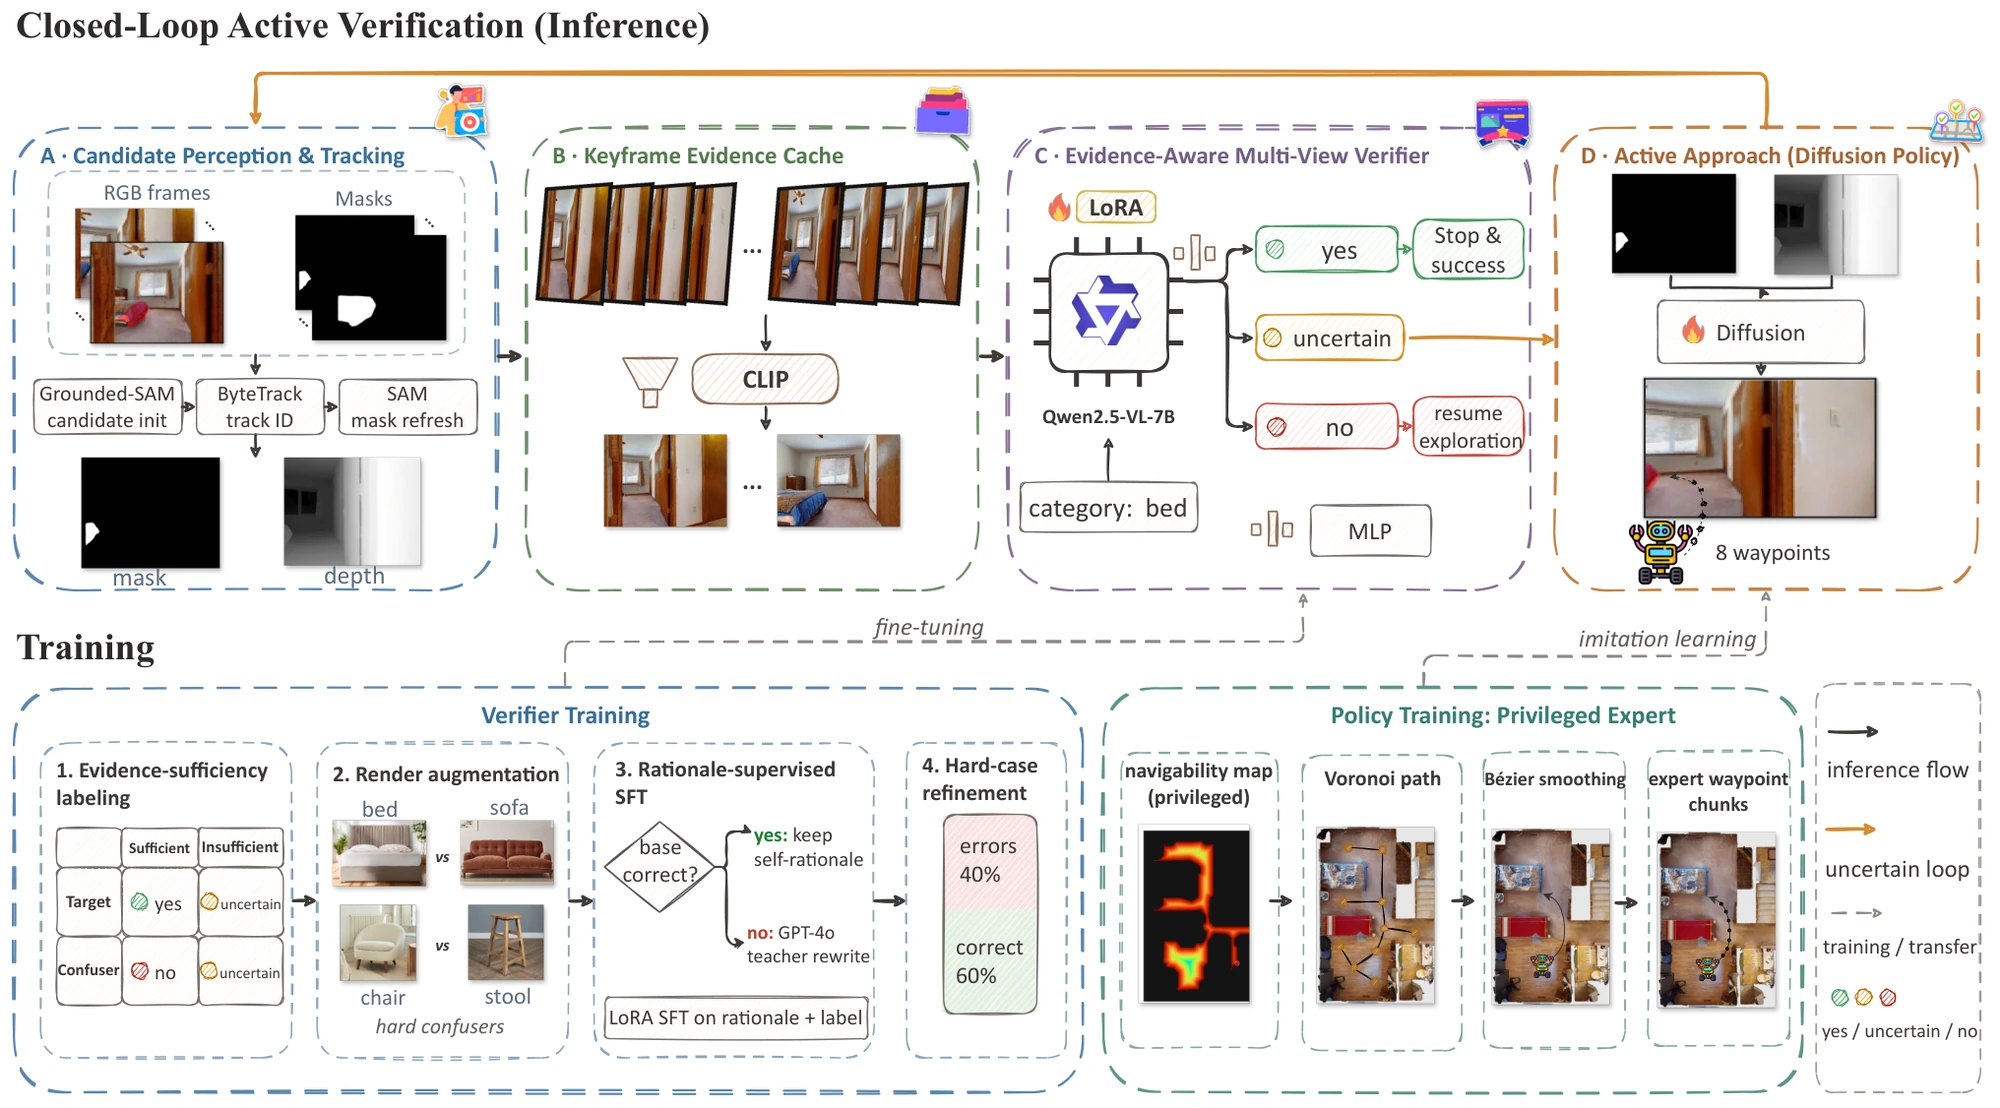
证据。 摘要报告上述两个场景集的平均 SR 提升 3.6 点、SPL 提升 2.0 点。
判断。 可作为现有 ObjectNav 的停止核验组件;底层导航器无需重训,但核验 VLM 需要微调。摘要未给真机结果,应检查额外观察距离、时延及误拒绝。
下一步。 复现:比较单帧停止、多视角被动融合与主动取证的错误停止率和 SPL。
3. PASS-VLN:同一条指令,应随机器人宽度改变执行结果
论文 · 主线:VLN · 局部语言导航 · PASS-VLN
问题。 默认指令可执行,会掩盖机器人本体尺寸造成的局部通行失败。
方法。 固定场景、指令、起点和参考路线,仅改变本体宽度;用深度局部 BEV 的障碍膨胀编码宽度,融合视觉语言信息,输出连续闭环执行的离散潜动作码。
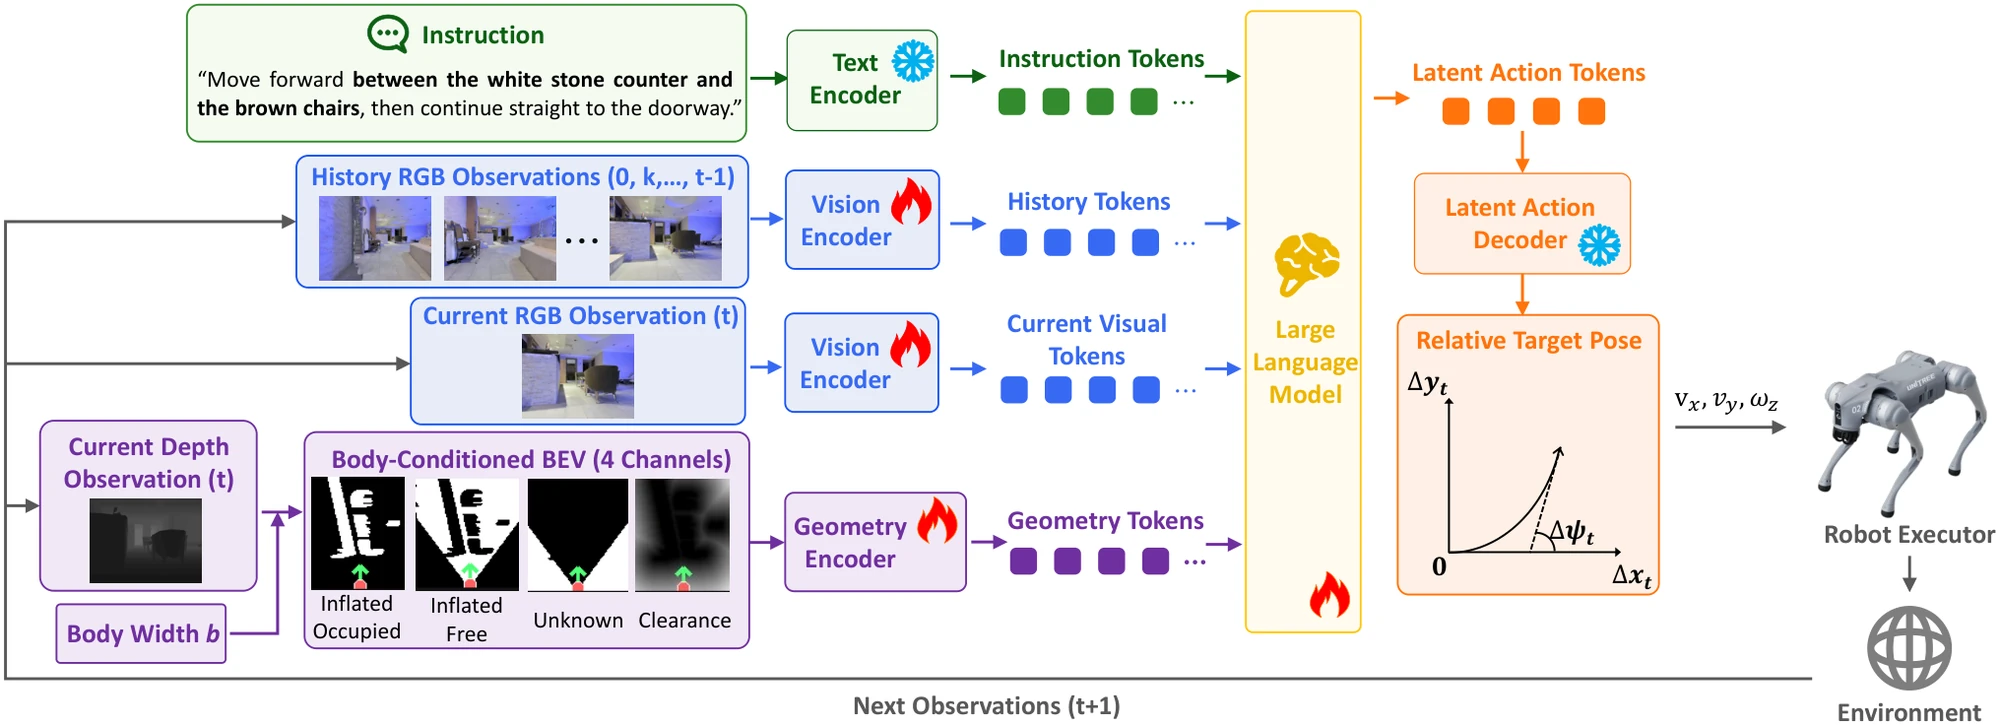
证据。 摘要报告 PASS-VLN 上无碰撞成功率比经同基准微调的强 VLN 模型高约 12 个百分点,并报告未见宽度泛化与真机部署。
判断。 适合拆开“路线理解错误”与“身体过不去”。局部命令任务不能替代长程 R2R-CE;摘要没有真机成功率。
下一步。 精读:核对不可通过样本的停下标准,并测试深度误差下的宽度边界。
4. VeSTA:让训练反馈与严格接触执行一致
论文 · 主线:VLN · 连续 VLN · 摘要写 R2R / RxR,未明确标为 CE
问题。 宽松碰撞模型可能允许物理上不可执行的动作完成导航。
方法。 轨迹级相对分组策略优化使用严格接触反馈,增加可执行候选的概率;可通行性风险评价器再按风险调整的效用选择候选未来。
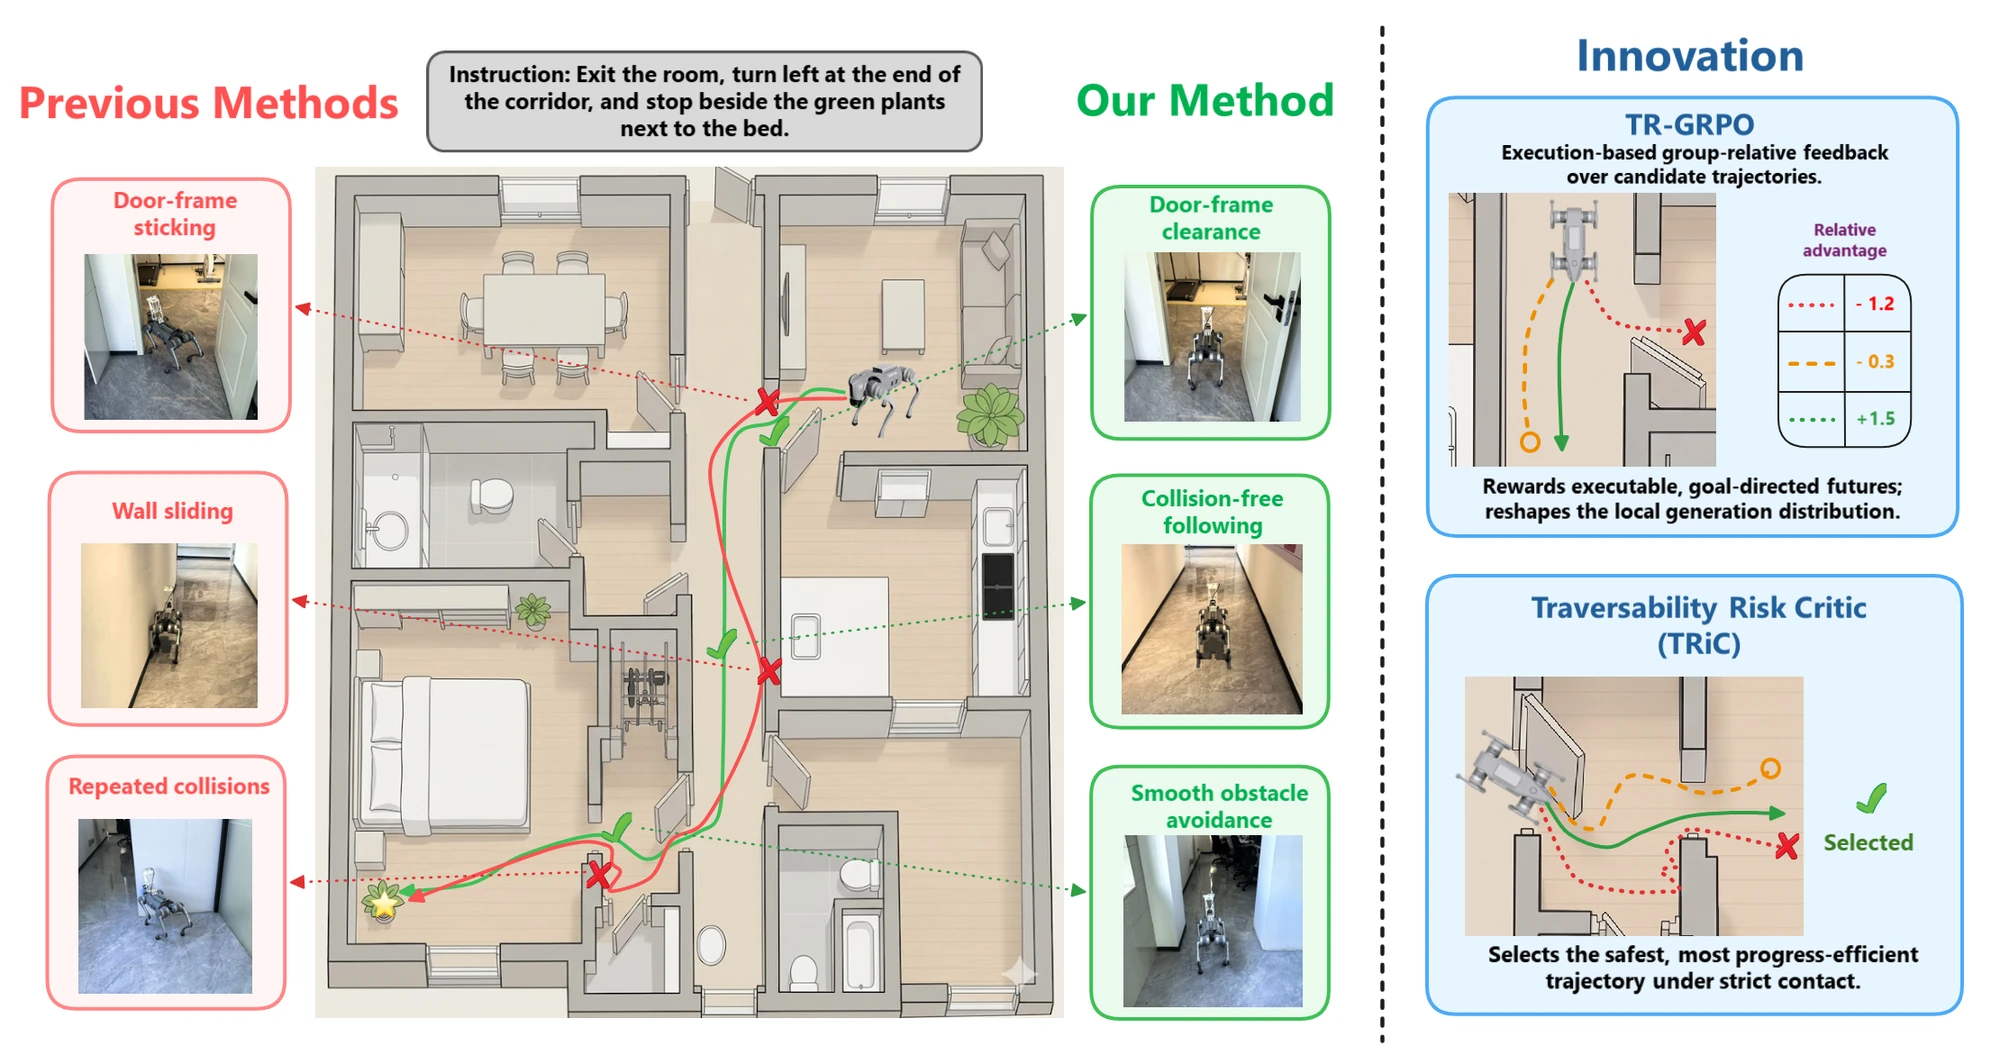
证据。 摘要无数值;论文称严格接触评测减少碰撞失败,并提供受控真机迁移实验。
判断。 值得核查“生成分布改善”和“候选筛选”各自贡献。这里研究连续执行,但摘要的 R2R / RxR 名称不足以确定 CE 版本,不能把结果当成离散基准或直接加入 CE 排名。
下一步。 精读:确认任务版本、碰撞实现和真机实验规模,再比较 SR 与碰撞率。
5. DialogMem:对话进入记忆后,还要绑定到可定位的对象
论文 · 主线:具身 Agentic 导航 · 对话记忆 · 实例级对象导航 / 问答
问题。 视觉记忆难以把人类对话持续关联到曾观察到的具体物体。
方法。 先从时间对齐的带位姿 RGB-D 与对话构建记忆,再检索用于对象导航和问答;统一比较记忆形成、检索与输出推理。
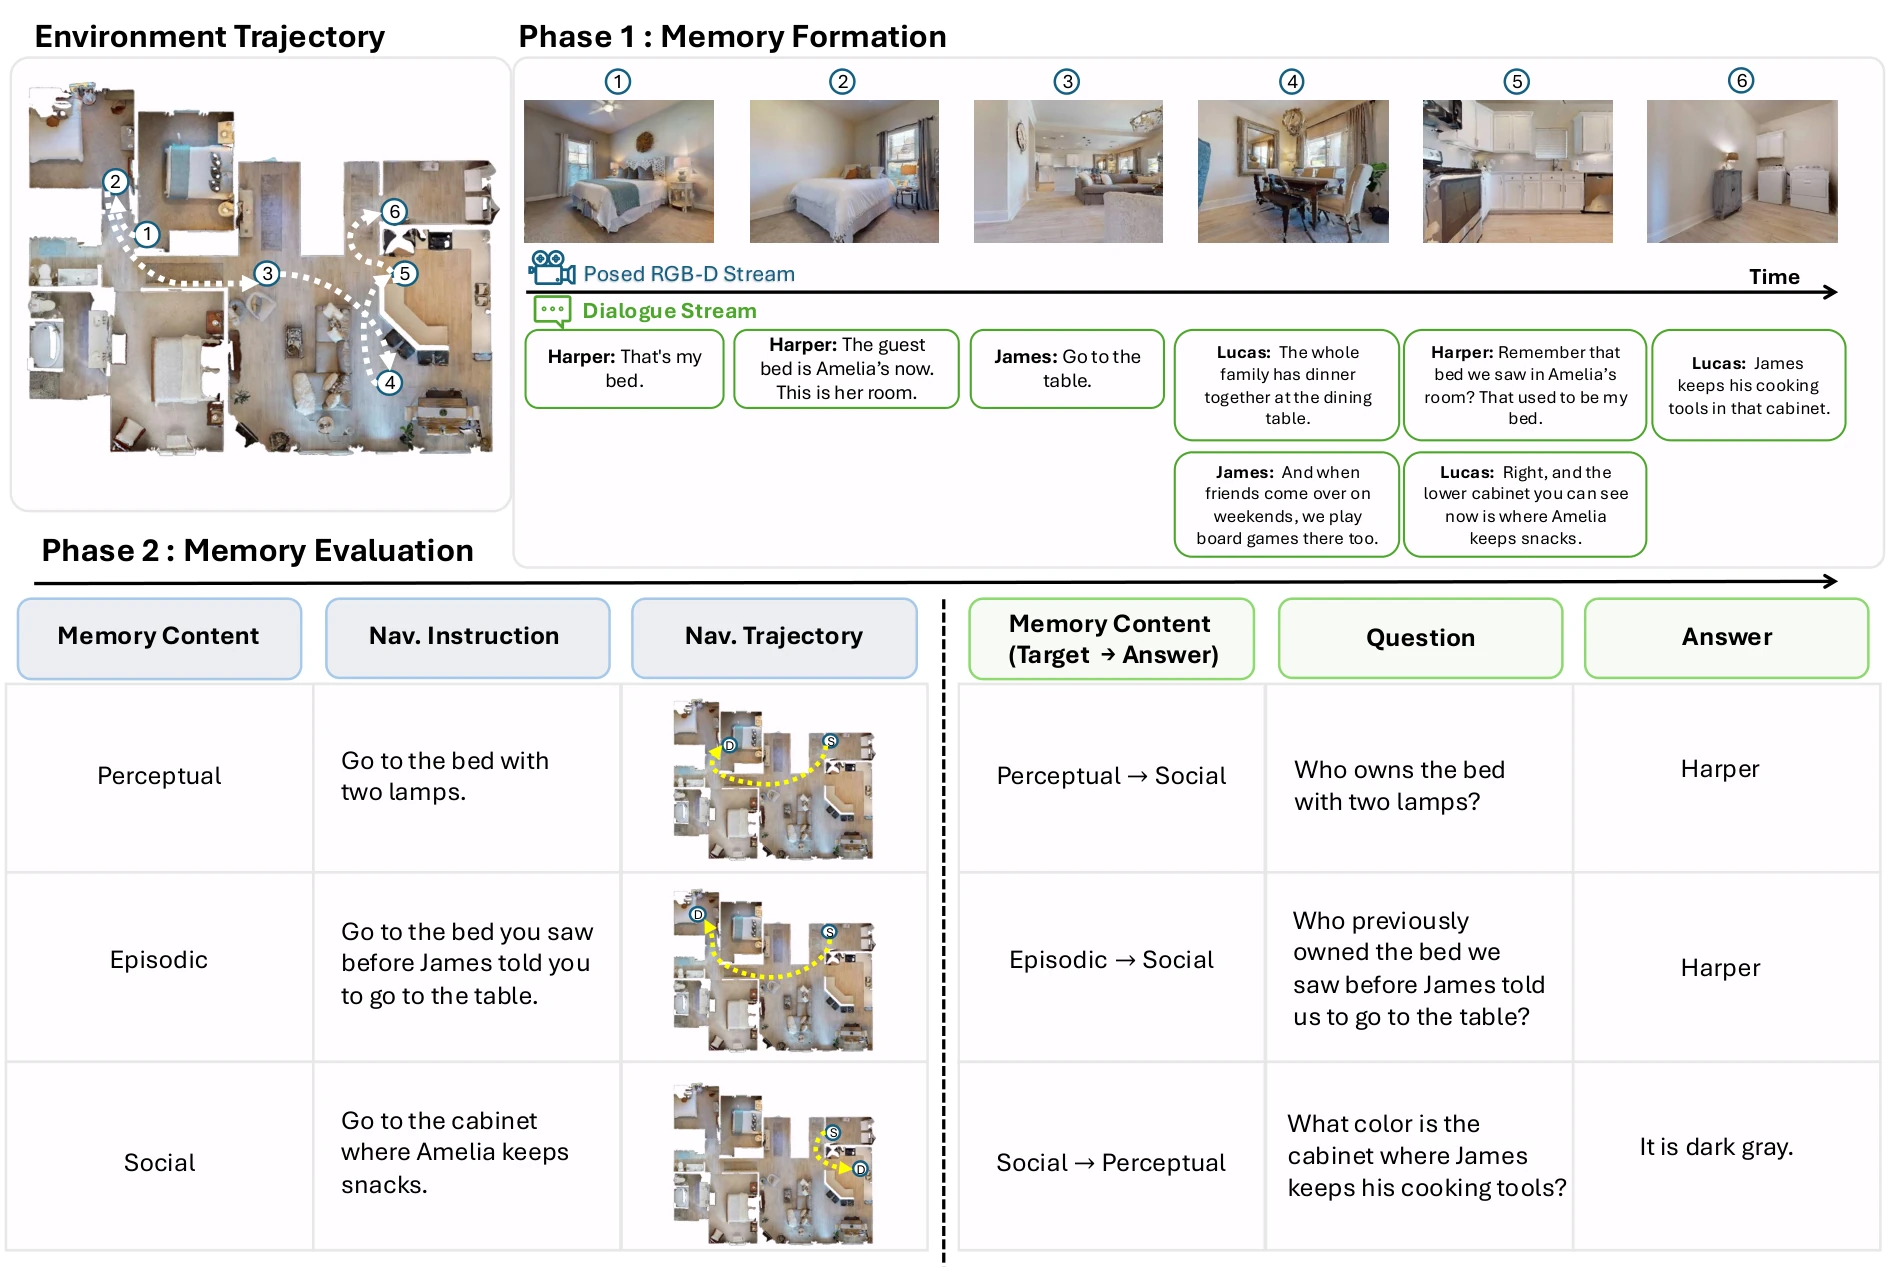
证据。 基准含 27 个真实场景的 142 个片段、14,193 对问答和 11,890 条导航指令;摘要未给导航 SR,仅报告追加对话的导航收益可忽略。
判断。 “记住了相关话语”与“找对对象并恢复位置”需要分别验证。真实场景数据不等于真机闭环部署,问答提升也不能充当导航提升。
下一步。 精读:按对象关联、检索、定位三阶段核对诊断实验,检查是否存在跨阶段误差累积。
三、也值得一看
- NavBind · R2R-CE / RxR-CE:3,252 个分叉上下文,固定历史检验指令与动作绑定。
- StopWatch · ObjectNav:显式目标定位与距离判断,并修正评测标注;摘要无数值。
- ReInsVLN · 记忆使用:压缩历史并定时提醒;摘要写 R2R,未注明连续或离散。
- HAVANA · 双速规划:慢速潜计划配合快速局部轨迹,推理时不生成未来视频。
- CovNav · ObjectNav:用校准后的不确定性选择何时启用慢推理。
- ChairNav · 真机轮椅:跨本体预训练、域内适配与用户干预后训练。
- EchoNav · 视觉导航:历史融合与置信占据补全,区分已观测自由空间。
- Sparse Topometric Graph · 跨会话导航:用局部几何和连通结构完成地图匹配。
- InstAgent · 协作系统:行为树表达分工与交接检查,保留经反馈修正的程序。
- Refinable Semantic Mapping · 动态记忆:逐点更新置信度,清理噪声与已经过时的对象点。
四、趋势与行动
趋势
- 导航评价正在拆分“到达、听指令、可执行”。 SimpleVLN、NavBind 与 VeSTA分别提供性能、语言依赖和物理执行证据;这些维度需要联合报告,不能以一个 SR 代替。
- 停止与交接逐渐成为独立闭环。 CLOSER、StopWatch 和 InstAgent 把目标确认或阶段完成证据显式化;有价值的比较是误停止、漏停止与额外执行成本。
- 记忆开始关注失效与定位,而非只保留更多历史。 DialogMem、Refinable Semantic Mapping 与 EchoNav 支持分别评测对象关联、证据更新和空间恢复。
研究空白
- 缺少把指令反事实、身体宽度、严格碰撞和停止核验放入同一地面 VLN 任务的统一评测;独立模块的收益是否能在长程执行中叠加仍待验证。
- 对话对象记忆在物体移动后是否还能支持真实机器人定位与安全停止,本期证据不足。
下一步
- 高 · 精读 SimpleVLN:确认连续基准划分、数据与训练成本,建立可比较基线。
- 高 · 复现 NavBind:在固定分叉状态成对替换指令,同时记录动作变化与方向正确性。
- 高 · 复现 CLOSER:保留导航器,评估目标核验对错误停止、成功率与路径成本的作用。
- 中 · 精读 PASS-VLN / VeSTA:梳理本体约束和严格接触的实现差异,设计对应消融。
- 中 · 跟踪 DialogMem:追踪对象关联与位置恢复接口,优先关注移动对象条件。
五、全部工作索引
A 为直接相关,B 为机制可迁移,C 为领域观察;以下五组覆盖本期全部 119 项独立工作。
VLN 与语义导航 · A · 14 篇
- ChairNav:轮椅跨本体适配与用户干预学习。
- HAVANA:异步潜计划与快速局部轨迹。
- PASS-VLN:见精读。
- SimpleVLN:见精读。
- StopWatch:显式目标定位与停止判断。
- EmbodiedWorld-200K:导航规划数据与世界模型交互训练。
- ReInsVLN:压缩并重新调用历史证据。
- VeSTA:见精读。
- CLOSER:见精读。
- CovNav:校准不确定性后选择慢推理。
- EchoNav:历史观测驱动置信占据补全。
- Navigation Explainability:结合障碍与未来轨迹解释辅助导航。
- NavBind:固定分叉状态检验语言动作依赖。
- FETA:查询关键动作的二元反馈再适配。
具身 Agentic 导航 · A · 5 篇
- InstAgent:行为树、共享记忆与协作交接。
- DialogMem:见精读。
- Structure over Reasoning:小模型只提供感知证据,结构化模块导航。
- DPGP:用发现概率图处理隐藏协作需求。
- TARSphere:动态物理与社会约束下的长程任务。
可迁移机制与 VLA / 操作 · B/C · 76 篇
- Cambrian-BEV:空间聚合视觉词元,压缩多帧历史。
- FOUND-IT System:把单目场景图接入移动操作系统。
- Robot Metareasoning:按状态调整计算与动作承诺时间。
- Offline Empowerment:从离线轨迹估计探索价值。
- GOFusion:占据与高斯子图融合,辅助主动观察。
- LateMatch:缓存图内上下文,延后跨图匹配。
- RCRA:按行人反应性调节保守导航策略。
- BetaMem:可追溯记忆写入、遗忘与局部规则修补。
- CoopUQ:联合占据预测与不确定性感知协同导航。
- ForagerSim:动态大场景中的地图推理评测。
- LVMem:把检索文本连回原始视觉证据。
- MEAN:面向具身任务闭环的网络系统综述。
- CAPSafe:分开评测情境动作安全与长程计划。
- Industrial COMPASS:数字孪生与合成增强的工业导航迁移。
- Externalise the Memory:固定策略下比较外部检索与权重蒸馏。
- VLA Corpus Selection:检验反事实诊断是否真的改善数据选择。
- PAPAV:按感知、预判、规划、行动、核验审视评测。
- Sparse Topometric Graph:以几何与连通结构匹配跨会话地图。
- CARE:用评价器和共享交接记忆切换云端执行。
- Refinable Semantic Mapping:逐点置信更新清除过时空间记忆。
- 数据、表征与训练(17):GRASP、ActiveAlign、Model-to-Policy、GazeAct、Relational Spatial Alignment、ALIGN、FR-VLA、Agricultural VLA、VLDA、PLaCA、Real2Sem2Real、Generative Plan Latents、AtomicRL、SimPT、DRILL、Sensorimotor Alignment、Tactile Manipulation Survey
- 记忆、监测与执行框架(14):RePlanMem-VLA、IMEP、VLA Memory Survey、RTPC、Runtime Safety Check、EventSync、FIT-MAC、JARVIS、RoboCasa-Shift、SERA、PAL、Echo、WholeBodyMem、Progress Probes P2
- 推理、压缩与持续适配(12):MambaAct、NestedVLA、FlashRT-PAI、SARAM、VLA-Rolling、PaceVLA、SPAR、PACT-VLA、Kernel-Variance Heads、FocusVLA、SmolVLA-MoE、One-Step Flow Policies
- 全身与多机械臂协作(5):CoEvolve、VLA-Fabric、HAF-VLA、Ropedia W0、SP-HLM
- 操作能力与鲁棒性基准(4):LIBERO-Pro2.0、BiDex-100、HandsOn、VLA-Retain
- 视觉任务重定向(1):TRACO
- 操作诊断与应用(3):RoboPhoto-VLA、Failure Attribution、FlowVLA
飞行、驾驶、控制与医疗 · C · 15 篇
虚拟世界、视觉与其他 · C · 9 篇
- 虚拟世界与游戏 Agent(4):Mirror、KPHarness、Scaling in Games、HiSTEVE 1.0
- 分割、视频物理与手部重建(3):UGA、PVBench、DewHand
- 导航视频生成(1):Map2Vid
- 移动 GUI(1):TAG-Nav