1. 引言
机器学习(Machine Learning, ML)研究如何从数据中学习规律,并将其用于未见过的样本。理解机器学习,不只是记住模型名称,更要回答三个问题:模型从什么信号中学习、依靠什么假设做预测、如何确认它能泛化到真实场景。
本文从学习范式与建模流程出发,依次介绍传统机器学习、深度神经网络、预训练模型和生成式模型。各类方法并非简单的替代关系:线性模型便于解释与诊断,树模型适合许多表格任务,深度网络擅长学习复杂表示;选择哪一种,需要结合数据、评价指标和部署成本。
阅读指南
适合读者:具备基础编程、线性代数与概率论知识,希望建立机器学习知识框架的学生、工程师与研究者。本文侧重经典原理和方法之间的联系,不作为最新模型排行榜。
| 阅读目标 | 建议章节 | 需要带走的问题 |
|---|---|---|
| 建立整体认识 | §2 基础概述 | 学习信号、模型假设、优化与泛化有什么区别? |
| 开始一个建模项目 | §2.9 实验流程 | 如何划分数据、避免泄漏并选择指标? |
| 处理表格和小样本数据 | §3.2–§3.11 传统方法 | 线性模型、树模型、距离方法各有什么前提? |
| 理解深度学习 | §3.12–§3.15 深度网络 | MLP、CNN、RNN、Transformer 的结构偏好有何不同? |
| 理解语言模型 | §3.16 预训练与对齐 | BERT、GPT、RLHF、DPO 分别解决什么问题? |
| 理解生成与机器人策略 | §3.17–§3.20 生成模型 | GAN、VAE、扩散与自回归如何建模分布? |
| 选择起步方案 | §4 选型与总结 | 如何建立基线,再判断是否需要复杂模型? |
阅读约定:每节先给出核心要点和直觉,再介绍机制、公式与适用边界。表中的建议是实验起点,不是算法性能保证。机器人方向可结合 §2.2.3 强化学习 与 §3.20.2 Diffusion Policy 阅读。
2. 机器学习基本概述
2.1 什么是机器学习?
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等。其核心思想是:让计算机通过算法解析数据、从中学习规律,并利用这些规律对真实世界中的未知事件做出预测和决策。模型通过训练调整参数;新增数据只有在质量、覆盖范围和训练方法合适时,才可能改善性能,模型不会仅因数据增加而自动变好。
2.2 学习范式与分类体系
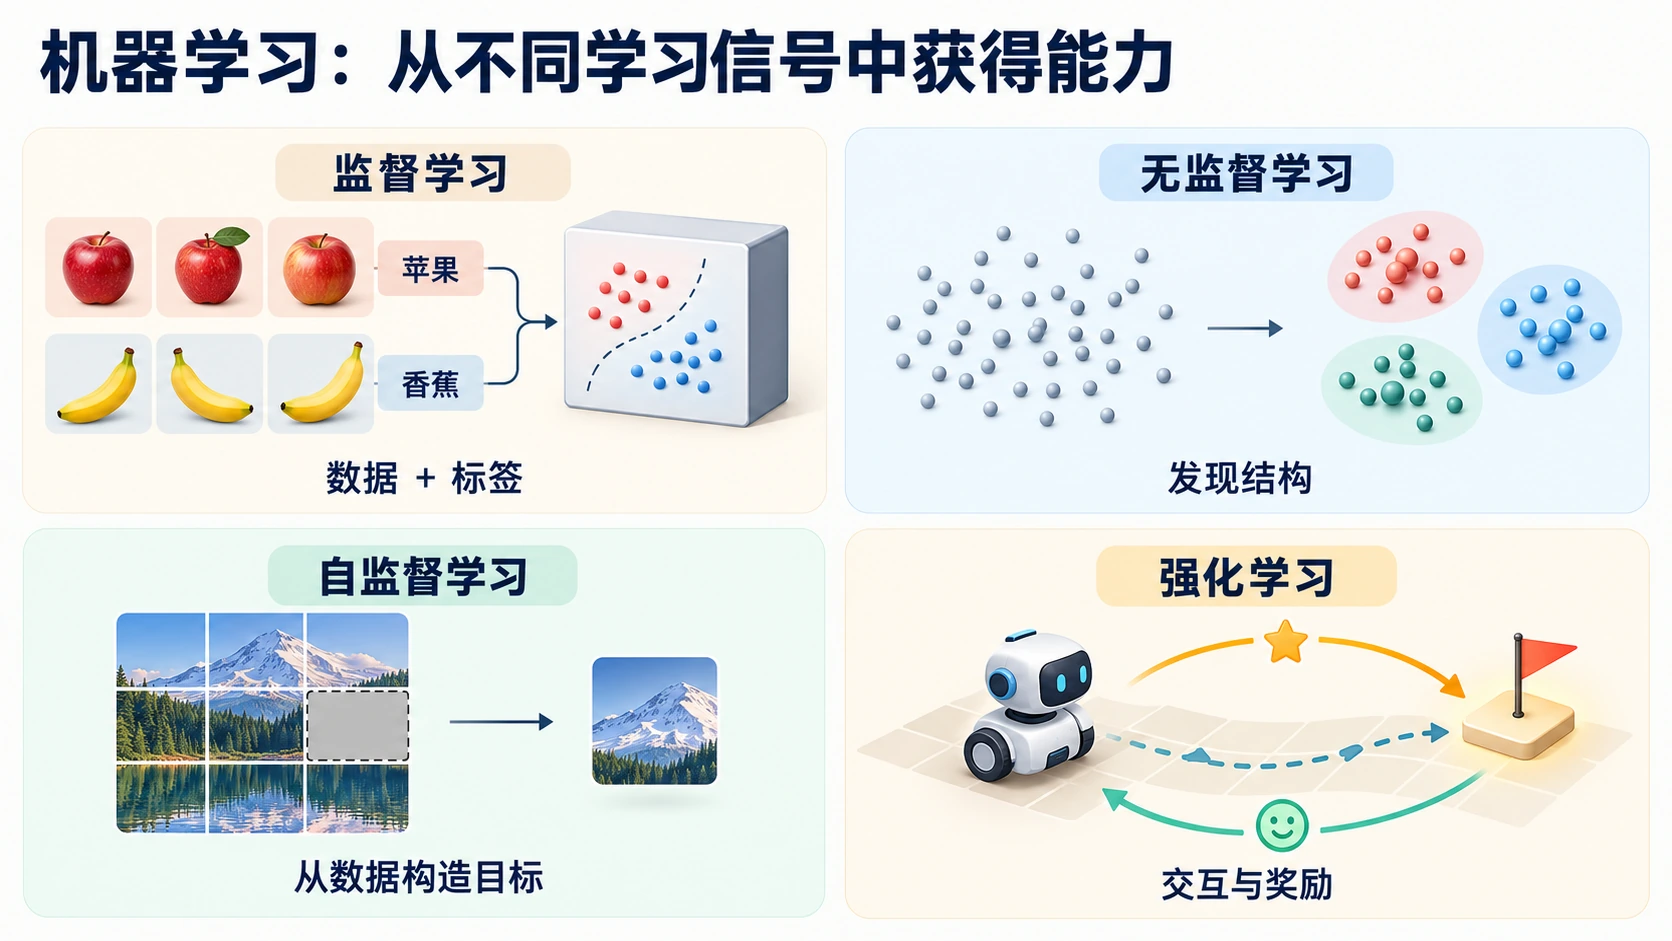
可以从监督信号的来源理解以下几类学习方式。它们并非完全互斥:同一个系统可以先做自监督预训练,再做监督微调,最后通过强化学习优化决策。深度学习描述的是模型与表示学习方式,并不与监督学习、强化学习处于同一分类维度。
2.2.1 监督学习 (Supervised Learning)
监督学习是最成熟、应用最广的范式。其训练数据由输入特征 $\mathbf{x}$ 和对应的标签(Ground Truth)$y$ 组成。模型的目标是学习一个映射函数 $f: \mathbf{x} \rightarrow y$。
-
核心任务:分类(Classification,标签为离散类别)与回归(Regression,标签为连续数值)。
-
代表算法:线性回归、逻辑回归、SVM、决策树、多数深度神经网络。
2.2.2 无监督学习 (Unsupervised Learning)
无监督学习的数据没有标签,模型需要自主发掘数据内部的潜在结构、模式或分布。
-
核心任务:聚类(Clustering)、降维(Dimensionality Reduction)、异常检测(Anomaly Detection)。
-
代表算法:K-Means、PCA、自编码器(Autoencoder)、高斯混合模型(GMM)。
2.2.3 强化学习 (Reinforcement Learning)
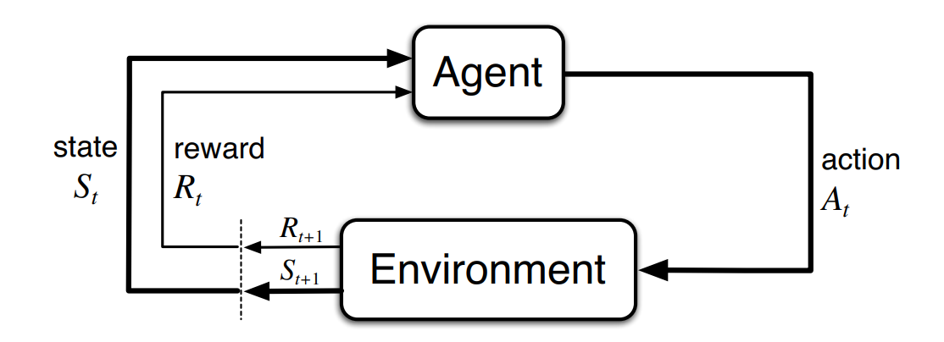
强化学习侧重于智能体(Agent)如何在环境(Environment)中采取动作(Action),以最大化累积奖励(Reward)。它以奖励作为反馈,奖励可以即时给出,也可以延迟出现;训练既可来自在线交互,也可利用已有交互数据进行离线学习。
-
核心概念:状态(State)、动作(Action)、奖励(Reward)、策略(Policy)、价值函数(Value Function)。
-
代表算法:Q-Learning、DQN、PPO、SAC。
2.2.4 半监督与自监督学习 (Semi/Self-Supervised Learning)
-
半监督学习:利用少量有标签数据和大量无标签数据进行训练,降低标注成本。
-
自监督学习:从数据自身构造监督信号(如预测下一个词或恢复被遮挡的图像区域),是现代语言模型和许多视觉预训练模型的重要训练方式。
2.3 核心要素与系统架构
一个典型的机器学习流程通常包括以下五个核心要素:
-
数据 (Data):模型学习的基础资源,质量、覆盖范围与标注可靠性直接影响上限;通常还包括数据清洗与预处理。
-
特征工程 (Feature Engineering):将原始数据转化为模型可理解的特征向量,传统 ML 强依赖于此。
-
模型假设 (Hypothesis Space):规定模型能够表达的函数集合,例如线性组合、树模型划分或神经网络表示。
-
目标函数 (Objective Function):定义”好”与”坏”的度量标准,通常由损失函数(Loss Function)和正则化项(Regularization)组成。
-
优化算法 (Optimization Algorithm):求解目标函数最小化(或最大化)参数的策略,如梯度下降(Gradient Descent)、Adam 等。
2.4 发展历程
以下列出若干代表性节点。符号推理与机器学习长期并行发展,传统方法也没有因深度学习兴起而失去价值。
| 时期 | 代表性节点 | 方法上的变化 |
|---|---|---|
| 1950–1980 年代 | 感知机、专家系统、反向传播研究 | 从人工规则到可训练的参数模型,多条路线并行探索 |
| 1990–2000 年代 | SVM、随机森林、梯度提升 | 强调统计泛化、核方法与集成学习 |
| 2010–2016 年 | AlexNet、ResNet、DQN、AlphaGo | 多层表示学习结合大规模数据与计算资源 |
| 2017–2020 年 | Transformer、BERT、GPT-3、DDPM | 自注意力、预训练迁移与去噪生成发展 |
| 2020 年代 | 多模态基础模型、生成式策略、偏好优化 | 研究跨任务迁移、生成能力、对齐与部署效率 |
发展主线是表示、目标函数、数据与计算资源的协同变化,而不是所有任务都应换成最新架构。
2.5 主要挑战
尽管成果丰硕,机器学习在实际落地中仍面临诸多挑战:
-
过拟合与分布外泛化:模型在训练集上表现良好,但在未见过的数据或分布变化后可能失效。
-
数据质量与数据泄漏:噪声、偏差、重复样本以及训练集与测试集之间的信息泄漏,都会导致评测结果失真。
-
高维与计算成本:高维特征会带来样本稀疏和计算开销;大模型训练与推理还需要大量 GPU/TPU 资源。
-
可解释性与公平性:复杂模型的决策依据难以追溯,数据偏差还可能放大不同群体之间的不公平。
-
评测与安全:离线指标未必代表真实使用效果,可靠性、隐私、鲁棒性和对齐仍需持续验证。
2.6 关键技术方向与未来展望
机器学习在方法论和应用前沿上持续演进,以下方向分别关注表示、迁移、适应与可靠性,不能视为已经解决的问题:
-
表示学习 (Representation Learning):自动学习数据的有效特征表示,减少手工特征设计,但仍需要合适的数据处理、输入表示和任务设计。
-
迁移学习 (Transfer Learning):将一个领域/任务学到的知识迁移到另一个相关领域/任务,极大缓解了数据稀缺问题。
-
元学习 (Meta-Learning):也称”学会学习”,旨在让模型具备快速适应新任务的能力(如 Few-shot Learning)。
-
跨任务泛化:研究模型能否迁移到新任务、新环境与新分布。通用人工智能(AGI)是更长期的研究目标,不能由单一基准分数推断是否实现。
-
可信与对齐 AI (Trustworthy & Aligned AI):确保 AI 系统的目标与人类价值观一致,具备安全性、公平性和透明度。
-
AI for Science:利用机器学习解决物理、化学、生物(如 AlphaFold)等基础科学领域的复杂计算问题。
2.7 主流应用场景
机器学习目前已经深度渗透到数字世界与物理世界的方方面面:
2.7.1 计算机视觉 (CV)
-
核心任务:图像分类、目标检测(如 YOLO 系列)、语义分割、图像生成。
-
应用:人脸识别、医学影像分析、工业缺陷检测。
2.7.2 自然语言处理 (NLP)
-
核心任务:机器翻译、文本摘要、情感分析、对话系统。
-
应用:ChatGPT 等智能助手、智能客服、文档自动审核。
2.7.3 推荐系统与计算广告
- 互联网巨头的变现核心。通过协同过滤(Collaborative Filtering)、深度交叉网络等技术,挖掘用户历史行为与物品之间的匹配概率,实现精准推送。
2.7.4 机器人、自动驾驶与具身智能 (Embodied AI)
- 结合强化学习、视觉与大语言模型,让机器人在复杂的物理环境中实现感知、规划、导航与灵巧操作。此类任务还要考虑观测噪声、动作延迟、物理约束和闭环执行中的分布变化。
2.8 主流数据集、评测基准与框架
2.8.1 经典数据集与基准
| 数据集 | 领域 | 特点与历史意义 |
|---|---|---|
| ImageNet | CV (分类) | 完整数据集与 ILSVRC 子集需区分;常见 ImageNet-1K 指约 128 万张训练图像、1,000 类的分类设置。 |
| COCO | CV (检测分割) | 微软发布,具有丰富的多目标、多上下文的复杂场景标注。 |
| MNIST | CV (入门) | 手写数字识别集,被誉为机器学习领域的 “Hello World”。 |
| GLUE | NLP | 评估自然语言理解模型的综合基准,推动了 BERT 时代的发展。 |
2.8.2 主流工具与开源框架
-
Scikit-learn:Python 下的传统机器学习库,提供线性模型、树模型、SVM、聚类、预处理和模型评估等统一接口。
-
XGBoost / LightGBM:常用于表格数据的梯度提升树框架,具体速度与精度需要在任务上比较。
-
TensorFlow:Google 开源的深度学习框架,工业界部署生态完善。
-
PyTorch:Meta 开源的深度学习框架,因动态图机制和易用性被广泛用于研究与大模型训练,并拥有成熟的部署生态。
-
Hugging Face:提供模型与数据集托管,以及
transformers等工具库;使用预训练权重时需核对模型卡中的训练用途、许可和限制。
2.9 从数据到可靠结论:建模与评估流程
知道算法名称还不够。一次可复现的建模实验,需要先定义任务和验证方式,再优化模型。
2.9.1 区分拟合、优化与泛化
以监督学习为例,给定 $n$ 个训练样本,常见目标是最小化经验风险与正则项:
\[\hat{\theta} = \arg\min_{\theta}\left[\frac{1}{n}\sum_{i=1}^{n}\ell(f_{\theta}(\mathbf{x}_i),y_i)+\lambda\Omega(\theta)\right]\]其中 $f_\theta$ 是模型,$\ell$ 衡量预测误差,$\Omega$ 约束模型复杂度,$\lambda$ 控制约束强度。优化关注训练目标能否降低,泛化关注未见样本上的表现;训练损失低不等于模型可靠。
参数(如线性权重)由训练过程学习;超参数(如树深、正则强度、学习率)通常用验证集选择。训练和验证误差都高,可能是欠拟合、特征不足或优化未完成;训练误差低而验证误差高,则应排查过拟合与分布差异。
2.9.2 先划分数据,再学习预处理参数
- 明确预测时点与目标:输入只能包含实际预测时可获得的信息。例如预测用户是否流失,不能把流失之后产生的字段作为特征。
- 保留测试集:训练集用于拟合,验证集用于调参和选阈值,测试集用于方案确定后的最终评估。反复依据测试结果改模型,会让测试集失去独立性。
- 匹配部署场景划分:近似独立同分布的分类样本可分层随机划分;时间序列按时间先后划分;同一用户、设备或机器人轨迹的相关样本应按组划分,避免跨集合泄漏。
- 只在训练集拟合预处理:标准化、缺失值填补、特征选择和 PCA 都需先在训练集拟合,再应用到验证与测试集。交叉验证时,每一折都要重新拟合,可用
Pipeline管理。 - 记录可复现条件:保存数据版本、划分、随机种子、超参数与评价脚本;小样本或高方差任务应报告多折或多次运行结果。
交叉验证主要用于开发阶段的模型选择,不意味着可以忽略时间和分组结构。若还要用交叉验证估计调参后方案的泛化表现,可采用嵌套交叉验证。参见 scikit-learn 数据泄漏指南与交叉验证文档。
2.9.3 指标必须对应任务代价
| 任务 | 常用指标 | 解读要点 |
|---|---|---|
| 回归 | MAE、RMSE、$R^2$ | RMSE 对大误差更敏感;$R^2$ 可为负,不能跨不同数据集直接排名 |
| 分类 | Precision、Recall、F1、混淆矩阵 | 先明确正类、阈值和漏报/误报代价;类别不平衡时不能只看 Accuracy |
| 分类排序 | ROC-AUC、PR 曲线、Average Precision(AP) | ROC-AUC 衡量排序;正类稀少时还应看 PR/AP,AP 与梯形积分 PR-AUC 不完全相同 |
| 概率预测 | Log loss、Brier score、校准曲线 | 能正确排序,不代表输出的“80% 概率”与实际频率一致 |
| 聚类 | 轮廓系数、稳定性、领域检验 | 内部几何指标不保证簇对应真实业务或语义类别 |
| 生成与机器人控制 | 分布指标、人工评价、成功率、时延 | 图像逼真不等于事实正确;离线动作误差低不等于闭环任务成功 |
例如正类只占 1% 时,全部预测为负类就有 99% 的 Accuracy,但正类 Recall 为 0。应依据实际代价在验证集上选择阈值,而非默认 0.5。指标定义见 scikit-learn 评估文档。
2.9.4 用基线和误差分析决定下一步
先建立多数类、均值预测等朴素基线,再比较线性模型、树模型或预训练表示。若复杂模型的提升很小,应同时报告推理时延、内存与维护成本。检查模型在哪些类别、时间段或人群上失败,再决定补数据、改特征、调目标还是换架构。
上线后继续监测输入分布、预测质量和反馈延迟。离线测试只说明模型在特定数据与评估协议下的表现,不能替代部署后的检验。
3. 经典算法与代表性模型
本章按模型结构和用途组织内容。同一方法可能跨多个类别,例如 Transformer 可用于监督分类、自监督预训练或生成建模;AE 主要学习表示,并不自动定义可采样的生成分布。
3.1 核心算法分类概览
在深入探讨具体模型之前,下表梳理了机器学习中经典的算法分类及其代表性模型:
| 类别 | 代表性模型 / 技术 | 主要特点 | 应用场景 |
|---|---|---|---|
| 线性模型 | 线性回归、逻辑回归 | 简单易懂、计算量小、可解释性强 | 房价预测、点击率预估 (CTR) |
| 集成学习 | 随机森林、XGBoost、LightGBM | 鲁棒性强、处理表格数据效果极佳 | 金融风控、搜索排序 |
| 传统统计/概率 | SVM、KNN、朴素贝叶斯、HMM | 理论严谨、适合小样本任务 | 文本分类、语音识别、生物信息 |
| 聚类与降维 | K-Means、PCA、t-SNE | 无监督、发现数据潜在结构 | 用户画像、数据压缩、可视化 |
| 深度神经网络 | CNN、RNN、LSTM、MLP | 强大的非线性拟合与特征提取能力 | 图像识别、自然语言处理 |
| 大模型基石 | Transformer、BERT、GPT | 擅长建模长距离依赖,支持大规模预训练 | 文本生成、问答、多模态理解 |
| 生成式模型 | GAN、VAE、Diffusion Models | 学习数据分布、生成高质量新样本 | AI 绘画、视频生成、分子设计 |
Part A · 传统机器学习(§3.2 – §3.11) —— 从线性假设、树划分、局部距离到概率建模;可解释性和计算代价因方法而异。
3.2 线性回归与正则化
核心要点:一条直线/超平面拟合数据;L2 正则(Ridge)防过拟合、L1 正则(Lasso)自带特征选择。
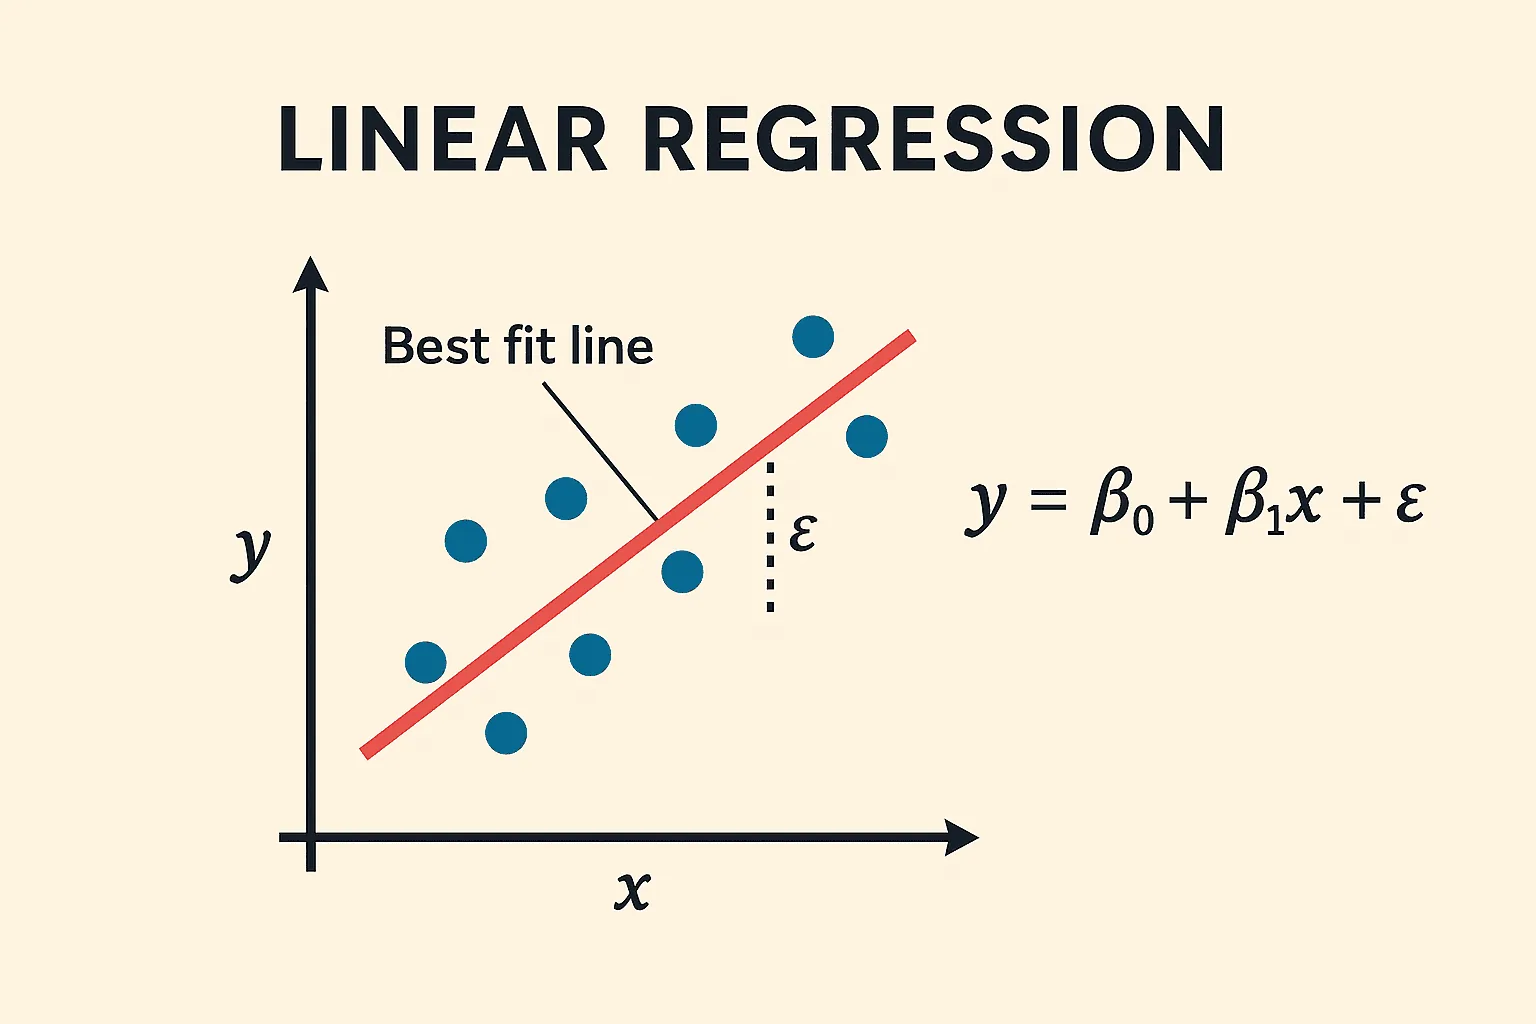
线性回归 (Linear Regression) 是回归分析中最基础的模型,假设目标变量与特征之间存在线性关系。其目标函数通常是最小化均方误差(MSE)。
直觉理解:就像在散点图上画一条”最佳拟合线”——目标是找到那根让所有点在目标变量方向上的残差平方和最小的直线。正则化则相当于在”拟合好”的基础上再加一条约束:别让权重长得太大。
-
数学表达式:$y = \mathbf{w}^T \mathbf{x} + b$
其中 $\mathbf{w}$ 是各特征的权重向量(系数大小受特征尺度和相关性影响,不能直接当作重要性或因果效应),$\mathbf{x}$ 是输入特征向量,$b$ 是偏置(截距)。整个公式就是”加权求和再加个基准”。
-
优化方法:可以通过最小二乘法直接求解闭式解(正规方程),也可以使用梯度下降法进行迭代优化。
-
正则化 (Regularization):为了防止在特征维度较高时发生过拟合,常在损失函数中引入正则化惩罚项:
-
Ridge 回归(L2 正则化):增加 $\lambda |\mathbf{w}|_2^2$ 项,限制参数的平方和,收缩系数,缓解多重共线性造成的估计不稳定;正则化前通常需要统一特征尺度。
-
Lasso 回归(L1 正则化):增加 $\lambda |\mathbf{w}|_1$ 项,限制参数的绝对值和。L1 正则化的几何特性使其容易产生稀疏解(即将部分权重压缩为0),因此自带特征选择功能。
-
| 可优先尝试 | 需要注意 |
|---|---|
| 特征与目标变量呈线性关系 | 特征与目标存在复杂非线性关系 |
| 需要可解释性强的模型 | 数据中有大量异常值 |
| 特征较少、样本充足 | 特征间存在强多重共线性(此时用 Ridge) |
3.3 逻辑回归 (Logistic Regression)
核心要点:对数几率是特征的线性函数,经 Sigmoid 输出二分类概率;它使用分类损失训练,并非先拟合一次线性回归。
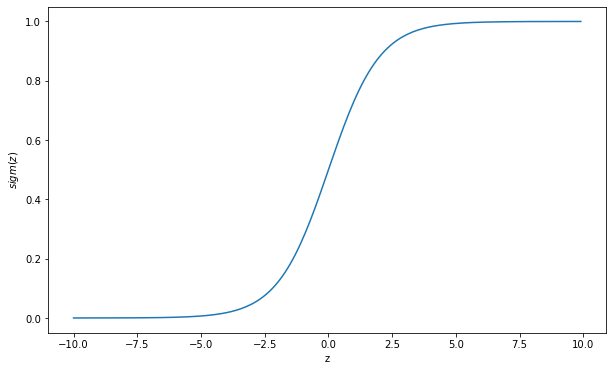
虽然名为“回归”,但逻辑回归主要用于分类;这里介绍二分类形式,多分类可使用多项逻辑回归。它在线性回归的基础上,引入了非线性的 Sigmoid 激活函数,将连续的线性输出映射到 $(0, 1)$ 区间,从而赋予其概率意义。
直觉理解:逻辑回归是在线性回归外面套了一个”挤压器”——把任意实数得分挤压到 0 到 1 之间,然后把这个值直接当作”属于正类的概率”。得分越高,概率越接近 1;得分越低,概率越接近 0。
- 核心函数:
其中 $\mathbf{w}^T \mathbf{x} + b$ 是线性”原始得分”,$\sigma(\cdot)$ 是 Sigmoid 函数(那个”挤压器”)。得分为 0 时输出 0.5,得分越大越接近 1,越小越接近 0。
-
损失函数:交叉熵损失(Cross-Entropy Loss),通过最大似然估计推导而来。
-
特点:计算代价低,速度快,输出具有明确的概率解释,常用于金融风控中的信用评分卡、广告点击率(CTR)预估等基础场景。
| 可优先尝试 | 需要注意 |
|---|---|
| 二分类任务、需要概率输出 | 特征之间存在强非线性关系 |
| 稀疏文本特征、需要快速分类基线 | 原始图像等复杂输入通常需要先提取合适的表示 |
3.4 决策树 (Decision Tree)
核心要点:由一连串 if-then 规则递归划分数据,天然可解释;但单树方差大、易过拟合,需剪枝或集成。
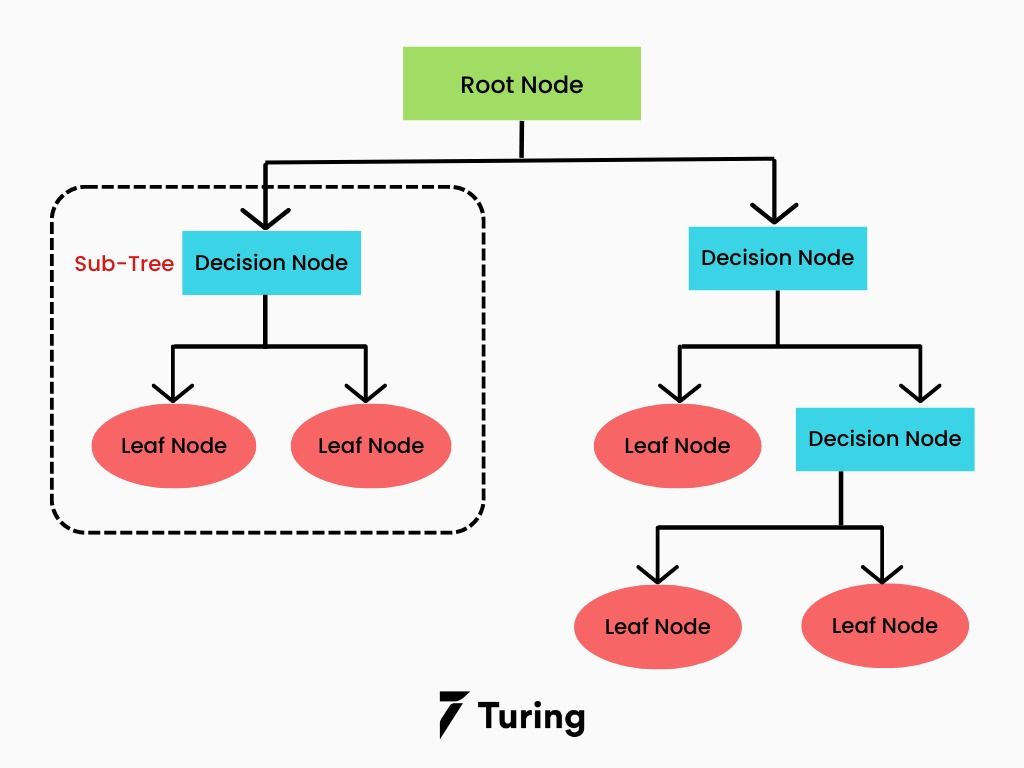
决策树模仿人类基于规则判断的思维过程,通过树状结构对数据进行分类或回归。每个内部节点表示对某一特征的条件判断,分支代表判断结果,叶节点表示最终预测的类别或数值。
直觉理解:就像小时候玩的”猜人游戏”——”这个水果是红色的吗?→ 是 → 圆的吗?→ 是 → 苹果!”每个分叉点都问一个最能区分当前数据的问题,层层缩小范围,最终做出判断。
-
分裂准则:
-
ID3 算法:基于信息增益(Information Gain)选择特征,倾向于选择取值较多的特征。
-
C4.5 算法:基于信息增益率(Gain Ratio)进行改进,缓解信息增益偏好高基数特征的问题。
-
CART 算法:分类树使用基尼指数(Gini Impurity),回归树使用平方误差。CART 是一棵二叉树,是许多集成树模型的基础。
-
-
优缺点:浅树便于解释,通常不需要标准化;缺失值和类别特征支持取决于具体实现,不能由“决策树”这个名称推断。深树容易过拟合,可通过最大深度、叶节点最小样本数和剪枝控制复杂度。
| 可优先尝试 | 需要注意 |
|---|---|
| 需要清晰规则和较浅的决策路径 | 树过深、叶节点样本过少时容易过拟合 |
| 非线性表格数据,通常无需标准化 | 类别特征可能需要编码;高精度任务可与集成方法比较 |
3.5 随机森林 (Random Forest)
核心要点:Bagging 并行集成多棵分别训练的决策树,投票/平均输出;降低方差、抗噪强、可评估特征重要性。
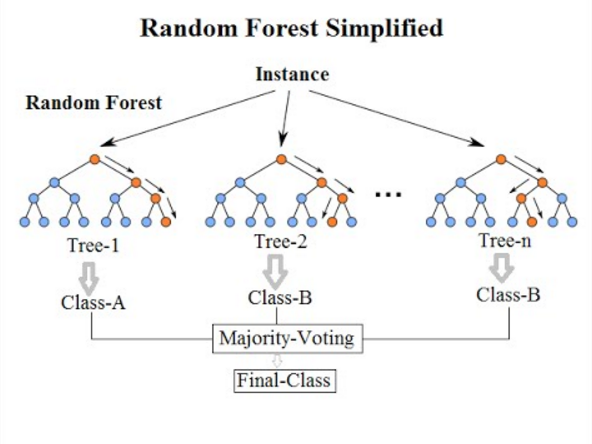
Bagging(Bootstrap Aggregating) 是一种并行的集成学习范式,通过对数据进行有放回采样并训练多个基学习器,再聚合它们的结果以降低方差。随机森林是 Bagging 的代表方法。
直觉理解:相当于组建一个”专家委员会”——每位专家(决策树)只看部分数据和部分特征,各自做出判断,最后投票决定。单个专家可能偏颇,但集体的平均意见往往更准确、更稳健。
-
核心机制:通过对训练样本进行有放回的随机采样(Bootstrap),构建多棵分别训练的决策树;它们的预测仍可能相关。同时,在每个节点分裂时,也只在随机子集的特征中选择最优划分特征。
-
结果输出:分类任务通过多棵树投票产生最终结果,回归任务则取平均值。
-
特点:通过降低树之间的相关性来减少集成预测的方差,但仍可能过拟合。基于节点纯度的特征重要性可能偏向高基数特征,可结合验证集置换重要性分析;两者都不代表因果关系。
| 可优先尝试 | 需要注意 |
|---|---|
| 结构化/表格数据,不想调太多参数 | 超高维稀疏数据(如文本 TF-IDF) |
| 非线性特征交互、需要稳健起步方案 | 缺失值支持依实现而定;与 Boosting 的优劣需验证 |
3.6 梯度提升树
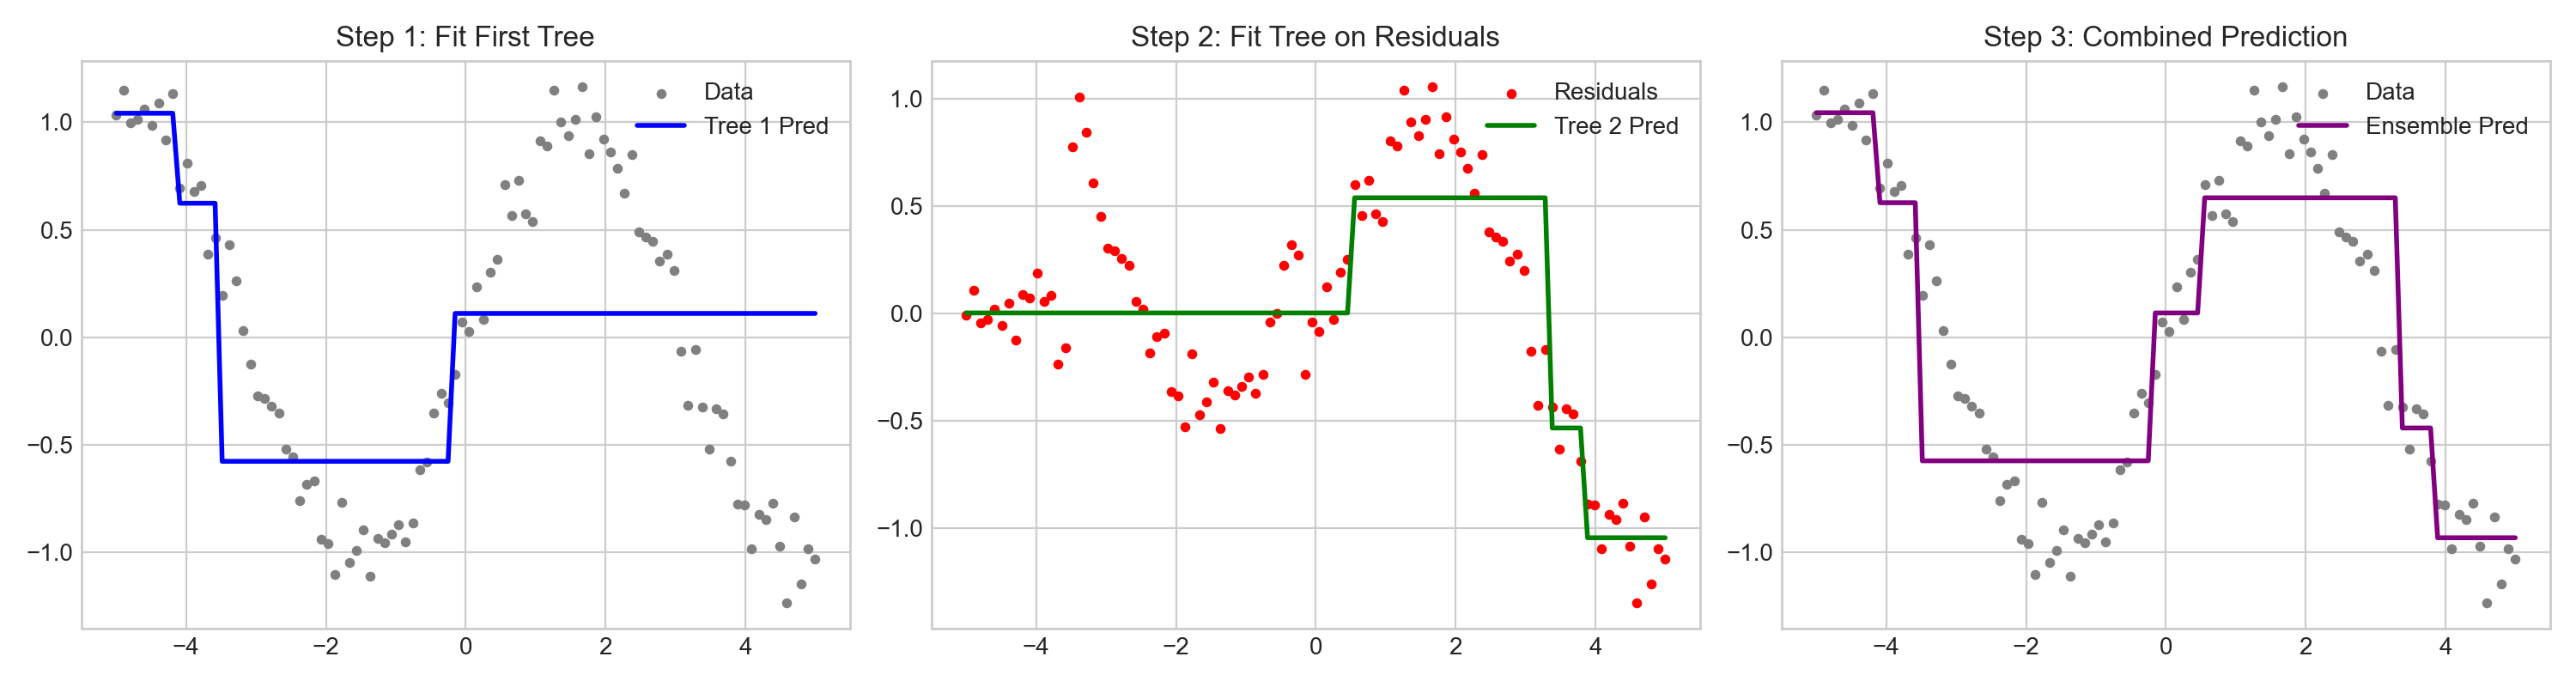
核心要点:梯度提升逐轮拟合当前集成模型的负梯度;平方损失下等价于拟合残差。XGBoost、LightGBM 提供高效的实现。
Boosting 是一种串行的集成学习范式,核心思想是”不断纠错”。后续的模型重点关注前序模型预测错误的样本,将其加权累积。
直觉理解:就像学生做错题集——第一轮做完后,第二轮重点练上次做错的题,第三轮再练上次还错的……每一轮专注于弥补前一轮的弱点,最终形成一个各方面都强的模型。
-
GBDT (Gradient Boosting Decision Tree):以回归树为基学习器(包括用于分类任务时),每次迭代通过拟合上一步模型的负梯度(在平方损失下即为残差)来不断逼近真实值。
-
XGBoost (eXtreme Gradient Boosting):一种使用正则化目标与高效树构建方法的梯度提升框架。它不仅在目标函数中引入了二阶导数信息(泰勒展开)以加速收敛,还加入了 L1 和 L2 正则化项以控制模型复杂度。此外,支持缺失值自动处理和特征并行计算,曾长期作为 Kaggle 表格数据竞赛中的强基线。
-
LightGBM:微软推出的更高效的 Boosting 框架。通过引入基于直方图(Histogram)的决策树算法、单边梯度采样(GOSS)和互斥特征捆绑(EFB),改善部分任务中的训练效率;是否启用这些技术及其效果取决于配置与数据。
| 可优先尝试 | 需要注意 |
|---|---|
| 结构化表格数据、追求精度 | 图像/文本等非结构化数据 |
| 数据含缺失值(XGBoost 自动处理) | 训练样本极少,易过拟合 |
3.7 K近邻算法 (KNN)
核心要点:懒惰学习——不训练只记忆,预测时靠最近 K 个邻居投票/平均;简单直观但推理慢、对尺度敏感、受维度灾难影响。
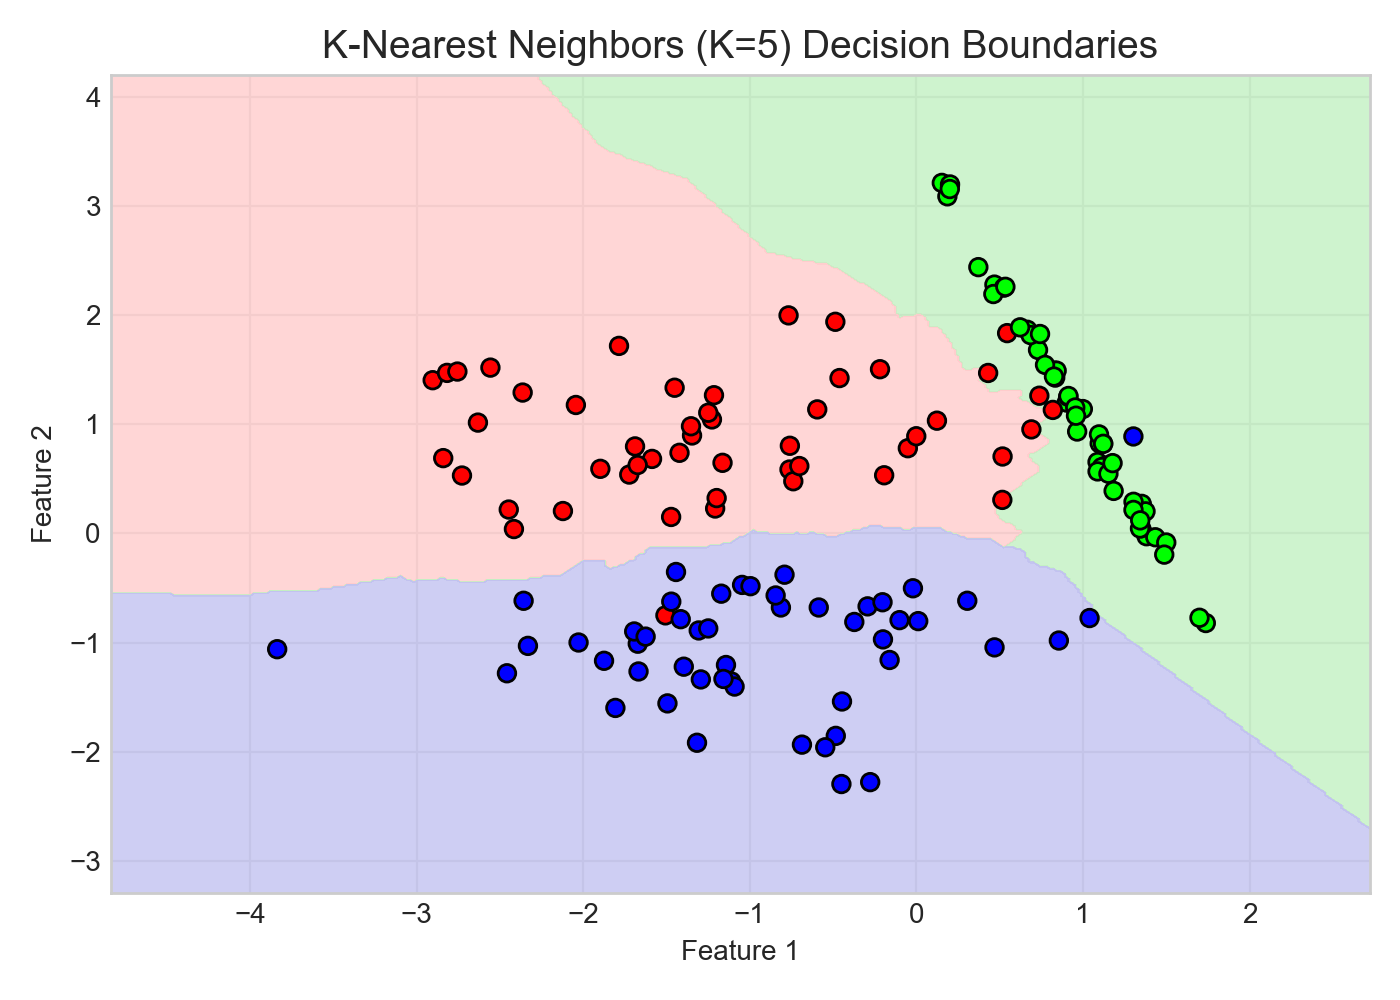
KNN 是一种典型的”懒惰学习(Lazy Learning)”算法,它不拟合显式的参数化预测函数,主要保存训练样本;实际实现也可能构建近邻搜索索引。
直觉理解:就像在陌生城市问路——不靠任何地图(不需要训练),直接问你周围最近的 $K$ 个路人,取多数人的意见。完全依赖”物以类聚、人以群分”的朴素假设。
-
预测机制:在预测时,计算测试样本与所有训练样本之间的距离(如欧氏距离、曼哈顿距离),寻找在特征空间中最近的 $K$ 个样本。
-
决策规则:分类任务采取多数表决(Majority Voting),回归任务取均值。可引入距离加权机制,距离越近权重越大。
-
缺点:暴力搜索需要比较全部训练样本;树索引可加速部分低维任务,但高维时收益有限。距离受特征尺度影响,通常应标准化或设计合适的度量。
| 可优先尝试 | 需要注意 |
|---|---|
| 小数据集、快速原型验证 | 大数据集(预测速度随样本量线性下降) |
| 数据分布不规则、非球形类别边界 | 高维数据(受维度灾难影响严重) |
3.8 朴素贝叶斯与隐马尔可夫模型
核心要点:朴素贝叶斯假设特征条件独立,训练快、文本分类效果好;HMM 建模序列的”隐状态+观测”,适合显式描述状态转移与观测生成关系。
朴素贝叶斯 (Naive Bayes)
朴素贝叶斯是基于贝叶斯定理的分类算法,做出了一个极强但非常高效的”朴素”假设——特征之间相互条件独立。
直觉理解:就像法官凭多条”独立线索”判案——假设每条线索互不影响,把各线索的支持度相乘,哪个结论得分最高就选哪个。这个独立性假设在现实中几乎不成立,但实践中往往够用。
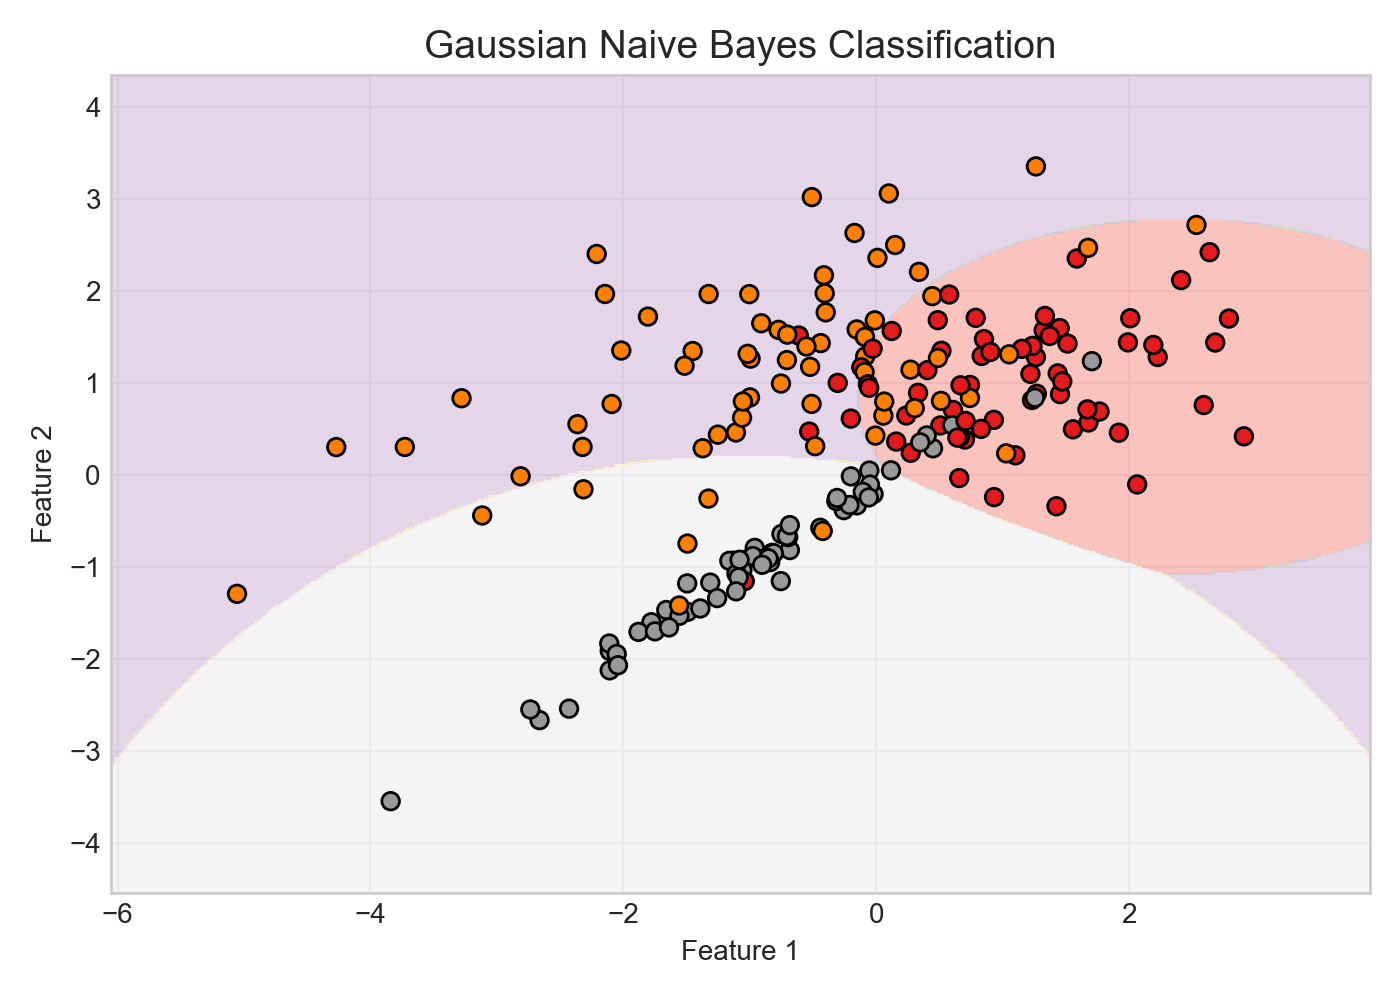
- 贝叶斯定理:给定样本特征 $\mathbf{x} = (x_1, x_2, \dots, x_n)$,后验概率为:
公式解读:$P(y \mid \mathbf{x})$ 是”看到特征 $\mathbf{x}$ 后样本属于类别 $y$ 的概率”(后验);$P(\mathbf{x} \mid y)$ 是”$y$ 类样本出现这组特征的可能性”(似然);$P(y)$ 是该类别的先验概率。分母 $P(\mathbf{x})$ 对所有类别相同,分类时可忽略。
- 朴素假设:假设各特征在给定类别下条件独立,将联合概率分解为各特征概率的乘积:
- 分类决策:选择使后验概率最大的类别,即:
- 特点:尽管条件独立假设在现实中很少严格成立,但朴素贝叶斯在文本分类(垃圾邮件过滤、情感分析)中往往能取得惊人的效果,且训练速度极快,适合超大规模数据。
| 可优先尝试 | 需要注意 |
|---|---|
| 文本分类(垃圾邮件过滤、情感分析) | 特征之间存在强相关性 |
| 样本极少时的快速基线 | 需要精确的概率校准 |
隐马尔可夫模型 (HMM)
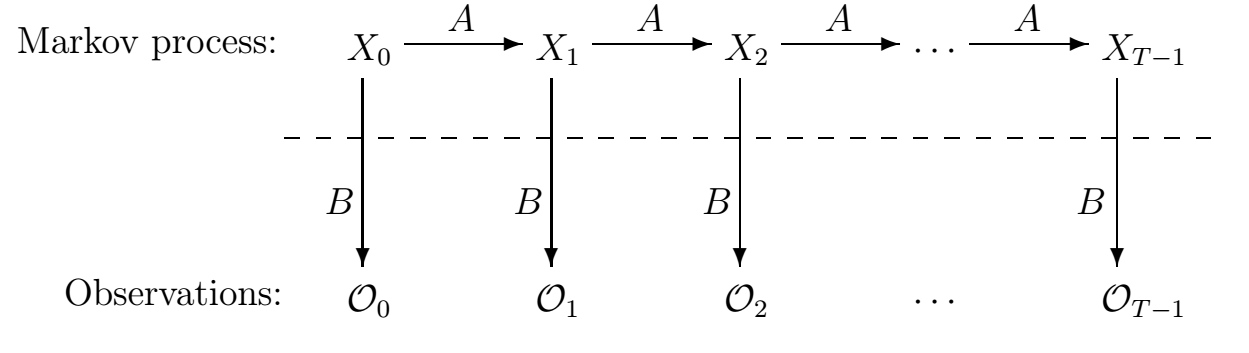
HMM 是一种用于处理序列数据的概率图模型,包含一个不可见的隐藏状态序列和一个可见的观测序列。
直觉理解:就像医生通过观察症状(发烧、咳嗽,这是可见的”观测”)推断内部病因(病毒感染还是细菌感染,这是不可见的”隐状态”)。病因本身看不见,但可以从症状序列反推最可能的病因序列。
-
两个核心假设:
-
马尔可夫假设:当前隐状态 $s_t$ 只依赖于前一个隐状态 $s_{t-1}$,即 $P(s_t \mid s_1, \dots, s_{t-1}) = P(s_t \mid s_{t-1})$。
-
观测独立假设:当前观测 $o_t$ 只依赖于当前隐状态 $s_t$,即 $P(o_t \mid s_1, \dots, s_t) = P(o_t \mid s_t)$。
-
-
三个基本问题:
-
评估问题:给定模型参数,计算某观测序列的概率(前向-后向算法)。
-
解码问题:给定观测序列,求最可能的隐状态序列(Viterbi 算法)。
-
学习问题:从观测数据中估计模型参数(Baum-Welch / EM 算法)。
-
-
应用场景:早期语音识别、词性标注(POS tagging)、基因序列分析。虽然许多语音和 NLP 任务转向深度模型,HMM 在状态解释、有限数据与领域约束明确的序列问题中仍有价值。
3.9 支持向量机 (SVM)
核心要点:寻找最大间隔的分类超平面;核技巧通过隐式特征映射建模非线性边界,但不保证数据可分,也不能消除统计上的维度问题。
在深度学习广泛应用之前,SVM(Support Vector Machines)曾是小样本、高维分类任务中的重要基线。
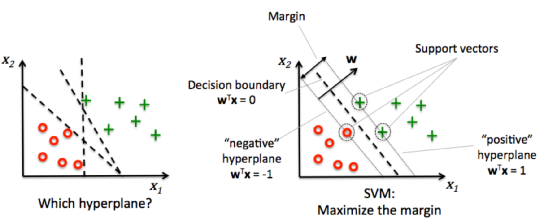
直觉理解:想象两群点分布在平面上,SVM 要在中间画一条线,使两群点离这条线都尽可能远——就像在两军之间挖一条尽可能宽的”护城河”。最优边界由支持向量及其系数决定;软间隔情况下还允许部分样本进入间隔或被误分类。
-
核心思想:试图在特征空间中找到一个超平面,使得不同类别的样本之间不仅被正确分开,而且几何间隔(Margin)最大化。这种”最大间隔”的追求赋予了 SVM 极强的泛化能力。
-
支持向量:对偶问题中系数非零的训练样本称为支持向量。软间隔 SVM 的支持向量还可能落在间隔内,甚至被误分类。
-
核技巧 (Kernel Trick):当数据在原始空间线性不可分时,SVM 通过核函数(如线性核、多项式核、高斯 RBF 核)巧妙地将低维特征隐式映射到高维(甚至是无限维)空间,从而构造非线性决策边界。核技巧省去显式构造高维特征,但仍有核矩阵计算成本和过拟合风险。
| 可优先尝试 | 需要注意 |
|---|---|
| 小样本、高维数据(文本、基因特征) | 大规模核 SVM 的计算和存储代价高;线性 SVM 可采用更易扩展的求解器 |
| 特征维度 » 样本数的场景 | 需要概率输出(SVM 本身不输出概率) |
3.10 K-Means 聚类
核心要点:无监督聚类经典基线,交替更新”样本分配 → 质心位置”至收敛;需预设 K 值、仅擅长球形簇、对初值与异常值敏感。
最经典、应用最广泛的无监督聚类算法。
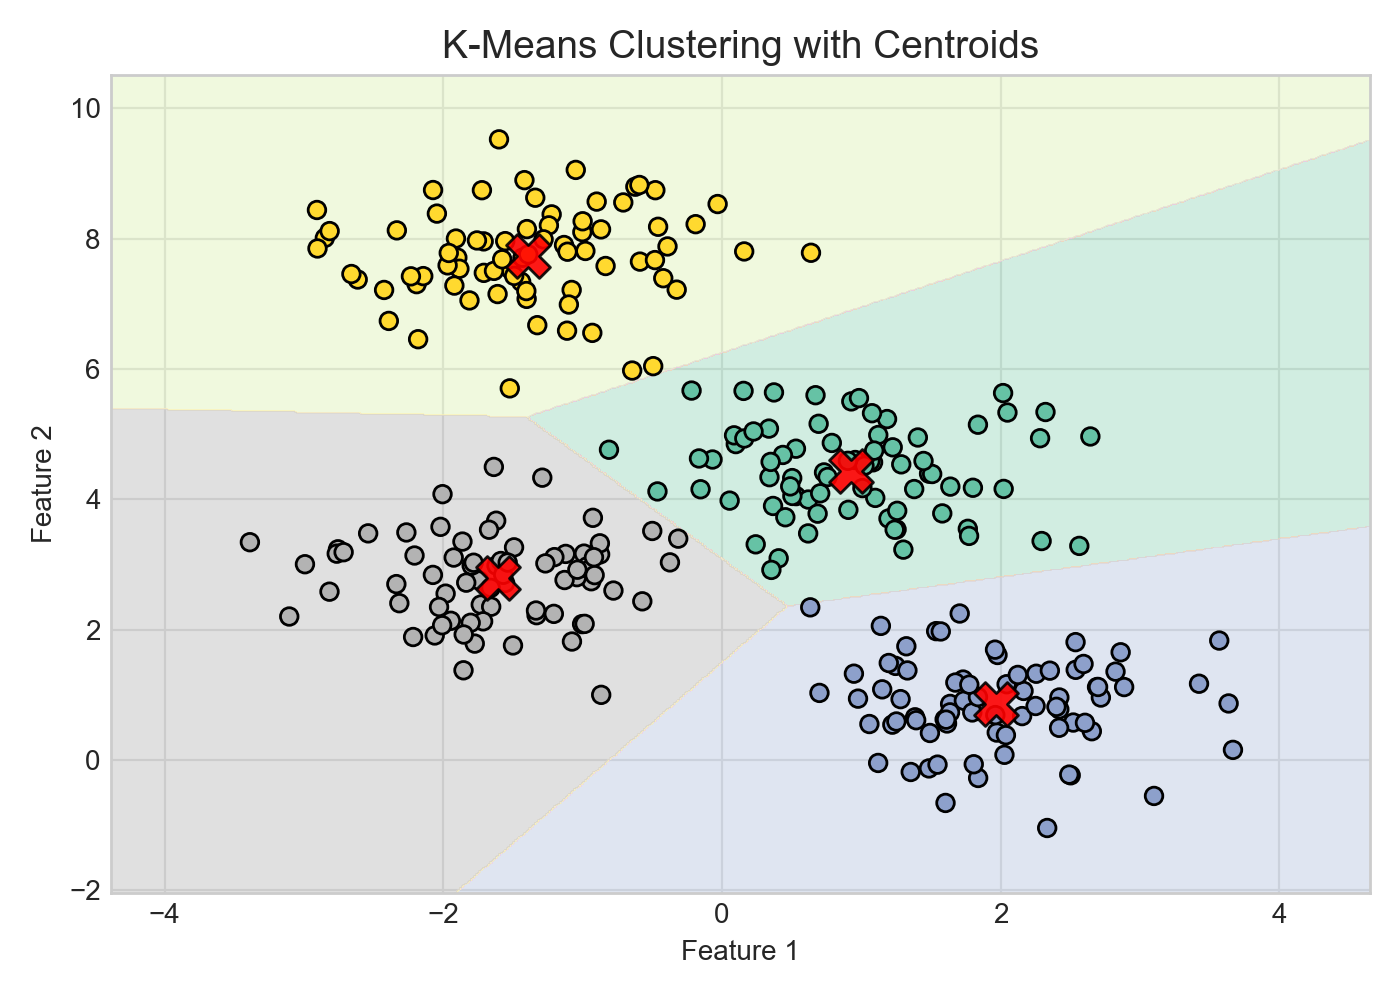
直觉理解:就像选 $K$ 个班长——先随机指定班长,全班同学各自靠近最近的班长;再把每个小组的中心重选为新班长……如此反复,直到班长位置稳定不动。
-
算法流程:
-
随机初始化 $K$ 个聚类中心(Centroids)。
-
遍历所有样本,将其分配给距离最近的聚类中心。
-
根据分配好的簇,重新计算每个簇的质心(即所有样本的均值),更新聚类中心。
-
重复步骤 2 和 3,直到聚类中心不再发生显著变化(收敛)或达到最大迭代次数。
-
-
优缺点:算法简单高效,典型 Lloyd 迭代的时间复杂度为 $O(nKdi)$($d$ 为特征维度,$i$ 为迭代次数);但对初始值的选择和异常值敏感,且必须预先指定 $K$ 值,偏好近似球形、尺度相近的簇,难以处理复杂流形分布的数据。
| 可优先尝试 | 需要注意 |
|---|---|
| 数据分布接近球形、各簇大小相近 | 簇形状不规则(改用 DBSCAN) |
| 快速获得聚类结果、用户画像分群 | $K$ 值难以确定的场景 |
3.11 主成分分析 (PCA) 与 t-SNE
核心要点:PCA 做线性降维、保全局方差;t-SNE 做非线性降维、保局部流形结构,是 2D/3D 可视化首选。
-
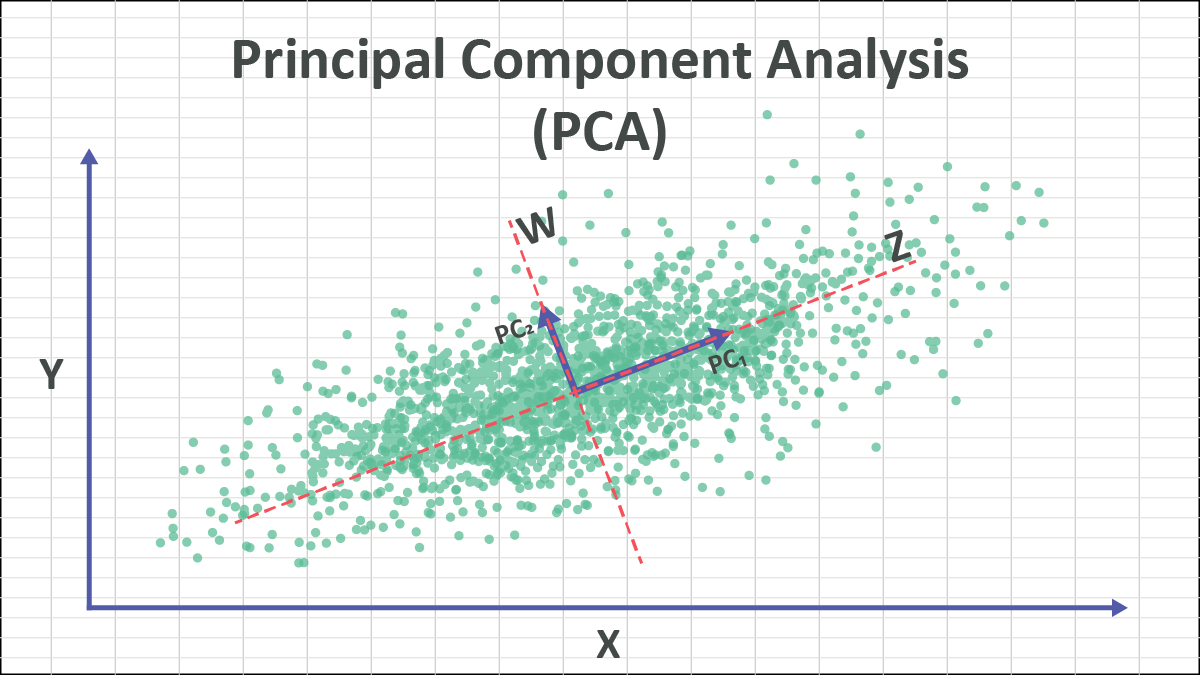
主成分分析 (PCA):一种经典的线性降维方法。核心思想是通过正交变换,将可能相关的原始高维特征投影到一个新的正交坐标系中,这些新的坐标轴(主成分)按照数据方差的大小排列。保留前几个方差最大的主成分,可以在给定线性子空间维度下最小化平方重构误差;高方差方向不一定包含最有利于下游预测的信息。
直觉理解:就像给一个三维物体拍照——选一个最能保留信息的”拍摄角度”,让投影后的 2D 图像信息量最大(方差最大)。PCA 自动找到这个最佳角度。
-
t-SNE (t-Distributed Stochastic Neighbor Embedding):一种非线性降维算法,主要用于将高维数据映射到 2D 或 3D 空间进行可视化。它通过将数据点之间的欧氏距离转化为条件概率来表达相似度,并使用 t 分布缓解高维空间映射到低维时的”拥挤问题(Crowding Problem)”,能够非常出色地保持数据的局部流形结构和类内聚集特征。
直觉理解:就像把一团高维”橡皮泥”压扁到桌面上,尽量让原来靠近的点压平后仍然靠近、远处的点没有同等强的距离保持约束。因此图中的簇间距离、面积和空白不能直接解释为原始空间的真实结构。
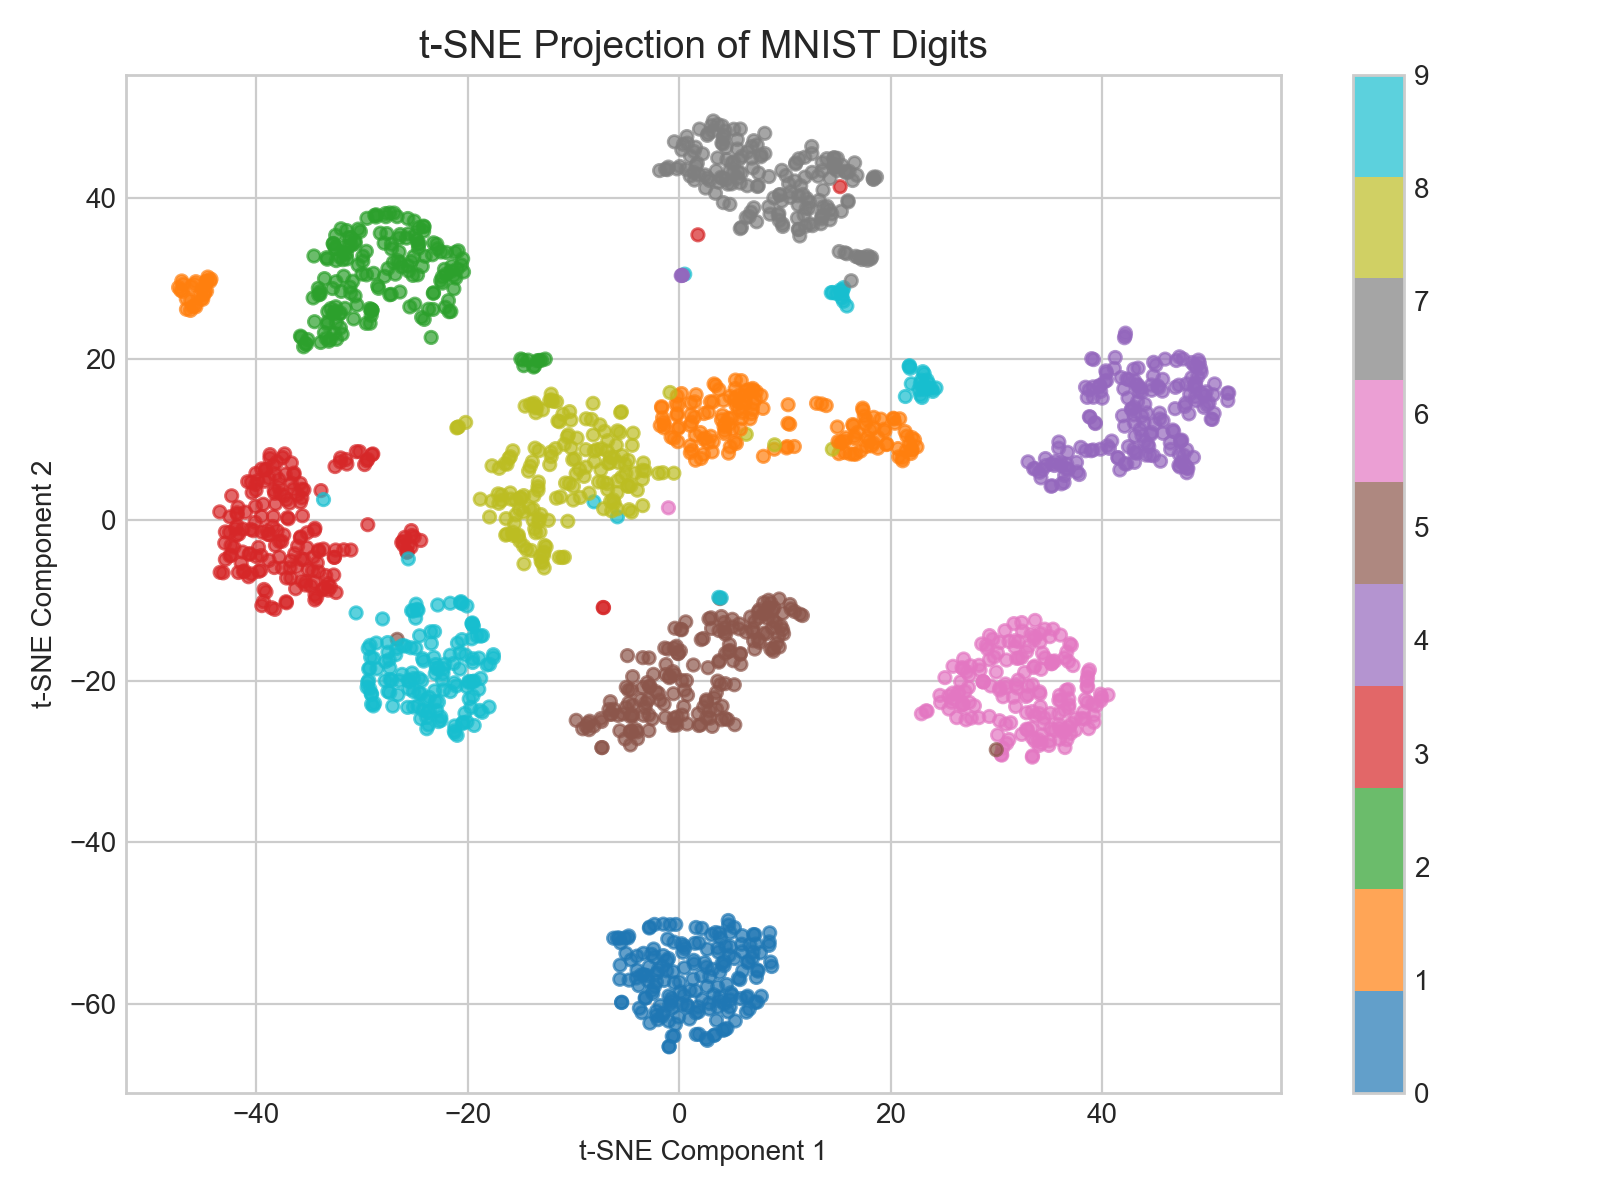
t-SNE 对随机初始化和 perplexity 等超参数敏感,不能仅凭图中分群证明分类效果或发现“真实类别”;它主要是探索工具,不宜直接替代预测任务中的可泛化降维流程。参见 scikit-learn 流形学习文档。
Part B · 深度学习基础(§3.12 – §3.15) —— 通过多层非线性变换学习表示,使用反向传播计算梯度。
本章仅概述核心脉络;激活函数、优化器、归一化、正则化和训练技巧可延伸阅读:《深度学习综述》。
3.12 多层感知机 (MLP) 与反向传播
核心要点:全连接层 + 非线性激活 + 反向传播;在适当条件下有很强的函数表达能力;表达能力、可训练性和泛化能力需要分别判断。
深度学习(Deep Learning, DL)通过多层非线性变换提取数据的高阶特征。多层感知机(Multilayer Perceptron, MLP)是最基础的前馈神经网络(Feedforward Neural Network),也是理解所有深度网络的起点。
直觉理解:就像一条流水线——原料(输入特征)经过多道加工工序(隐藏层),每道工序用激活函数引入”弯折”,让流水线能加工出任意复杂的形状(函数)。层越深,能表达的”加工逻辑”越复杂。

- 结构:由输入层、一个或多个隐藏层以及输出层组成,层与层之间全连接。每个神经元接收上一层输出的加权和,并经过非线性激活函数处理。单层的计算可表示为:
其中 $\mathbf{W}$ 是本层的权重矩阵(每个连接的强弱),$\mathbf{x}$ 是上一层的输出,$\mathbf{b}$ 是偏置向量,$\sigma$ 是非线性激活函数——没有它,多层线性变换等价于单层线性变换,网络失去深度的意义。
-
激活函数:引入非线性是深度网络的关键——没有激活函数,多层线性变换等价于单层。常见激活函数:
-
Sigmoid:$\sigma(x) = \frac{1}{1+e^{-x}}$,输出 $(0,1)$,易梯度消失。
-
Tanh:输出 $(-1,1)$,零中心化,但仍有梯度消失问题。
-
ReLU:$\text{ReLU}(x) = \max(0, x)$,计算简单,缓解梯度消失,是常用激活函数之一。负区间梯度为零可能导致神经元持续不激活;Leaky ReLU、GELU 等是其他常见选择。
-
-
万能逼近定理(Universal Approximation Theorem):在合适激活函数等条件下,足够宽的单隐层网络可以在紧致域上任意逼近连续函数。该定理不保证所需宽度可接受,也不保证有限数据下能训练出来或泛化良好;深度结构对某些函数有更高的表达效率。
-
反向传播 (Backpropagation):神经网络训练的基石。
-
前向传播:输入数据逐层计算,得到预测输出和损失 $\mathcal{L}$。
-
反向传播:基于微积分的链式法则,从输出层反向逐层计算损失对每个参数的梯度。例如对权重 $W_{ij}$ 的梯度:$\frac{\partial \mathcal{L}}{\partial W_{ij}} = \frac{\partial \mathcal{L}}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial h} \cdot \frac{\partial h}{\partial W_{ij}}$。
-
参数更新:利用梯度下降算法更新参数,如 SGD:$\mathbf{W} \leftarrow \mathbf{W} - \eta \frac{\partial \mathcal{L}}{\partial \mathbf{W}}$。
-
-
常用优化器:
-
SGD + Momentum:累积历史梯度以减少方向振荡、改善部分优化问题的收敛速度。
-
Adam:自适应学习率优化器,结合了 Momentum 和 RMSProp 的优点,适合许多深度学习任务;是否优于 SGD 取决于任务与调参。
-
| 可优先尝试 | 需要注意 |
|---|---|
| 通用表格数据的深度学习入门 | 图像(用 CNN)、序列(用 RNN/Transformer) |
| 特征工程完善后的分类/回归任务 | 数据量极少(参数量多,容易过拟合) |
3.13 卷积神经网络 (CNN)
核心要点:局部感受野 + 权重共享 + 池化,为图像等网格数据而生;ResNet 残差连接让网络得以训练到上百层,是计算机视觉的基石。
CNN 是专门为处理网格状拓扑数据(如图像的 2D 像素网格)而设计的神经网络架构,是计算机视觉领域的基石。
直觉理解:CNN 的卷积核像一个滑动的”放大镜”,在图像上逐区域扫描——浅层识别边缘和颜色,中层识别纹理和形状,深层组合出”耳朵”“眼睛”等高级语义。层层抽象,最终认出”这是一只猫”。

-
核心机制:
-
局部感受野与卷积核:利用小型滤波器(卷积核)在输入特征图上滑动,提取局部特征(如边缘、纹理),极大地减少了参数量。
-
权重共享:同一个卷积核遍历整张图像,使得模型具有平移等变性。
-
池化层 (Pooling):如最大池化,用于下采样和局部聚合,可提高对小幅位移的容忍度,但不保证严格的平移不变性。步幅和边界处理也会影响网络的等变性质。
-
-
经典架构:LeNet-5 (早期手写数字识别)、AlexNet (引爆深度学习)、VGG (堆叠小卷积核)、ResNet (引入残差连接解决深层网络退化问题,深度可达上百层)。
| 可优先尝试 | 需要注意 |
|---|---|
| 图像、视频等网格状数据 | 纯序列/文本数据(改用 Transformer) |
| 需要平移不变性、提取局部特征 | 数据量极少(可用迁移学习缓解) |
3.14 循环神经网络 (RNN & LSTM/GRU)
核心要点:隐状态赋予网络时间记忆;LSTM/GRU 用门控机制缓解长距离依赖学习中的梯度问题,是 Transformer 出现前的序列建模主力。
循环神经网络家族经历了 RNN → LSTM → GRU 的演进,LSTM 和 GRU 是两种不同的门控结构,后提出的方法不一定在每个任务上更好。
RNN — 基础循环结构
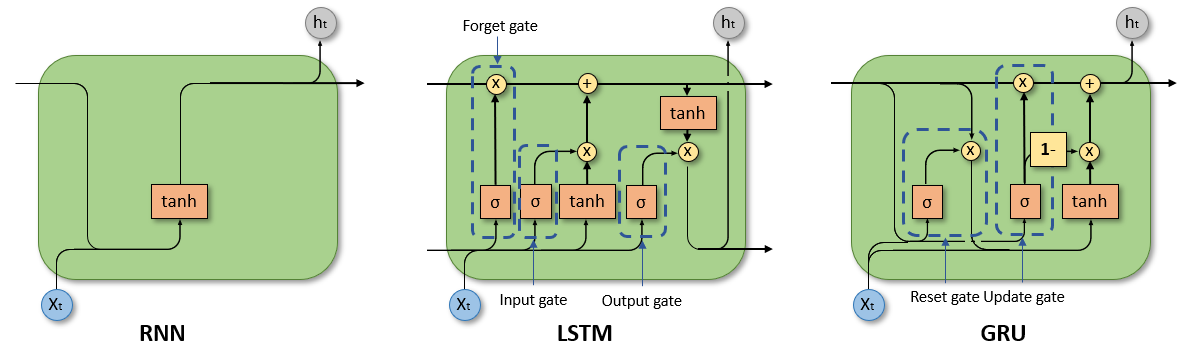
RNN 专门用于处理文本、语音、时间序列等变长序列数据。与普通神经网络不同,它在处理每个时间步时保留一个”隐状态”传递给下一步,赋予网络时间上的记忆。
直觉理解:就像一个边读边记的阅读者——每步都把”当前输入 + 上一步记忆”合并成新的记忆传给下一步。
-
隐状态机制:每个时间步的计算为 $h_t = \tanh(W_h h_{t-1} + W_x x_t + b)$,其中 $h_{t-1}$ 是上一步的隐状态,$x_t$ 是当前输入。
-
长距离依赖困难:时间维度上的反向传播(BPTT)需要多次连乘梯度,容易出现梯度消失或爆炸,使基础 RNN 难以稳定学习相距较远的依赖关系。
LSTM — 门控记忆
长短期记忆网络(Long Short-Term Memory)通过引入细胞状态(Cell State)和三个门控机制,提供更直接的梯度传播路径,缓解长期依赖学习困难,但并不保证梯度永不消失或爆炸。
直觉理解:LSTM 给记忆装了三个开关——遗忘门决定”哪些旧记忆可以删掉”,输入门决定”哪些新信息值得记住”,输出门决定”现在对外输出哪部分记忆”。细胞状态就像一条高速公路,信息保留程度由门值决定。
-
遗忘门:$f_t = \sigma(W_f [h_{t-1}, x_t] + b_f)$,输出 0~1 决定旧细胞状态中哪些被保留(0 = 完全遗忘,1 = 完全保留)。
-
输入门:$i_t = \sigma(W_i [h_{t-1}, x_t] + b_i)$,决定哪些新信息写入;候选内容为 \(\tilde{C}_t = \tanh(W_C [h_{t-1}, x_t] + b_C)\)。
-
细胞状态更新:\(C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t\),旧记忆选择性遗忘后加入选择性新信息($\odot$ 为逐元素乘)。
-
输出门:$o_t = \sigma(W_o [h_{t-1}, x_t] + b_o)$,最终输出 $h_t = o_t \odot \tanh(C_t)$,决定当前步对外输出什么。
GRU — 轻量化改进
门控循环单元(Gated Recurrent Unit,Cho et al. 2014)是对 LSTM 的简化:将三个门合并为两个,取消独立的细胞状态,相同输入与隐状态维度下通常参数更少,具体速度和效果仍需实测。
直觉理解:GRU 把遗忘门和输入门合并成一个更新门(”该保留多少旧的、引入多少新的”),用重置门控制历史信息的影响程度。结构更简洁,推理更快。
-
重置门:$r_t = \sigma(W_r [h_{t-1}, x_t])$,控制上一步隐状态对候选状态的影响,接近 0 时相当于”重新开始”。
-
更新门:$z_t = \sigma(W_z [h_{t-1}, x_t])$,同时扮演遗忘门和输入门:\(h_t = (1-z_t) \odot h_{t-1} + z_t \odot \tilde{h}_t\)。
-
选型建议:序列较长或需要更强记忆能力时可尝试 LSTM;追求训练速度或资源受限时可优先尝试 GRU。两者效果取决于任务和数据,建议通过验证集比较。
| 可优先尝试 | 需要注意 |
|---|---|
| 短到中等长度序列(时间序列预测、语音帧) | 超长序列(Transformer 并行处理更高效) |
| 资源受限需要轻量实时推理(优先 GRU) | 需要捕捉文本中的远距离上下文 |
3.15 Transformer 架构
核心要点:以 Self-Attention 为核心,并行建模全局长距离依赖;Transformer 已成为许多语言、多模态和生成模型的基础架构。
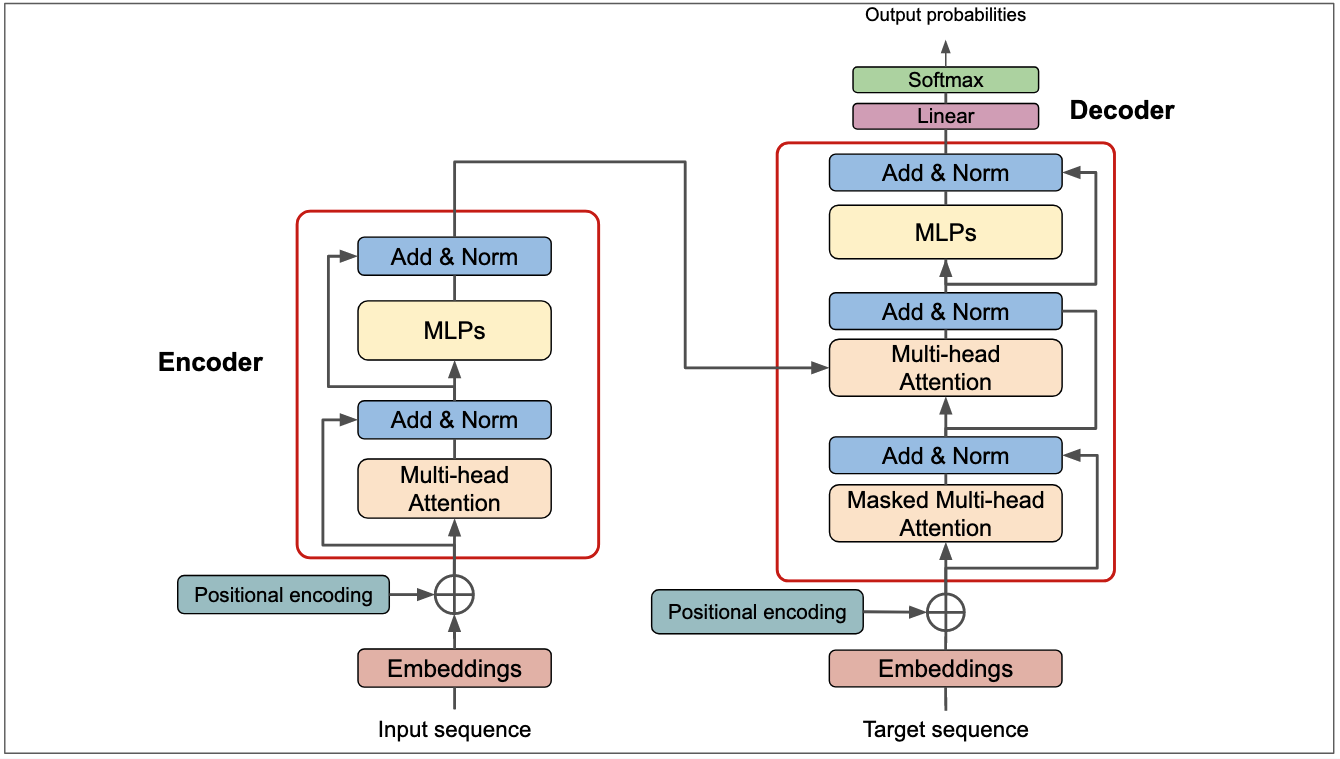
Transformer(Vaswani et al., 2017, “Attention Is All You Need”)以自注意力和前馈网络为核心,摆脱了循环结构的串行依赖,成为许多现代基础模型的重要架构。
直觉理解:Transformer 就像一个”全局会议室”——每个 token 都能与掩码允许的位置直接交互(自注意力),不需要像 RNN 那样靠”传话”来传递信息。因此它能并行处理、高效捕捉任意距离的上下文依赖。
自注意力机制 (Self-Attention)
无因果限制的全局自注意力允许序列中每个元素关注其他位置;因果自注意力只能关注当前位置及之前的位置,计算出它们之间的关联权重,从而并行地捕捉全局长距离依赖。
-
输入序列通过三个线性变换分别生成 Query ($Q$)、Key ($K$)、Value ($V$) 矩阵。
-
注意力权重通过 $Q$ 和 $K$ 的点积计算,再经 Softmax 归一化后加权 $V$:
公式解读:$Q$ = “我在找什么”,$K$ = “我能提供什么关键词”,$V$ = “我的实际内容”。$Q \cdot K^T$ 计算每对 token 的相关性得分,除以 $\sqrt{d_k}$ 防止得分过大导致 Softmax 梯度消失,最终对 $V$ 加权求和,得到每个 token 融合了上下文信息的新表示。
多头注意力 (Multi-Head Attention)
将 $Q, K, V$ 拆分为 $h$ 个独立的”头”,每个头在不同的子空间中计算注意力,最后拼接:
\[\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)W^O\]不同的头可以同时关注不同层面的关系(语法关系、语义关系、位置关系等),大幅提升表达能力。
Transformer Block 结构
基础 Encoder Block 和常见 Decoder-only Block 包含以下两类子层,配合残差连接与 LayerNorm改善训练稳定性;原始 Encoder-Decoder 模型的 Decoder 还包含交叉注意力:
- 多头自注意力层:捕捉 token 间的依赖关系。
- 前馈网络 (FFN):两层线性变换夹一个激活函数,对每个位置独立做非线性变换:$\text{FFN}(x) = W_2 \cdot \text{ReLU}(W_1 x + b_1) + b_2$。
位置编码 (Positional Encoding)
没有位置编码与顺序相关掩码时,自注意力对排列是等变的:打乱输入会使输出按相同方式重排,而不是输出完全不变。因此通常需要加入位置信息以区分顺序。原始方案使用正弦/余弦函数编码绝对位置;后续发展出 RoPE(旋转位置编码,LLaMA 系列采用)、ALiBi 等相对位置编码方案。
Encoder-Decoder 架构
- Encoder:$N$ 个 Block 堆叠,输入 token 可以双向互相关注,适合”理解”类任务(如机器翻译的源语言编码)。
- Decoder:同样 $N$ 个 Block,但自注意力层加因果掩码(Causal Mask)——每个 token 只能看到它之前的内容(自回归生成);并增加交叉注意力层,$Q$ 来自 Decoder,$K, V$ 来自 Encoder,实现对源语言的关注。
为什么 Transformer 能替代 RNN
RNN 必须按时间步串行处理($O(n)$ 串行依赖),无法充分利用 GPU 并行;Self-Attention 一次并行计算所有 token 对的关系(训练复杂度 $O(n^2 d)$),便于在训练中并行处理序列,并缩短远距离位置之间的信息路径。但深层 Transformer 仍可能有优化和梯度问题;标准自回归推理依然按生成步骤进行,注意力也有二次计算成本。原始论文讨论了这些架构差异。
| 可优先尝试 | 需要注意 |
|---|---|
| 长序列、需要全局上下文(NLP、多模态) | 超长序列时显存消耗大($O(n^2)$,需 Flash Attention 等优化) |
| 数据量充足的大规模预训练场景 | 极小数据集(归纳偏置弱,不如 CNN 收敛快) |
Part C · 预训练大模型范式(§3.16) —— Transformer × 海量无标签语料,”预训练 + 微调/Prompt” 的新范式彻底改变了 NLP,并催生大模型时代。
3.16 BERT 与 GPT 系列模型范式
核心要点:BERT 用双向 Encoder 擅长理解类任务(分类、抽取);GPT 用自回归 Decoder 擅长生成,可结合指令微调和偏好优化改善交互行为。
这里对比两种代表性的预训练方式。它们不是“理解”和“生成”的严格分界:Decoder-only 模型也可做分类,Encoder-Decoder 模型(如 T5)则提供另一种组织方式。
直觉理解:BERT 就像做填空题——把句子里随机抠掉几个词,让模型结合前后文猜出来,迫使它理解双向上下文。GPT 则像续写故事——给你前半段,一个词一个词接龙,通过大量序列预测学习语言规律,并可适配问答、代码等任务;这些能力需要具体评估。
BERT — 双向编码器范式
BERT(Bidirectional Encoder Representations from Transformers, Google 2018)采用 Transformer 的 Encoder 部分,核心创新在于双向上下文建模。
-
预训练任务:
-
掩码语言模型(MLM):随机选择 15% 的 token 作为预测目标;在这些位置中,80% 替换为
[MASK],10% 替换为随机 token,10% 保持原样。模型根据双向上下文预测原 token。比例针对“被选中的位置”,不是整段输入。BERT 原论文给出了具体流程。 -
下一句预测(NSP):判断两个句子是否为上下文连续关系,帮助模型学习句间语义。
-
-
使用范式 ——”预训练 + 微调”:先在大规模无标注语料上预训练,然后在具体下游任务上用少量标注数据微调。BERT 在 GLUE、SQuAD 等基准上大幅刷新纪录,定义了 NLU 时代的标准范式。
-
局限:MLM 的
[MASK]标记在推理时不存在,导致预训练与推理之间存在分布不匹配(Pretrain-Finetune Discrepancy);且 Encoder 架构不擅长文本生成任务。 -
后续发展:RoBERTa(去掉 NSP、更大数据更长训练)、ALBERT(参数共享压缩)、DeBERTa(解耦注意力)等进一步优化。
GPT — 自回归解码器范式
GPT(Generative Pre-trained Transformer, OpenAI)采用带因果自注意力的 Decoder-only 结构(通常不含原始翻译模型中对 Encoder 的交叉注意力),通过自回归方式逐 token 生成文本。
- 预训练任务 — 下一 token 预测:给定前文 $x_1, x_2, \dots, x_{t-1}$,预测下一个 token $x_t$。训练通常最小化负对数似然,与最大化序列对数似然等价:
通过因果掩码(Causal Mask)确保每个位置只能看到之前的 token,保证自回归约束。
-
Scaling Laws 与涌现能力:语言模型损失在一定实验范围内随参数、数据和计算规模呈经验缩放关系,但不能据此保证所有任务能力同步提升。“涌现”还受评价指标影响:离散评分可能把连续改进显示为突然跃升,应结合任务、模型族与测量方式解释。参见 Kaplan et al.与关于涌现测量的研究。
-
历史代表模型(用于理解方法演变,不是完整产品清单):
| 模型 | 参数量 | 关键突破 |
|---|---|---|
| GPT-1 | 1.17 亿 | 验证了”无监督预训练 + 有监督微调”的可行性 |
| GPT-2 | 15 亿 | 展示零样本(Zero-shot)能力,文本生成质量引发社会关注 |
| GPT-3 | 1750 亿 | In-context Learning,少样本(Few-shot)能力惊艳,无需微调 |
| GPT-4 | 未公开 | 多模态(文本+图像输入)、RLHF 对齐、更强的推理能力 |
- 指令微调与偏好优化:监督微调(SFT)学习示范回答;典型 RLHF 流程再用偏好数据训练奖励模型,并用 PPO 等方法优化策略。DPO 则直接用偏好对优化语言模型,无需单独训练显式奖励模型,也无需在微调过程中运行 PPO。两者都依赖反馈质量,不能保证事实正确或消除全部风险。参见 InstructGPT和 DPO。
两大范式对比
| 维度 | BERT(Encoder) | GPT(Decoder) |
|---|---|---|
| 注意力方向 | 双向(完整上下文) | 单向(仅看前文) |
| 预训练任务 | 掩码语言模型(填空) | 下一 token 预测(续写) |
| 擅长任务 | 理解类(分类、抽取、匹配) | 生成类(对话、写作、推理) |
| 使用范式 | 预训练 + 微调 | 预训练 + Prompting / In-context Learning |
| 选型考量 | 适合固定输出、表征提取和任务微调 | 适合开放式输出;仍需评估成本、幻觉与任务表现 |
Part D · 生成式模型(§3.17 – §3.20) —— 从对抗博弈(GAN)到概率建模(VAE)再到去噪扩散(Diffusion),AI 从”理解数据”走向”创造数据”。
3.17 生成对抗网络 (GAN)
核心要点:生成器与判别器博弈对抗,G 造假、D 鉴伪;采样通常只需一次生成器前向,但训练可能不稳定,并存在模式崩溃风险。
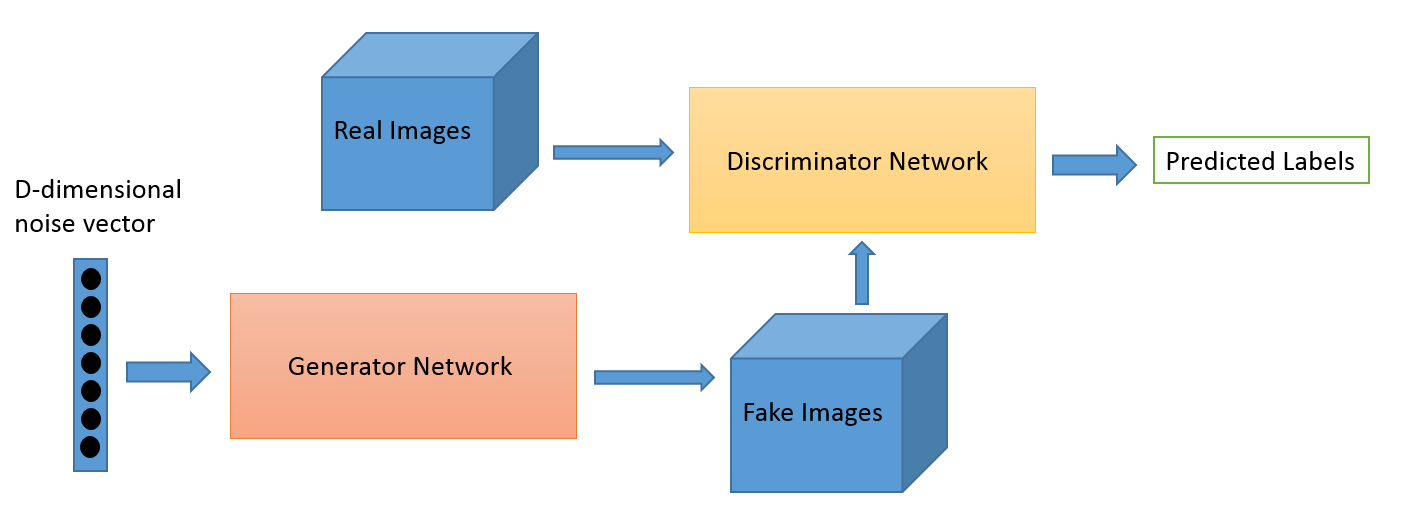
GAN(Generative Adversarial Network)通过生成器与判别器的对抗训练学习生成分布。
直觉理解:就像造假币者(生成器 G)和验钞员(判别器 D)的博弈——G 不断提升造假水平,D 不断提升鉴别能力。两者相互竞争、共同进化,目标是让生成样本更接近真实分布,但训练不保证达到理想均衡。
-
架构:包含两个相互对抗的神经网络——生成器(Generator, G) 和 判别器(Discriminator, D)。
-
核心思想:生成器从随机噪声 $\mathbf{z} \sim p_z(z)$ 出发,试图生成逼真的假样本 $G(\mathbf{z})$;判别器则接收真实样本 $\mathbf{x}$ 和生成样本 $G(\mathbf{z})$,输出一个概率值 $D(\cdot) \in [0,1]$,表示”该样本为真”的置信度。两者在训练中不断博弈、共同进化。
-
目标函数(极小极大博弈):
公式解读:$\mathbb{E}[\log D(\mathbf{x})]$ 是 D 对真实样本的得分(越大越好);$\mathbb{E}[\log(1-D(G(\mathbf{z})))]$ 是 D 对假样本的判断——D 希望这项大(假样本得低分),G 希望这项小(让假样本骗过 D)。在理想容量和全局最优等理论条件下,生成分布等于真实分布时最优判别器输出 0.5。实际训练中输出接近 0.5 也可能是判别器没有学好,不能单独作为生成质量的证明。
-
训练流程:
-
固定 G,训练 D 若干步:用真实样本(标签=1)和生成样本(标签=0)训练二分类器。
-
固定 D,训练 G 一步:生成假样本送入 D,用 D 的反馈梯度更新 G,使生成样本更逼真。
-
交替重复上述过程直到收敛。
-
-
常见问题与改进:
-
模式崩溃(Mode Collapse):G 只学会生成少数几种样本,丢失了数据的多样性。
-
训练不稳定:G 和 D 的能力需要保持平衡,否则梯度消失或爆炸。
-
改进变体:WGAN(用 Wasserstein 距离替代 JS 散度,缓解训练不稳定)、StyleGAN(引入风格控制,生成高分辨率人脸)、CycleGAN(无配对数据的图像风格迁移)。
-
-
应用场景:图像生成、超分辨率重建(SRGAN)、图像修复(Inpainting)、风格迁移、数据增强。
| 可优先尝试 | 需要注意 |
|---|---|
| 图像风格迁移、超分辨率重建 | 需要训练稳定性和生成多样性 |
| 数据增强(扩充小数据集) | 需要精确概率建模 |
3.18 自编码器 (Autoencoder)
核心要点:Encoder-Decoder 瓶颈结构学习压缩表示,可视作非线性 PCA;擅长去噪/降维/异常检测,但隐空间不规则,不适合直接生成新样本。
自编码器(Autoencoder, AE)是一种无监督学习的神经网络模型,核心目标是学习数据的压缩表示。
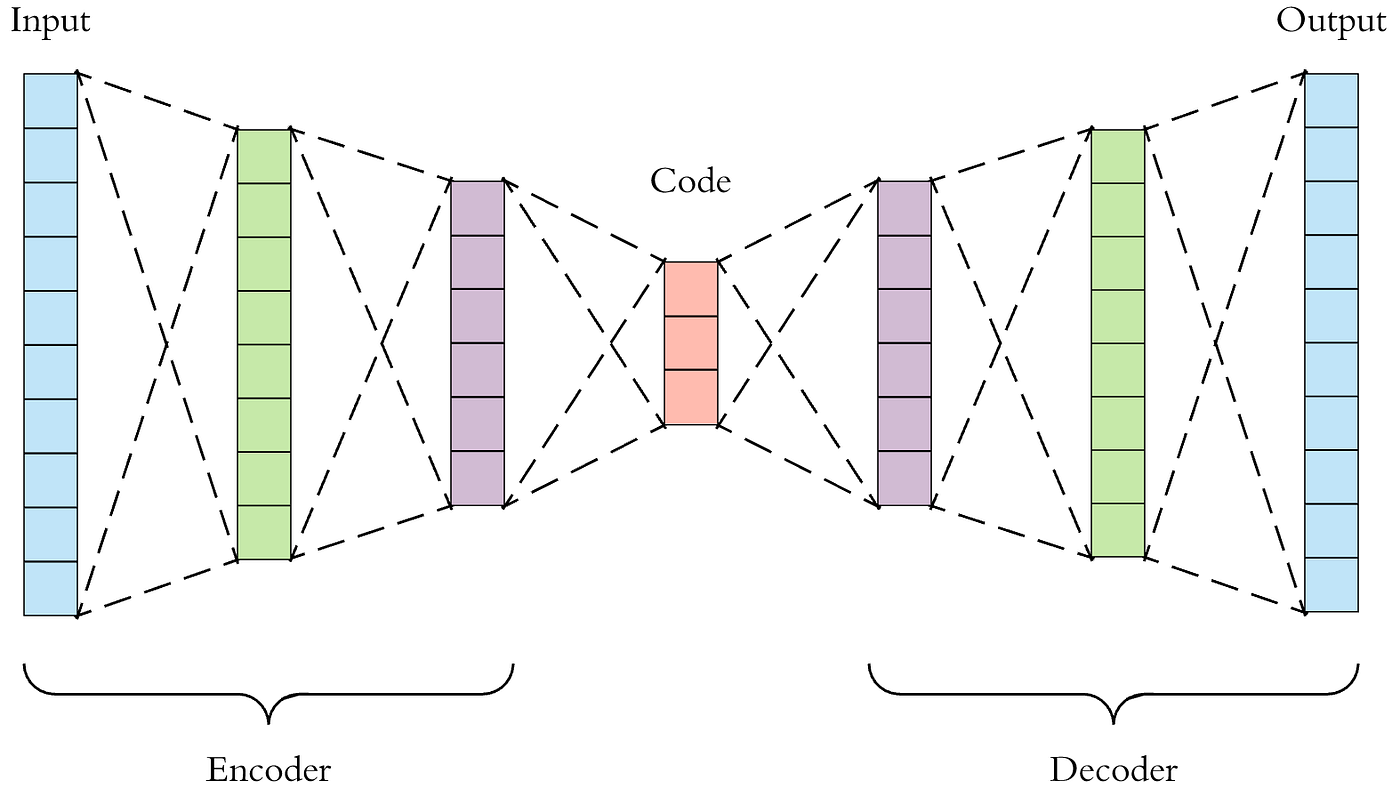
直觉理解:就像”压缩文件再解压”——把一张图片先压缩成几十个数字(编码),再从这几十个数字还原出图片(解码)。瓶颈结构迫使网络把最精华的信息塞进少数几个数字里,自动学会数据的本质特征。
-
架构:由编码器(Encoder) $f_\theta$ 和解码器(Decoder) $g_\phi$ 两部分组成。编码器将高维输入 $\mathbf{x} \in \mathbb{R}^n$ 压缩为低维潜在表示 $\mathbf{z} = f_\theta(\mathbf{x}) \in \mathbb{R}^d$(其中 $d \ll n$),然后解码器再将 $\mathbf{z}$ 映射回原始空间,生成重构 $\hat{\mathbf{x}} = g_\phi(\mathbf{z})$。
-
核心思想:通过”瓶颈”结构(低维隐层)迫使网络学习数据中最本质的特征,丢弃冗余信息。可以类比为一种非线性的 PCA。
-
损失函数:最小化重构误差,如均方误差:
公式解读:$\mathbf{x}$ 是原始输入,$\hat{\mathbf{x}}$ 是重构输出,损失就是”还原有多失真”。训练完成后,编码器 $f_\theta$ 提取到的隐向量 $\mathbf{z}$ 就是数据的压缩表示($d \ll n$)。
-
主要变体:
-
去噪自编码器(Denoising AE, DAE):输入人为加噪的 $\tilde{\mathbf{x}}$,训练模型恢复出干净的 $\mathbf{x}$,迫使网络学习更鲁棒的特征。
-
稀疏自编码器(Sparse AE):在隐层上施加稀疏约束(如 KL 散度惩罚),使得只有少数神经元被激活,得到可解释性更强的特征。
-
收缩自编码器(Contractive AE):在损失中加入编码器雅可比矩阵的 Frobenius 范数惩罚,使隐层表示对输入微小扰动不敏感。
-
-
局限性:普通 AE 没有显式匹配可采样先验的约束;随机采样的隐向量可能落在训练编码很少覆盖的区域,解码质量无法保证。这不等于编码或解码函数在数学上不连续。因此 AE 擅长压缩和重构,但不适合直接用于生成新样本,这正是 VAE 要解决的问题。
-
应用场景:非线性降维与特征学习、图像去噪、异常检测(以重构误差作候选分数,但异常样本也可能被很好地重构,需单独验证)。
| 可优先尝试 | 需要注意 |
|---|---|
| 数据降维、特征学习、图像去噪 | 需要生成全新样本(改用 VAE/Diffusion) |
| 异常检测(重构误差作为异常分数) | 隐空间可解释性和连续性要求高 |
3.19 变分自编码器 (VAE)
核心要点:VAE 为潜变量指定先验,并用编码器近似后验;通过变分推断同时学习重构和可采样的生成分布。
直觉理解:普通 AE 给每个输入一个确定编码,VAE 则给出一组可能编码的概率分布。训练时兼顾重构质量与先验约束,生成时从先验采样后解码。它鼓励更有组织的潜在空间,但不保证每个采样点都对应合理样本。
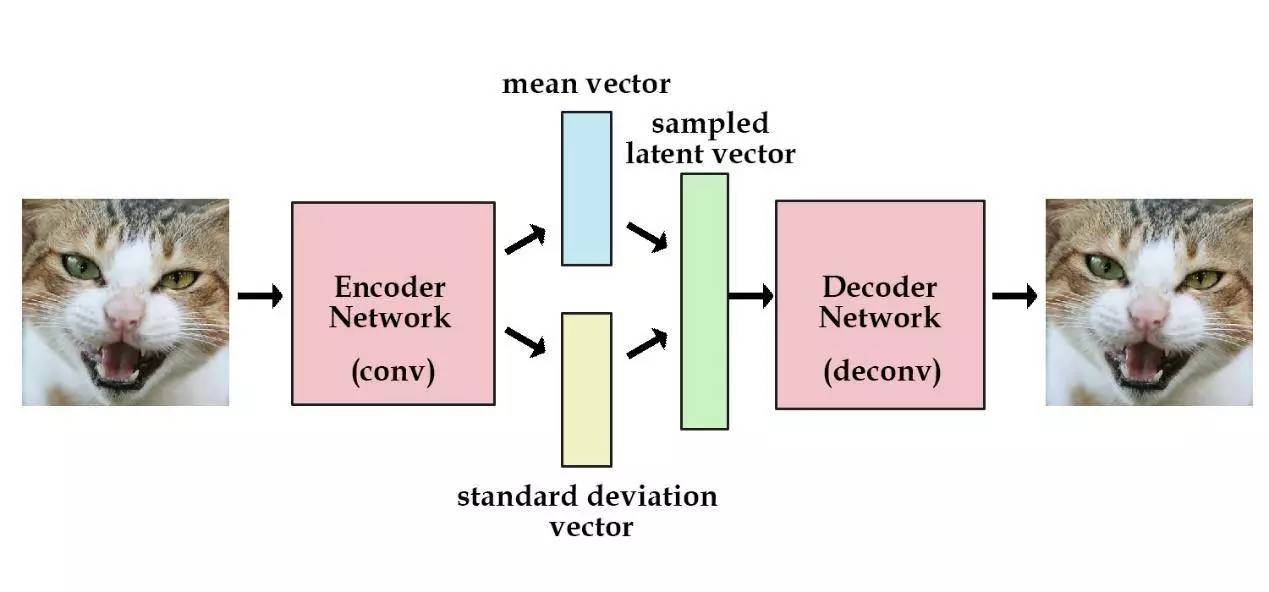
编码器给出近似后验 $q_\phi(\mathbf{z}\mid\mathbf{x})$,解码器定义观测分布 $p_\theta(\mathbf{x}\mid\mathbf{z})$,常用先验为 $p(\mathbf{z})=\mathcal{N}(0,I)$。VAE 最大化证据下界(ELBO):
\[\log p_\theta(\mathbf{x}) \geq \mathcal{L}_{\mathrm{ELBO}} = \mathbb{E}_{q_\phi(\mathbf{z}\mid\mathbf{x})}[\log p_\theta(\mathbf{x}\mid\mathbf{z})] - D_{\mathrm{KL}}\big(q_\phi(\mathbf{z}\mid\mathbf{x})\,\|\,p(\mathbf{z})\big)\]实现时通常最小化负 ELBO。第一项鼓励重构,第二项约束近似后验与先验的差异。在固定方差高斯观测模型下,负对数似然可写为带系数的平方重构误差加常数;因此“重构 MSE + KL”是特定假设下的写法,不是所有 VAE 的通用精确目标。原始论文给出了变分推导。
对于对角高斯后验,编码器输出均值 $\boldsymbol{\mu}$ 和对数方差 $\log\boldsymbol{\sigma}^2$,通过重参数化采样:
\[\mathbf{z}=\boldsymbol{\mu}+\boldsymbol{\sigma}\odot\boldsymbol{\epsilon},\qquad \boldsymbol{\epsilon}\sim\mathcal{N}(0,I)\]随机性来自独立噪声,梯度可通过均值与标准差回传到编码器。生成时直接从先验采样,无需输入原始样本。
| 可优先尝试 | 需要注意 |
|---|---|
| 潜变量建模、数据压缩、生成与插值 | 平滑插值不保证语义合理,采样质量依赖模型与训练 |
| 为潜空间生成模型提供编码器/解码器 | 简单高斯解码器可能产生模糊结果;KL 过强可能导致后验坍塌 |
AE、VAE 与扩散模型也可以组合:潜空间扩散先在压缩表示上生成,再通过解码器恢复图像。
3.20 扩散模型 (Diffusion Models)
核心要点:通过不同噪声水平下的学习目标建立生成过程;以 DDPM 为例,训练预测噪声,采样时迭代更新样本。
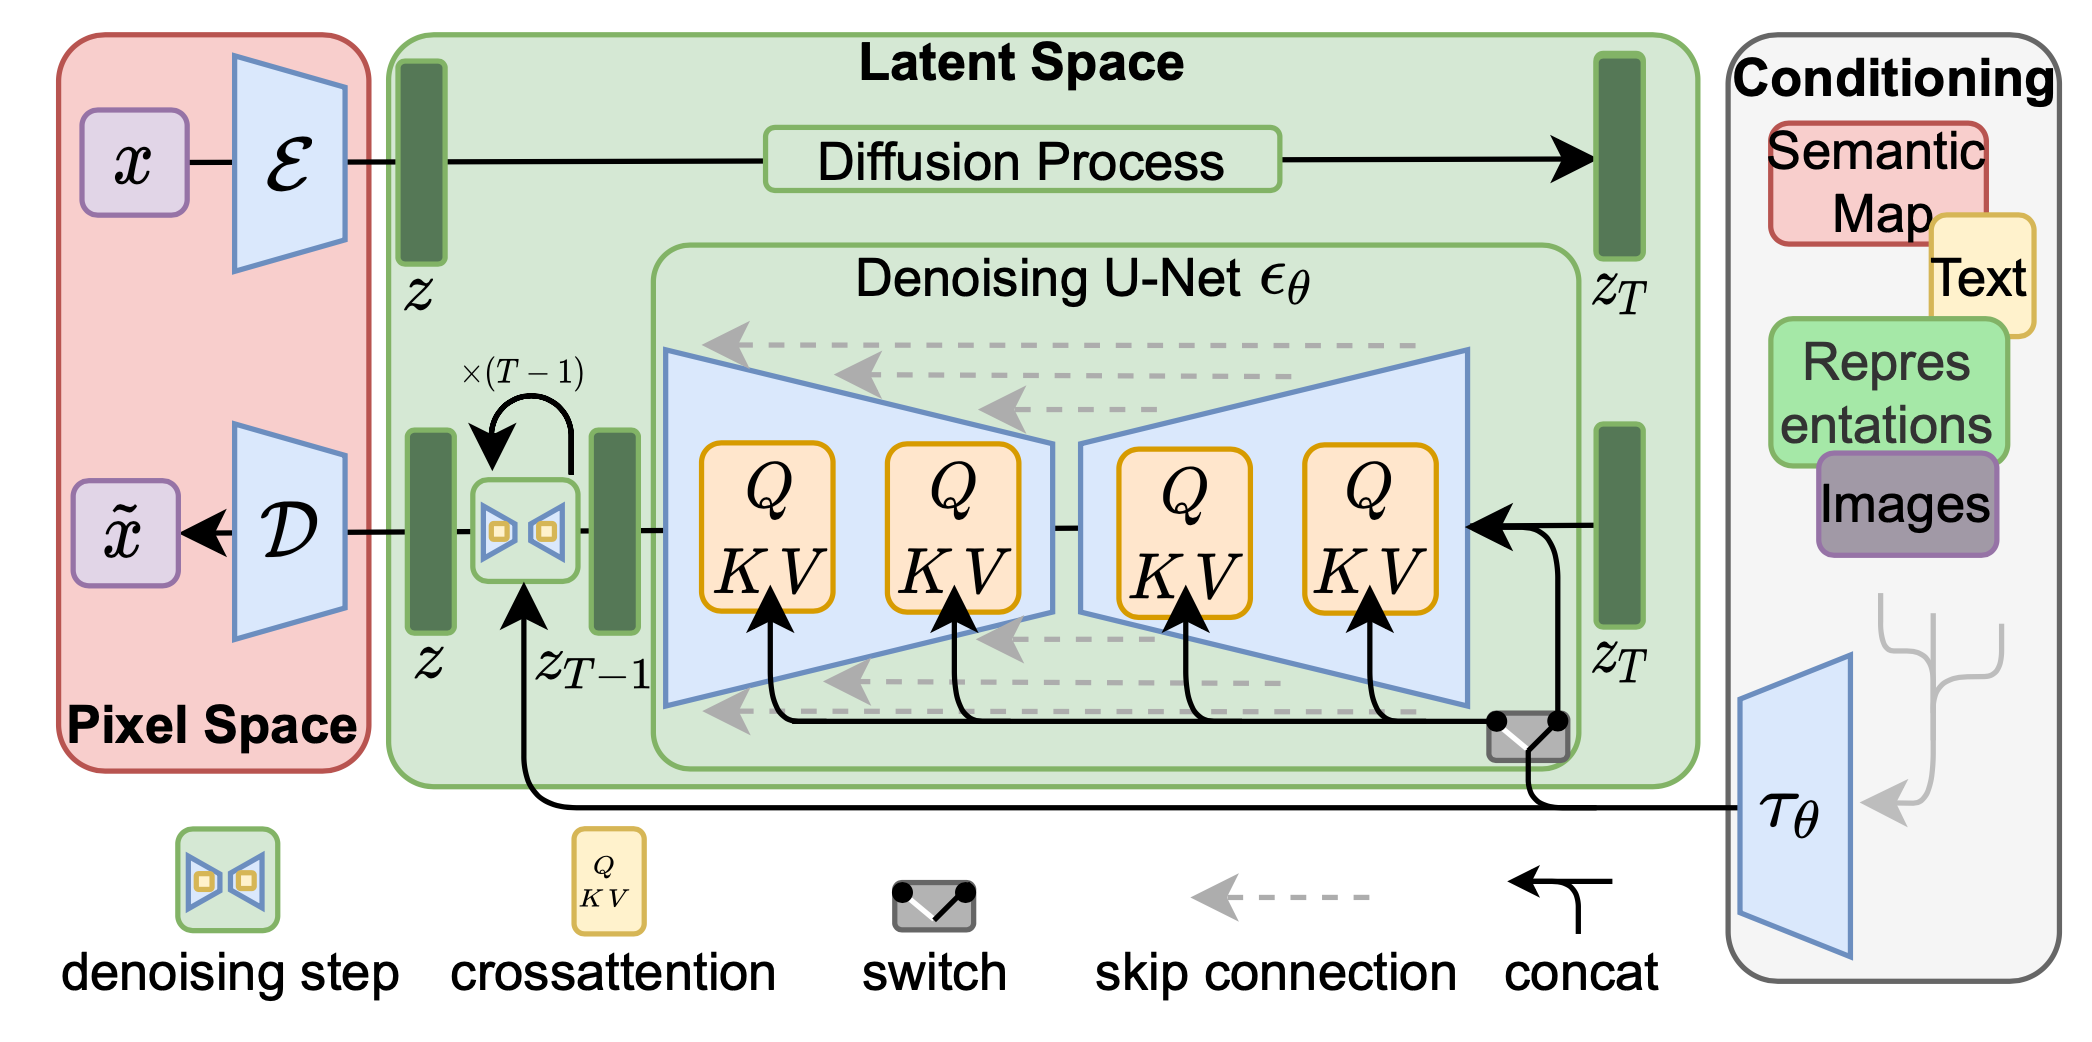
扩散模型(Diffusion Models)通过学习加噪过程的反向生成过程建模数据分布。下面以 DDPM 为例;潜空间扩散则在编码器得到的压缩表示上执行类似过程,以降低计算成本。
直觉理解:就像雕刻家的创作过程——不直接雕出成品,而是从一块大理石(纯噪声)开始,一刀一刀地精心雕刻(每步去噪),最终呈现出清晰的作品。每一步根据当前样本和生成条件做修正;结果仍取决于模型误差和采样设置。
-
核心思想:将”生成”问题转化为”去噪”问题。模型不直接学习如何从噪声一步生成图像,而是学习如何一步一步地从纯噪声中恢复出清晰图像。
-
前向扩散过程(加噪,Fixed):给定一张真实图像 \(\mathbf{x}_0\),按照预定义的噪声调度 \(\beta_1, \beta_2, \dots, \beta_T\),逐步叠加高斯噪声:
采用合适噪声调度、经过足够多步后(原始 DDPM 使用 $T=1000$),\(\mathbf{x}_T\) 近似变为纯高斯噪声 \(\mathcal{N}(0, \mathbf{I})\)。利用累积参数 \(\bar{\alpha}_t = \prod_{s=1}^t (1-\beta_s)\),可以直接从 \(\mathbf{x}_0\) 一步跳到任意时间步:
\[\mathbf{x}_t = \sqrt{\bar{\alpha}_t}\,\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\,\boldsymbol{\epsilon}\]- 反向去噪过程(生成,Learned):训练一个噪声预测网络 \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\)(可采用 U-Net 或 Transformer),学习在每个时间步 $t$ 预测所添加的噪声 \(\boldsymbol{\epsilon}\)。常用的简化噪声预测损失为(它与完整变分目标的加权方式不同):
公式解读:\(\boldsymbol{\epsilon}\) 是前向过程中实际添加的噪声,\(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) 是网络在第 $t$ 步对这个噪声的预测——训练目标就是让两者的均方误差最小。训练完成后,生成时从纯噪声 \(\mathbf{x}_T\) 出发,反复调用网络预测并去除噪声,逐步还原出清晰图像 \(\mathbf{x}_0\)。
-
条件生成与引导:
-
Classifier-Free Guidance:训练时随机丢弃条件,使同一个网络能够给出有条件和无条件预测;推理时组合两者并调节引导强度 $w$。更强引导可能增强条件符合度,也可能降低多样性或产生伪影。这是 Stable Diffusion 等文生图模型的关键技术。
-
文本条件:将文本通过 CLIP 等编码器转为向量,注入 U-Net 的交叉注意力层,实现”文字描述→图像生成”。
-
-
与 GAN/VAE 的对比:下表比较典型实现的机制,不是统一数据和预算下的质量排名。
| 维度 | GAN | VAE | 扩散模型 |
|---|---|---|---|
| 学习目标 | 生成器与判别器对抗 | 最大化 ELBO | 去噪、分数估计等目标 |
| 典型采样路径 | 噪声经生成器一次前向 | 潜变量经解码器一次前向 | 从噪声开始迭代更新 |
| 常见困难 | 对抗训练失衡、模式崩溃 | 重构与 KL 权衡、后验坍塌 | 多步推理成本、引导与多样性权衡 |
| 条件控制 | 可加入标签或其他条件 | 可构建条件 VAE | 可使用条件网络与引导 |
- 加速采样:DDIM、DPM-Solver 等可减少采样步数;训练的噪声时间步数不等于推理时网络调用次数。蒸馏也可得到少步模型,速度与质量需要一起评估。
- 应用场景:图像生成、编辑、音频合成与动作序列建模。是否适合实时任务,需测量整个系统的延迟,而不能仅由“扩散”这个名称判断。
进阶阅读:下面区分三个容易混淆的层面:用什么网络(U-Net / Transformer)、生成什么变量(图像 / 动作),以及如何组织生成过程(扩散 / 自回归)。
3.20.1 架构演进:传统 U-Net Diffusion vs DiT (Diffusion Transformer)
扩散描述生成与训练方式,U-Net / Transformer 描述网络结构,两者不是同一维度。 更换骨干不意味着一定更换目标函数;同一种 Transformer 骨干也可以使用不同生成目标。
| 维度 | U-Net 骨干 | 原始 DiT |
|---|---|---|
| 结构 | 多尺度编码器/解码器与跳跃连接,可加入注意力 | 将含噪潜变量切成 patch token,经 Transformer 处理 |
| 结构偏好 | 局部性、多尺度特征复用 | 通过注意力进行 token 交互,依赖位置与条件表示 |
| 条件注入 | 时间嵌入;文本条件模型可加入交叉注意力 | 原论文比较多种方案,主要模型使用 adaLN-Zero 注入时间与类别条件 |
| 计算关注点 | 分辨率、通道数、注意力层配置 | token 数、隐藏维度与层数;全局注意力有二次交互成本 |
| 代表 | DDPM、Stable Diffusion 1.x/2.x | DiT(Peebles & Xie, ICCV 2023) |
DiT 原论文在其 ImageNet 实验范围内观察到,增加模型计算量与更低 FID 相关。这支持该结构的扩展潜力,但不构成“任何规模、任何数据下都优于 U-Net”的定律。含注意力的 U-Net 也可以建模全局关系,不能简单把它描述成只有局部感受野。
DiT 与 Flow Matching 的区别:DiT 是架构选择;Flow Matching 通过学习连续路径上的速度场生成样本。Stable Diffusion 3 使用 Rectified Flow 与多模态 Transformer,不能直接等同于“原始 DiT + DDPM 噪声损失”。相关机制见 SD3 论文。
3.20.2 Diffusion Policy:扩散模型在机器人决策中的应用
Diffusion Policy(Chi et al., 2023)是一种模仿学习方法:从演示数据学习以观测为条件的动作分布。它本身不是通过奖励训练的强化学习算法,也不必包含语言输入。
令观测条件为 \(\mathbf{o}_t\),预测长度为 $H$,动作片段为 \(\mathbf{A}_t=(\mathbf{a}_t,\ldots,\mathbf{a}_{t+H-1})\)。训练时给演示动作加噪,并学习条件噪声预测:
\[\mathcal{L}_{\mathrm{policy}} = \mathbb{E}_{\mathbf{A}_t,\mathbf{o}_t,k,\boldsymbol{\epsilon}}\left[\left\|\boldsymbol{\epsilon}-\boldsymbol{\epsilon}_\theta(\mathbf{A}_t^{(k)},k,\mathbf{o}_t)\right\|^2\right]\]这里 $t$ 是环境时刻,$k$ 是扩散时间步,两者不能混用。推理时从动作噪声生成片段,只执行其中一部分,再根据新观测重新规划,即滚动时域控制。
- 多峰动作分布:绕障碍物可能有左、右两种合理路径。确定性 MSE 回归可能输出均值路径;条件扩散可以表达多个模式,但其他概率策略也可以建模多峰分布。
- 动作片段:联合预测多个时间步,有助于时序一致性;仍需面对模型误差、环境变化和闭环分布偏移,不能保证消除误差累积。
- 架构与成本:原始工作已经研究了卷积与 Transformer 两类实现,并非后来才引入 Transformer。控制频率还受去噪步数、视觉编码和硬件影响。
相关工作需要按目标区分:RDT-1B 使用扩散式动作建模;π₀使用 Flow Matching,并与预训练视觉语言模型结合。二者都可迭代生成连续动作,但训练目标不能混称为同一种 DDPM 去噪损失。比较性能时,还需对齐演示数据、机器人形态与任务协议。
3.20.3 扩散架构 vs 自回归架构:两种生成范式的对比
自回归(Autoregressive, AR)按条件概率分解联合分布;扩散通过多步反向过程生成样本。两者均可采用 Transformer,也均可表达多峰分布。
| 维度 | 自回归 | 扩散(以常见连续扩散为例) |
|---|---|---|
| 概率组织 | \(p(x)=\prod_i p(x_i\mid x_{<i})\) | 从噪声出发逐步更新整个样本 |
| 训练与推理 | 标准 Transformer 的 teacher forcing 训练可并行;典型采样按步骤生成 | 训练可抽样噪声时间步;采样时不同时间步顺序执行,步内位置可并行 |
| 输出长度 | 常用结束符生成变长序列 | 常预设形状或长度,也可加入长度条件、分块机制 |
| 误差来源 | 模型条件分布误差,以及训练/推理上下文差异 | 去噪预测误差、采样离散化误差与条件分布偏移 |
| 似然 | 若每个条件分布可求值,可计算序列似然 | DDPM 常使用变分界;其他形式也有不同的似然估计方法 |
| 数据类型 | 常见于离散 token,也可输出连续条件分布 | 常见于连续信号,也有离散扩散 |
| 成本因素 | 输出长度、缓存、每步网络成本与解码方式 | 去噪步数、输出尺寸、网络成本与采样器 |
因此,“自回归只适合离散数据”“扩散没有误差累积”“扩散一定比自回归快”都不是普遍结论。选型应在相近数据与预算下比较质量、覆盖度、可控性和端到端延迟。
文本扩散可参考 LLaDA;混合建模可参考 Transfusion,它在一个模型中结合文本自回归目标与图像扩散目标。这些工作展示了不同生成方式可以组合,而非必须互相替代。
4. 总结
4.1 如何选择第一个模型
先依据数据形式和任务约束建立候选,再用相同划分和指标比较。以下是起步方案,不是最终排名。
| 问题与约束 | 起步方案 | 接下来检查什么 |
|---|---|---|
| 表格回归或分类,需要容易诊断 | 正则化线性/逻辑回归,对照随机森林或梯度提升树 | 非线性交互是否重要,复杂模型的收益是否稳定 |
| 高维稀疏文本分类 | TF-IDF + 逻辑回归、线性 SVM 或朴素贝叶斯 | 错误是否来自语义与上下文不足,是否需要预训练表示 |
| 图像任务,标注量有限 | 预训练 CNN 或视觉 Transformer 的特征/微调 | 数据增强、领域差异、输入分辨率与延迟 |
| 时间序列或流式信号 | 季节性/滞后基线,再比较树模型、RNN 或其他序列网络 | 时间划分是否合理,有无未来信息泄漏 |
| 结构探索与可视化 | 标准化后比较 PCA、K-Means;t-SNE 辅助观察 | 距离度量是否合理,结构是否随设置变化 |
| 开放式语言或多模态生成 | 适合任务的预训练生成模型 | 任务准确性、条件遵循、计算成本与输出可靠性 |
| 机器人演示学习 | 简单行为克隆基线,对照动作片段或生成式策略 | 闭环成功率、恢复能力、控制频率与数据覆盖 |
4.2 阅读与实践顺序
- 先掌握实验方法:从线性/逻辑回归出发,理解损失、正则化、数据划分与评价指标。
- 再比较结构假设:用同一任务比较树、距离方法与神经网络,观察它们如何利用特征和样本。
- 最后研究预训练与生成:理解表示迁移、概率建模和条件生成,再深入 Transformer、VAE、扩散与策略学习。
深度网络的训练细节可延伸阅读《深度学习综述》;涉及奖励驱动的序列决策时,可阅读《强化学习综述》。
理解一种方法,至少要能说明它的学习信号、结构假设、优化目标与失败条件。有可信的验证设计,模型比较才有意义;有误差分析,增加数据与复杂度才有明确方向。
参考资料
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer.
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer.
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- Tibshirani, R. (1996). Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society, Series B, 58(1), 267–288.
- Quinlan, J. R. (1986). Induction of Decision Trees. Machine Learning, 1(1), 81–106. (ID3)
- Quinlan, J. R. (1993). C4.5: Programs for Machine Learning. Morgan Kaufmann.
- Breiman, L., Friedman, J., Olshen, R., & Stone, C. (1984). Classification and Regression Trees. Wadsworth. (CART)
- Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32.
- Friedman, J. H. (2001). Greedy Function Approximation: A Gradient Boosting Machine. The Annals of Statistics, 29(5), 1189–1232. (GBDT)
- Chen, T., & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. KDD 2016. arXiv:1603.02754
- Ke, G., et al. (2017). LightGBM: A Highly Efficient Gradient Boosting Decision Tree. NeurIPS 2017.
- Cover, T., & Hart, P. (1967). Nearest Neighbor Pattern Classification. IEEE Transactions on Information Theory, 13(1), 21–27. (KNN)
- Rabiner, L. R. (1989). A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition. Proceedings of the IEEE, 77(2), 257–286.
- Cortes, C., & Vapnik, V. (1995). Support-Vector Networks. Machine Learning, 20(3), 273–297.
- MacQueen, J. (1967). Some Methods for Classification and Analysis of Multivariate Observations. Proc. 5th Berkeley Symp. on Math. Statist. and Prob. (K-Means)
- Pearson, K. (1901). On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine, 2(11), 559–572. (PCA)
- van der Maaten, L., & Hinton, G. (2008). Visualizing Data using t-SNE. Journal of Machine Learning Research, 9, 2579–2605.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning Representations by Back-Propagating Errors. Nature, 323(6088), 533–536.
- Hornik, K., Stinchcombe, M., & White, H. (1989). Multilayer Feedforward Networks are Universal Approximators. Neural Networks, 2(5), 359–366.
- Kingma, D. P., & Ba, J. (2015). Adam: A Method for Stochastic Optimization. ICLR 2015. arXiv:1412.6980
- LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-Based Learning Applied to Document Recognition. Proceedings of the IEEE, 86(11), 2278–2324. (LeNet-5)
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet Classification with Deep Convolutional Neural Networks. NeurIPS 2012. (AlexNet)
- Simonyan, K., & Zisserman, A. (2015). Very Deep Convolutional Networks for Large-Scale Image Recognition. ICLR 2015. arXiv:1409.1556 (VGG)
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. CVPR 2016. arXiv:1512.03385 (ResNet)
- Hochreiter, S., & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation, 9(8), 1735–1780.
- Cho, K., et al. (2014). Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation. EMNLP 2014. arXiv:1406.1078 (GRU)
- Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS 2017. arXiv:1706.03762
- Su, J., et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding. arXiv:2104.09864 (RoPE)
- Press, O., Smith, N. A., & Lewis, M. (2022). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation. ICLR 2022. (ALiBi)
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019. arXiv:1810.04805
- Liu, Y., et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach. arXiv:1907.11692
- Lan, Z., et al. (2020). ALBERT: A Lite BERT for Self-supervised Learning of Language Representations. ICLR 2020.
- He, P., et al. (2021). DeBERTa: Decoding-Enhanced BERT with Disentangled Attention. ICLR 2021.
- Radford, A., et al. (2018). Improving Language Understanding by Generative Pre-Training. OpenAI Tech Report. (GPT-1)
- Radford, A., et al. (2019). Language Models are Unsupervised Multitask Learners. OpenAI Tech Report. (GPT-2)
- Brown, T. B., et al. (2020). Language Models are Few-Shot Learners. NeurIPS 2020. arXiv:2005.14165 (GPT-3)
- OpenAI. (2023). GPT-4 Technical Report. arXiv:2303.08774
- Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361
- Wei, J., et al. (2022). Emergent Abilities of Large Language Models. TMLR 2022. arXiv:2206.07682
- Wei, J., et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022. arXiv:2201.11903
- Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback. NeurIPS 2022. arXiv:2203.02155 (InstructGPT / RLHF)
- Rafailov, R., et al. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023. arXiv:2305.18290 (DPO)
- Goodfellow, I., et al. (2014). Generative Adversarial Nets. NeurIPS 2014. arXiv:1406.2661
- Arjovsky, M., Chintala, S., & Bottou, L. (2017). Wasserstein GAN. ICML 2017. arXiv:1701.07875
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks. CVPR 2019. (StyleGAN)
- Zhu, J. Y., et al. (2017). Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks. ICCV 2017. (CycleGAN)
- Vincent, P., et al. (2008). Extracting and Composing Robust Features with Denoising Autoencoders. ICML 2008.
- Kingma, D. P., & Welling, M. (2014). Auto-Encoding Variational Bayes. ICLR 2014. arXiv:1312.6114 (VAE)
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. NeurIPS 2020. arXiv:2006.11239 (DDPM)
- Song, J., Meng, C., & Ermon, S. (2021). Denoising Diffusion Implicit Models. ICLR 2021. arXiv:2010.02502 (DDIM)
- Lu, C., et al. (2022). DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling. NeurIPS 2022.
- Ho, J., & Salimans, T. (2022). Classifier-Free Diffusion Guidance. arXiv:2207.12598
- Rombach, R., et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. CVPR 2022. arXiv:2112.10752 (Stable Diffusion)
- Ramesh, A., et al. (2022). Hierarchical Text-Conditional Image Generation with CLIP Latents. arXiv:2204.06125 (DALL-E 2)
- Peebles, W., & Xie, S. (2023). Scalable Diffusion Models with Transformers. ICCV 2023. arXiv:2212.09748 (DiT)
- Brooks, T., et al. (2024). Video Generation Models as World Simulators. OpenAI Tech Report. (Sora)
- Chen, J., et al. (2024). PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis. ICLR 2024.
- Esser, P., et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis. ICML 2024. arXiv:2403.03206 (Stable Diffusion 3)
- Chi, C., et al. (2023). Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. RSS 2023. arXiv:2303.04137
- Ze, Y., et al. (2024). 3D Diffusion Policy. RSS 2024.
- Liu, S., et al. (2024). RDT-1B: A Diffusion Foundation Model for Bimanual Manipulation. arXiv:2410.07864
- Black, K., et al. (2024). π₀: A Vision-Language-Action Flow Model for General Robot Control. Physical Intelligence. arXiv:2410.24164
- Octo Model Team. (2024). Octo: An Open-Source Generalist Robot Policy. RSS 2024.
- Kim, M. J., et al. (2024). OpenVLA: An Open-Source Vision-Language-Action Model. arXiv:2406.09246
- Tian, K., et al. (2024). Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction. NeurIPS 2024. (VAR)
- Zhou, C., et al. (2024). Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model. arXiv:2408.11039
- Nie, S., et al. (2025). Large Language Diffusion Models. arXiv:2502.09992 (LLaDA)
- Deng, J., et al. (2009). ImageNet: A Large-Scale Hierarchical Image Database. CVPR 2009.
- Lin, T. Y., et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
- Wang, A., et al. (2019). GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding. ICLR 2019.
- Pedregosa, F., et al. (2011). Scikit-learn: Machine Learning in Python. JMLR, 12, 2825–2830.
- Abadi, M., et al. (2016). TensorFlow: Large-Scale Machine Learning on Heterogeneous Distributed Systems. arXiv:1603.04467
- Paszke, A., et al. (2019). PyTorch: An Imperative Style, High-Performance Deep Learning Library. NeurIPS 2019.
- Wolf, T., et al. (2020). Transformers: State-of-the-Art Natural Language Processing. EMNLP 2020 (System Demos). (HuggingFace)
- Jumper, J., et al. (2021). Highly Accurate Protein Structure Prediction with AlphaFold. Nature, 596, 583–589.
- Silver, D., et al. (2016). Mastering the Game of Go with Deep Neural Networks and Tree Search. Nature, 529, 484–489. (AlphaGo)
- Mnih, V., et al. (2015). Human-Level Control through Deep Reinforcement Learning. Nature, 518, 529–533. (DQN)
- Schulman, J., et al. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347 (PPO)
-
Haarnoja, T., et al. (2018). Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor. ICML 2018. (SAC)
- Scikit-learn developers. Common pitfalls and recommended practices;Cross-validation;Metrics and scoring.
- Schaeffer, R., Miranda, B., & Koyejo, S. (2023). Are Emergent Abilities of Large Language Models a Mirage? NeurIPS 2023. arXiv:2304.15004
阅读提示:配图用于辅助理解;具体算法定义、训练设置与实验结论请以对应原论文为准。