本期数字:新增 102 篇 / 102 项独立工作 · 主线:VLN 9 篇 / 具身 Agentic 导航 9 篇 · 其他方向 84 篇 · 公众号 0 条 · 另更新已有论文 1 篇
一、本期要点
- 记忆维护开始覆盖“保留、清空、反思”三个环节。 时空记忆组织历史证据,MOON处理偏航后的历史惯性,RetroNav把失败解释连回场景记录。
- 规划与执行的接口进入训练目标。 MATCH联合优化航点请求和原子动作执行;同批出现的语义安全评测也把“识别风险”和“改变运动”分开检查。
- 主动求助进入终身导航框架。 EvoLife将交互、动作工具和地点记忆接在一起,其结果同时依赖引导条件;首访、重访和连续任务需要分别阅读。
二、精读
1. MOON
偏航恢复需要判断何时清空历史。
论文 · 主线:VLN · 指令跟随 · R2R-CE / RxR-CE(连续环境)
问题。 历史既帮助跟随路线,也可能在走错后维持原来的动作惯性。
方法。 冻结基础策略,用偏航判别器触发历史清空,再由经 GRPO 训练的恢复策略接管;新增参数不足基础策略的 1%。
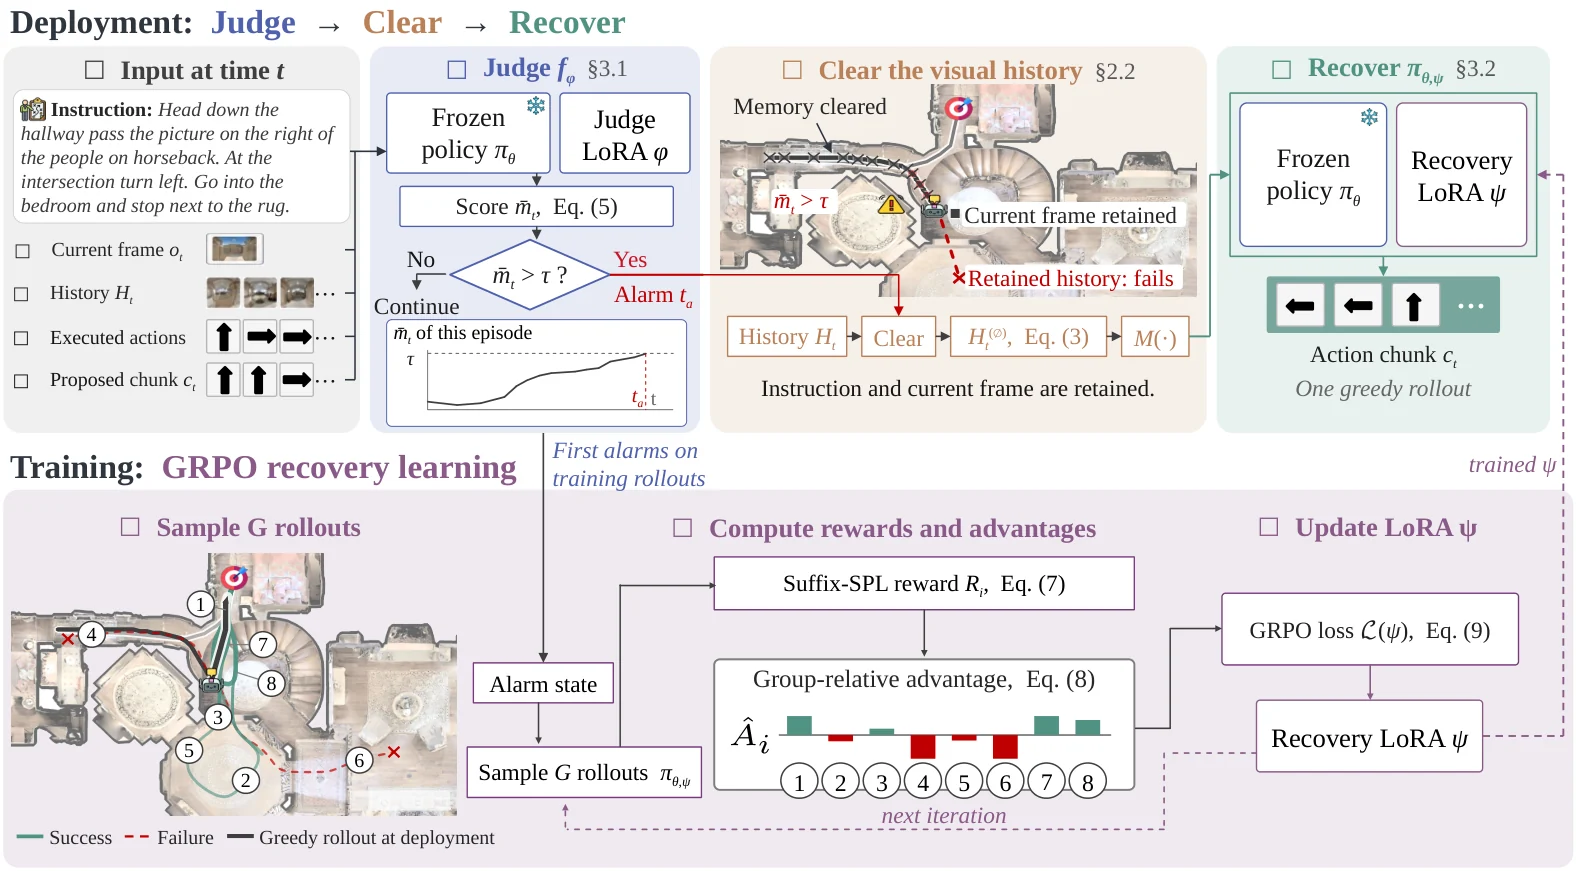
证据。 摘要报告 R2R-CE、RxR-CE 的 SR 相对冻结基础策略分别提高 5.2、6.0 个百分点;随机触发消融支持清空时机的重要性。
判断。 适合拆分记忆错误与动作错误。清空会损害仍在正确路线上的回合,应同时检查误报警与恢复收益;摘要未给真机结果。
下一步。 复现:在同一偏航状态比较保留历史、定时清空、判别器触发与恢复策略。
2. MATCH
规划目标应随执行器能力共同调整。
论文 · 主线:VLN · 分层规划与执行 · R2R-CE / RxR-CE(连续环境)
问题。 只训练规划器、固定执行器,会持续提出实际难以完成的航点请求。
方法。 执行感知拓扑图结合价值估计与结果记忆,允许连续微调目标;奖励平衡按序路线进展和执行残差,两级策略同步更新。
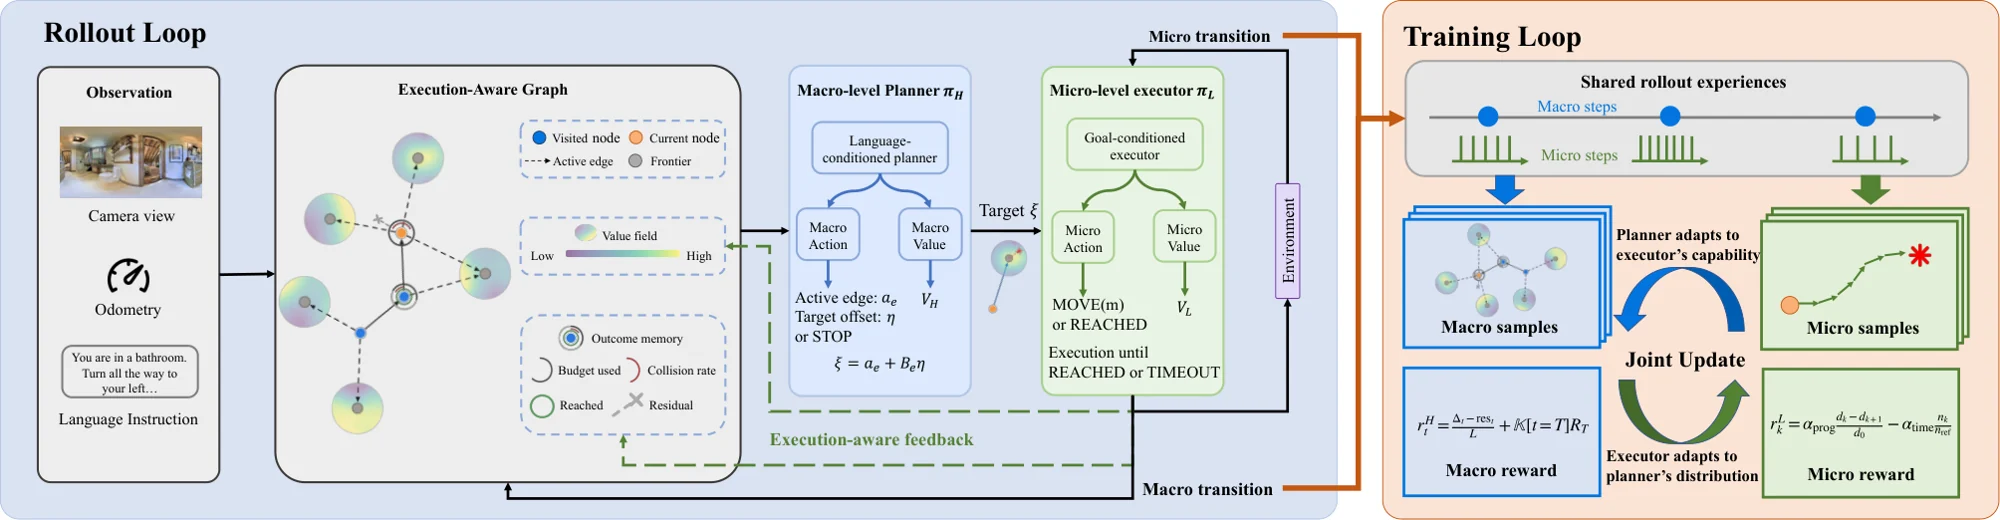
证据。 摘要无数值,只称 0.5B 模型在 R2R-CE / RxR-CE 取得领先结果;原文真机展示仅 4 个回合。
判断。 适合研究航点是否可执行,同时保留指令约束。4 个真机回合不足以说明部署稳定性;局部到达率也不能替代整条指令完成。
下一步。 精读:核对碰撞设置,分离目标偏移、联合训练与路线奖励的作用。
3. EvoLife
把主动求助与位置记忆接进导航闭环。
论文 · 主线:具身 Agentic 导航 · 交互导航 / ObjectNav / 连续多任务
问题。 移动、澄清意图和保存经验分离时,一次交互所得的信息很难在后续任务复用。
方法。 统一运行框架提供航点、离散、像素与物体导航工具,将问答及观测绑定到地点,供后续访问检索与修订。
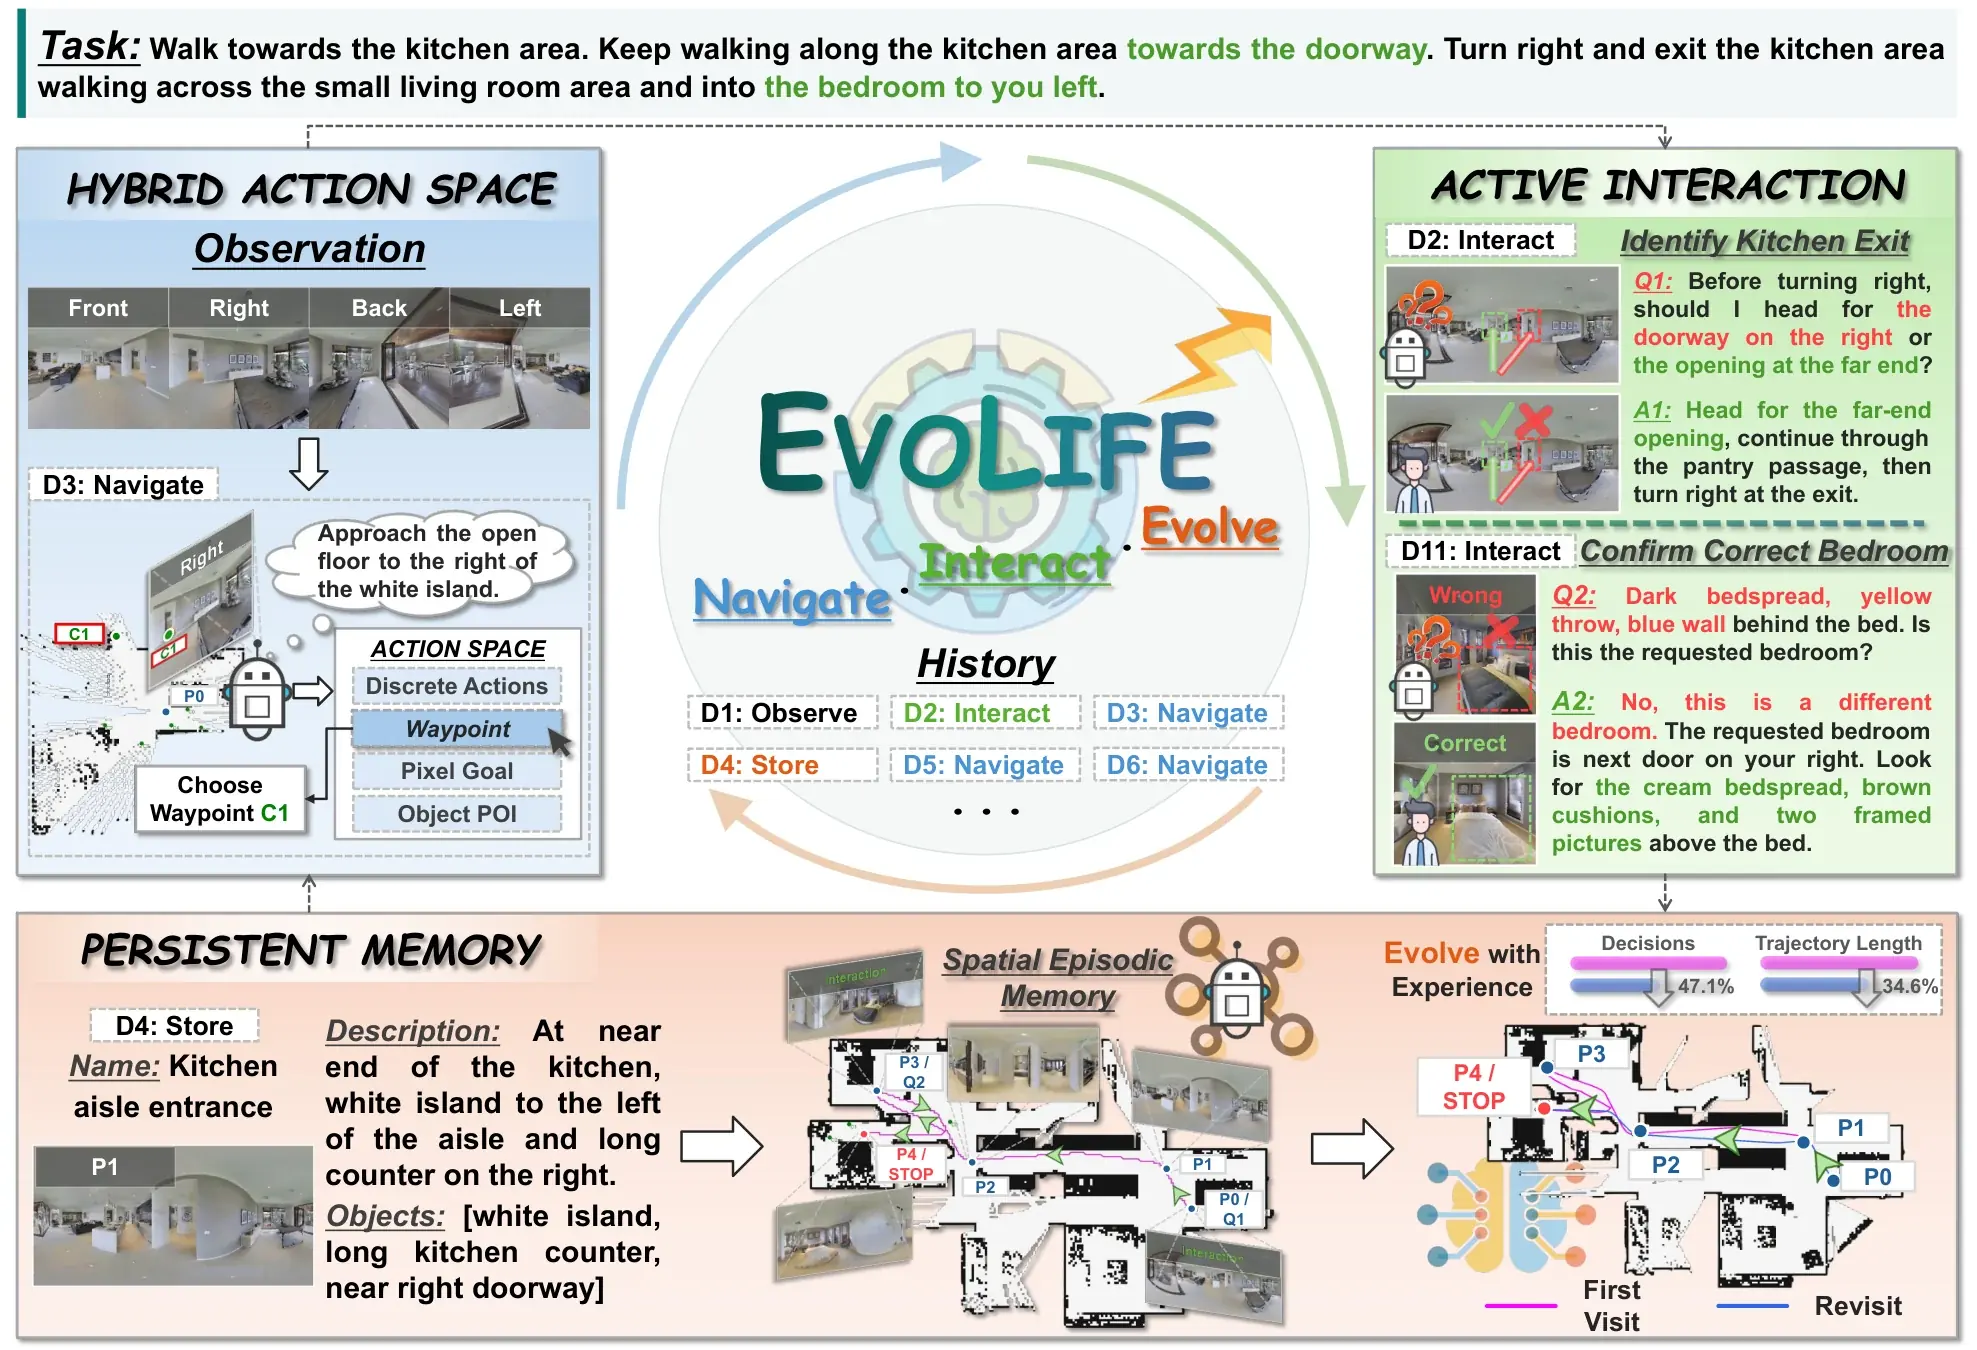
证据。 摘要报告四组各 100 回合的 VLN / ObjectNav 首访 SR 为 100%,平均每回合主动交互 1.87 次;各 50 序列的 LHPR-VLN、GOAT-Bench 完整序列 SR 为 98%、94%。
判断。 这是带求助的系统结果。原文仿真引导端可见特权路线与目标信息,不能与无帮助 VLN 等同;仍需评估现实求助成本及错误回答的影响。
下一步。 精读:固定导航器与交互预算,对读无引导、受限引导和完整引导。
4. RetroNav
失败反思需要连回可核验的场景证据。
论文 · 主线:具身 Agentic 导航 · 终身导航 / 多次尝试
问题。 只保存场景知识,难以解释历史决策为何失败,以及重试时应改变什么。
方法。 统一记忆关联几何、语义与导航经历,并区分客观观测和任务解释;独立评价器决定重试,反思 Agent 生成有证据支持的重试简报。
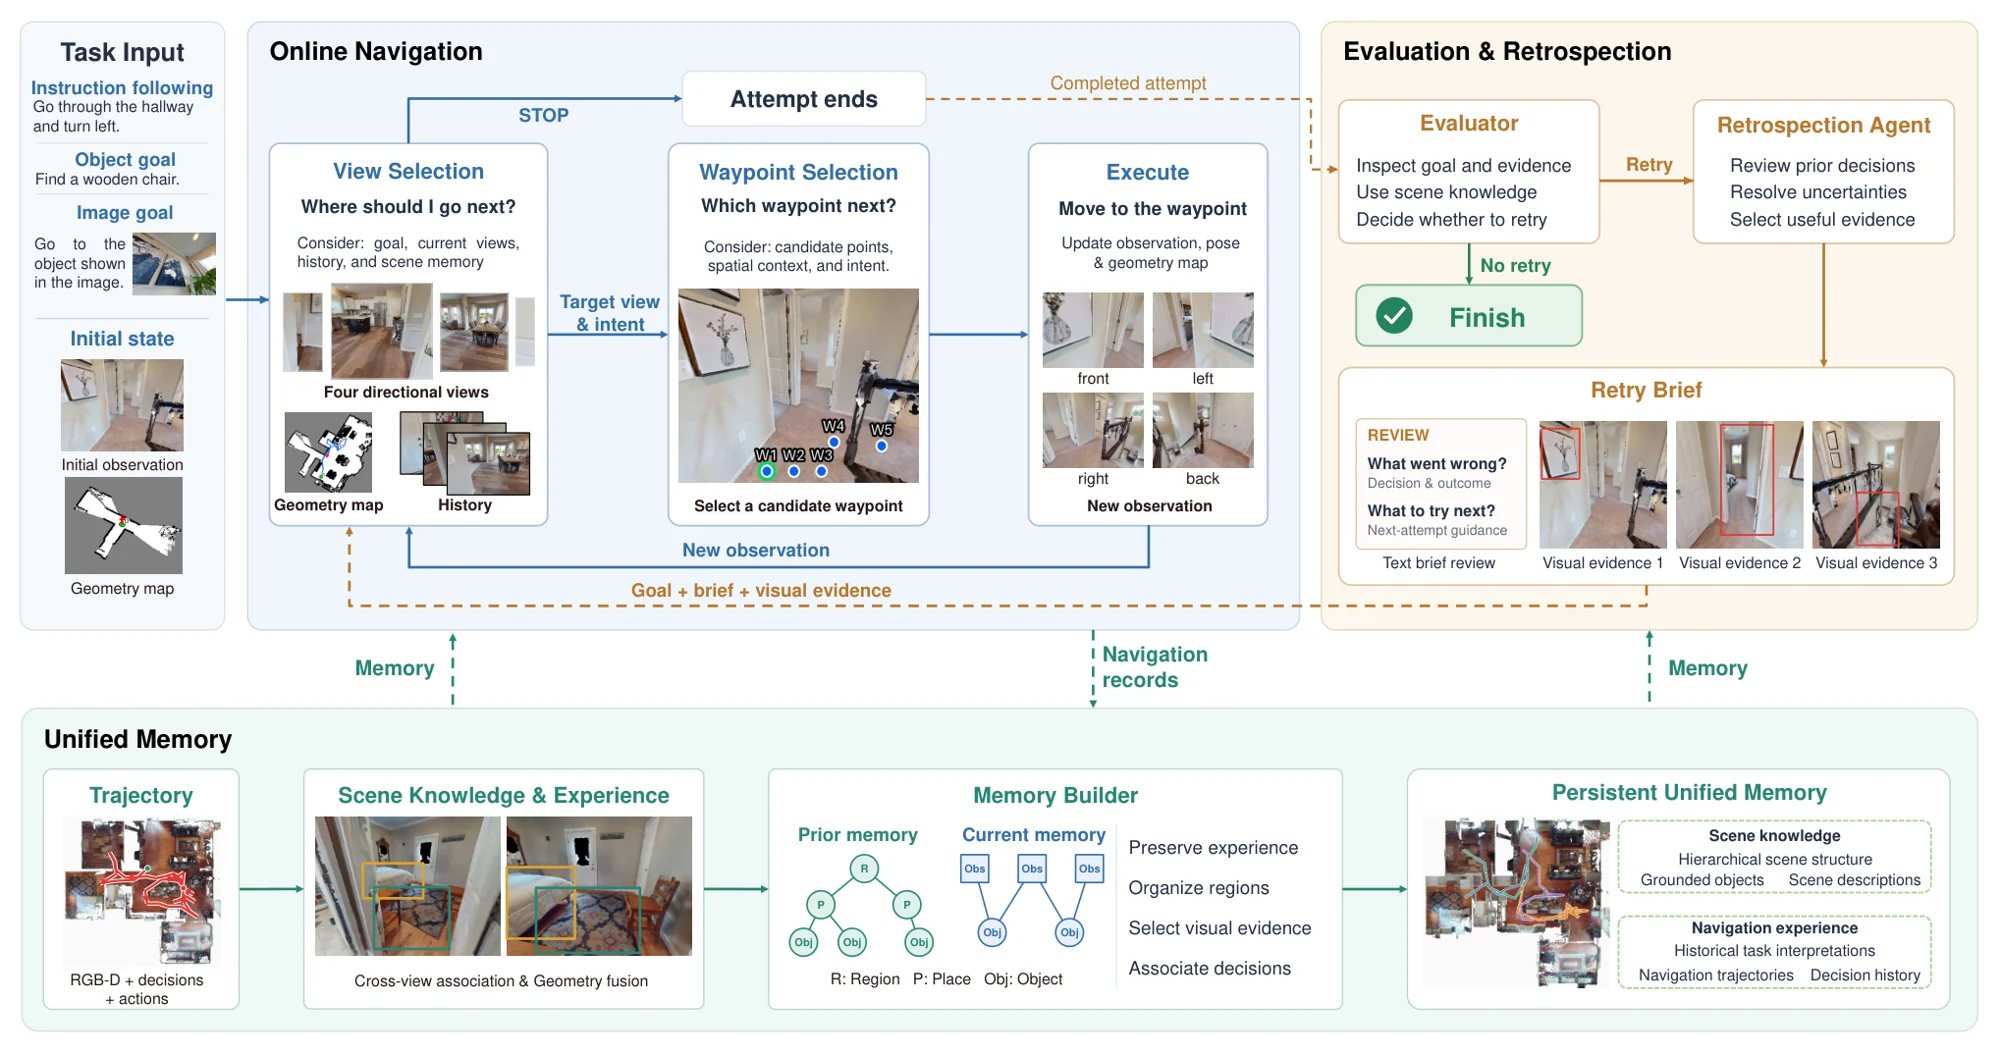
证据。 摘要无数值,只称在五个导航基准取得领先表现。
判断。 适合检查反思是否引用真实证据。多次尝试增加了信息与预算,应同时统计首试成功、重试恢复和累计路径及调用成本。
下一步。 复现:相同重试预算下比较盲目重试、只读场景记忆和证据化简报。
5. 时空记忆
记忆要同时支持任务进度、历史取证和几何执行。
论文 · 主线:具身 Agentic 导航 · 零样本 VLN · R2R-CE val-unseen(连续环境)
问题。 保留历史不代表推理器能读懂它;仅凭当前视图也容易重复探索。
方法。 任务记忆保存进度,时间记忆压缩带位姿的观测,空间记忆累积几何;8B 观察器与 8B 推理器协作,选择航点或请求补充视角,再由几何控制器执行。
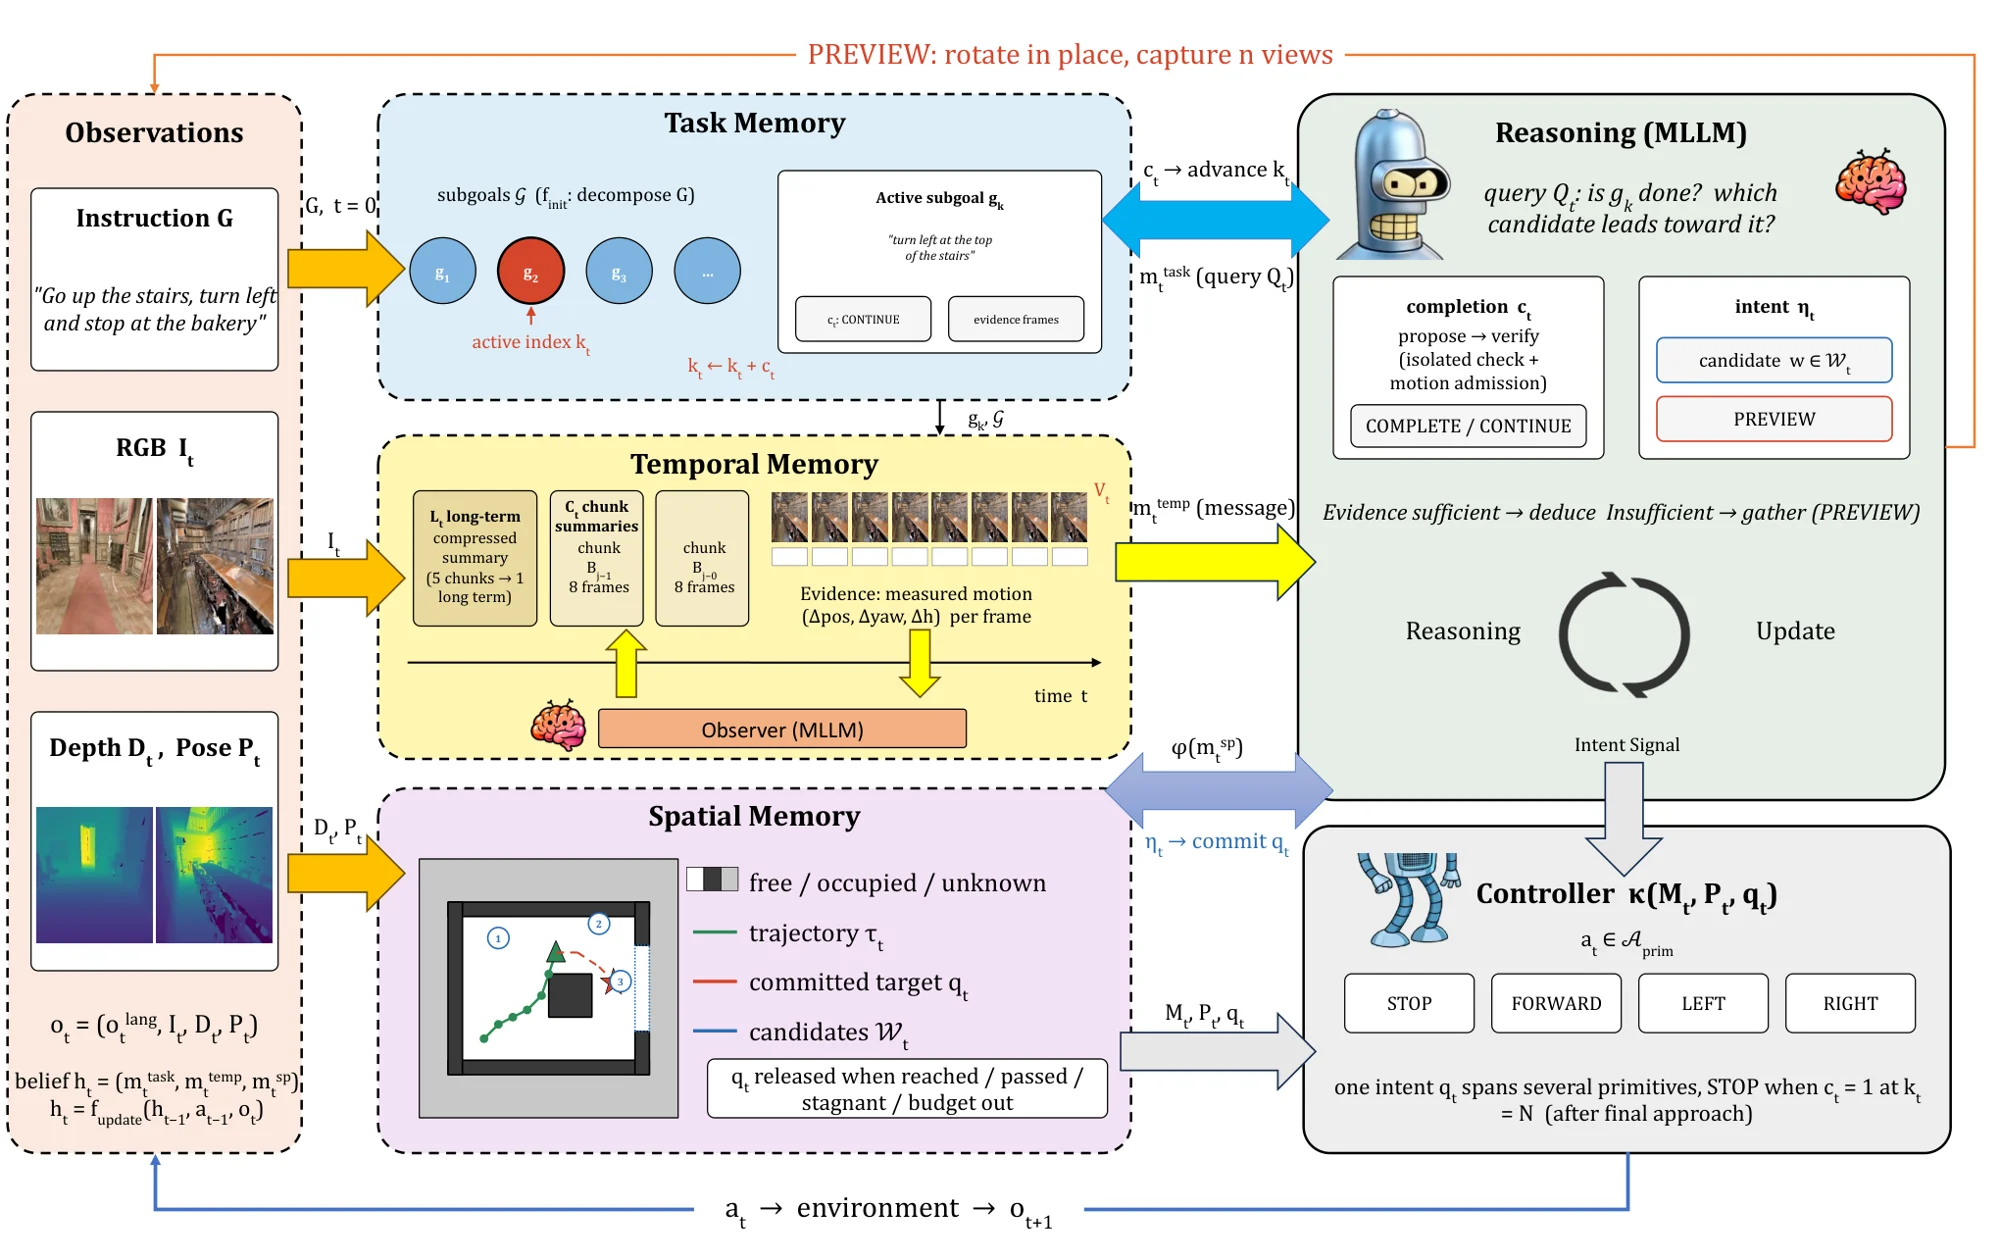
证据。 摘要报告 R2R-CE val-unseen 消融中,去除时间记忆使平均路径由 16.9 m 增至 39.1 m;未给 SR 数值。
判断。 路径效率值得跟踪,但不能把整个系统压成单个“8B 模型”。原文真机依赖远程 A100 与预建图定位,尚不能说明纯机载、无先验地图部署能力。
下一步。 精读:对齐定位和动作接口,再比较路径、SR、词元及补充观察成本。
三、也值得一看
- RepresentNav · VLN:自建视觉表征与潜空间预测;摘要报告 VLNVerse 细粒度任务 SR 83.80%。
- One Scan is Enough · VLN:单次扫描合成训练环境;摘要报告五个真机场景 SR 85%,同楼未扫描区域 82%。
- MEMVLN · VLN:有界情节记忆与路线重建训练;真机仅六条留出指令,需核对重复试验口径。
- ASPEN · VLN:事件触发语义推理;RxR-CE val-unseen 的模型调用减少 9.5%,估计推理时间减少 8.1%。
- Natural-Language to Nav2 · Agentic 导航:语言编译为 JSON 策略,经确定性检查后投影到 Nav2 代价地图。
- PIFR · Agentic 导航:PIFR 分开评估插入任务完成、原任务恢复与整段序列完成。
- HGWM · Agentic 导航:房间—物体先验与持久图记忆配合图匹配;HM3D v0.1 SR 62.6%、SPL 31.5%。
- ThinkLocoManip · Agentic 导航:足式移动操作框架编排导航、运动与操作工具,以关键帧保留恢复上下文。
- VISTA · 可迁移机制:主动生成新回合验证框架修改,可借鉴到导航反思后的再测试。
- LOGIV · 可迁移机制:持续核验任务依赖并局部修复,可借鉴到导航子目标的前置条件维护。
四、趋势与行动
趋势
- 记忆的收益取决于使用时机与证据组织。 MOON、RetroNav与时空记忆分别覆盖清空、反思和检索,适合在共同预算下对读,而非简单比较缓存长度。
- 导航框架需要为执行、求助和恢复分别记账。 MATCH约束执行请求,EvoLife引入外部指导,PIFR 处理运行时中断;最终到达率不能独自解释各环节的贡献。
研究空白
- 缺少同时固定动作接口、历史预算、模型调用和重试次数的导航恢复评测,难以分离策略变强与系统获得更多机会。
- 带特权信息的引导、远程推理及预建图定位,与普通地面机器人部署条件仍有距离,需要逐项移除后检验能力边界。
下一步
- 高 · 复现 MOON:建立同状态偏航干预集,同时记录误报警、恢复 SR 与累计路径。
- 高 · 精读 EvoLife:列清引导端可见信息,复核无引导与受限引导条件,再判断哪些收益可迁移。
- 中 · 对照 MATCH:固定执行器和接触设置,比较只调目标、只训练执行器与联合训练。
- 中 · 原型 Natural-Language to Nav2:从禁行区与事件通行策略做起,分别统计解析错误、错误接受和执行偏差。
- 低 · 跟踪 RetroNav与时空记忆:等预算测首试、重试及词元成本,暂缓仅凭最终 SR 排序。
五、全部工作索引
以下覆盖全部 102 项新增独立工作;A 为两条主线,B 为可迁移机制,C 为领域观察,精读工作链接回对应卡片。
VLN 与语义导航 · A · 9 篇
- RepresentNav:策略自建视觉表征并预测未来潜状态。
- MOON:见精读。
- One Scan is Enough:扫描重建场景,自动合成指令与训练任务。
- Stage-Aware Attribution:按指令阶段汇聚当前及历史视觉归因。
- ScheNav:粗略示意图与观测融合为探索价值场。
- ASPEN:预测命令持续性,按需重新调用语义模型。
- OSMA-Bench:按障碍语义检验间距、速度和运动平滑性。
- MEMVLN:有界情节记忆配合掩码路线重建。
- MATCH:见精读。
具身 Agentic 导航 · A · 9 篇
- HGWM:房间—物体先验与持久图记忆引导找物。
- Natural-Language to Nav2:确定性验证语言策略,再接入 Nav2 代价地图。
- ThinkLocoManip:编排移动、导航与操作工具,关键帧支持恢复。
- OmniBrain-0:蒸馏导航与操作专家,统一高层决策模型。
- PIFR:分开评测任务抢占、插入执行与恢复。
- RetroNav:见精读。
- Spatiotemporal Memory:见精读。
- EvoLife:见精读。
- LLM-Guided Loco-Manipulation:按技能、对象与几何目标编排交互导航。
可迁移机制 · B · 19 篇
- ASTEROID:用学生自身历史训练探索,可借鉴部分可观测决策。
- FP32 Master Copy:审计低精度更新丢失,可借鉴导航策略微调检查。
- Horizon–Depth Coupling:联合考察求解深度与开环执行长度。
- SceneBloom:生成物理有效室内布局,支持 ObjectNav 训练。
- TrajMamba:统一训练与部署的人体轨迹预处理链。
- Interaction-Aware GNN:图网络修正航点,利用行人及目标上下文。
- LegoOcc++:开放词汇占据保持跨视角实例语义一致。
- RoboDuo:检查整任务完成后调用原子技能恢复。
- FISRF:按能力选择反思与导师指导策略。
- EBench Agent Profiling:比较直接控制与调用策略后的框架协同。
- RobotAgentBench:以任务发现、执行与恢复衡量机器人自主性。
- The Trinity:能力树组织可验证环境与框架迭代。
- TP-JSCC:压缩并传输 3D 问答视觉词元。
- VISTA:主动探索验证修改,保留框架版本谱系。
- LSMM:位置索引矩阵记忆支持足式迷宫探索。
- AtomTree:按当前符号状态分解子目标并分层回溯。
- Object Motion Anticipation:在线适配新物体的运动启动预测。
- EmbodiExp:用适用条件与可核验结果组合子目标经验。
- LOGIV:持续核验任务依赖并约束局部修复。
VLA / 操作 · C · 43 篇
- 示范、数据、技能与仿真(16):EgoForesight、MAST-VLA、Learned Speed Prior、EXE、Speech Conditioning、Dexterous Manipulation Survey、TAD、HuGe、RynnVLA-Latent、Robot-Aligned 3DGS、Self-Labeled Preference Transfer、Tokens of Motion、BURGER、Gym-Anything for Robotics、DEED、TouchBridge
- 记忆、世界表征与动作生成(11):CogMemory、PDRVLA、Retrieve to Act、ThinkWorld、JAM、World Dreamer v5-lite、SaiVLA-JEPA、CoRAct、HiFOR、PRIME W0、Smooth Action Chunking
- 量化、推理与机载硬件(6):AGQ、PoT-LIF、TRIAGE、JevVLA、VLA-HWBench、QbD-VLA
- 鲁棒性、安全与评测(9):VLA Failure Features、Backtrack、RobustRLlib、Federated VLA Safety、MART-GRPO、Stimulus–Response Safety、VLA-Stem、BEHAVIOR-1K Inference Settings、RoboSeed
- 移动操作实践(1):Tabletop to Walking Bot
飞行、控制与其他 · C · 22 篇
- 飞行与水下(6):AirPlayground、SP-Guide、Quadrotor Trajectory Control、Omni-IGN、Embodied at Sea、OpenFlyV2
- 几何、控制、定位与驾驶(6):Continuous-Time Safe Planning、LECO、SG²SLAM、Geomagnetic Gradient Flow、Value-Guided MPPI、CoC-CFG
- 实验室、通用 Agent 与其他(10):VERID、Whale You Go Green?、Patchwork、EMMA、Intrinsic Goals / Drosophila、Language to Drives、LongChang、Auditable Self-Driving Labs、MCP-Net、Live iOS Navigation