引言
大语言模型(Large Language Model, LLM)的兴起标志着人工智能进入了新的发展阶段。从2018年BERT和GPT的出现,到2020年GPT-3展现出令人惊讶的少样本学习能力,再到2022年ChatGPT引爆全球对话式AI浪潮,大模型在短短几年间实现了质的飞跃。这些模型不仅在传统NLP任务上达到了接近人类的水平,更展现出了代码生成、数学推理、创意写作等广泛的能力。
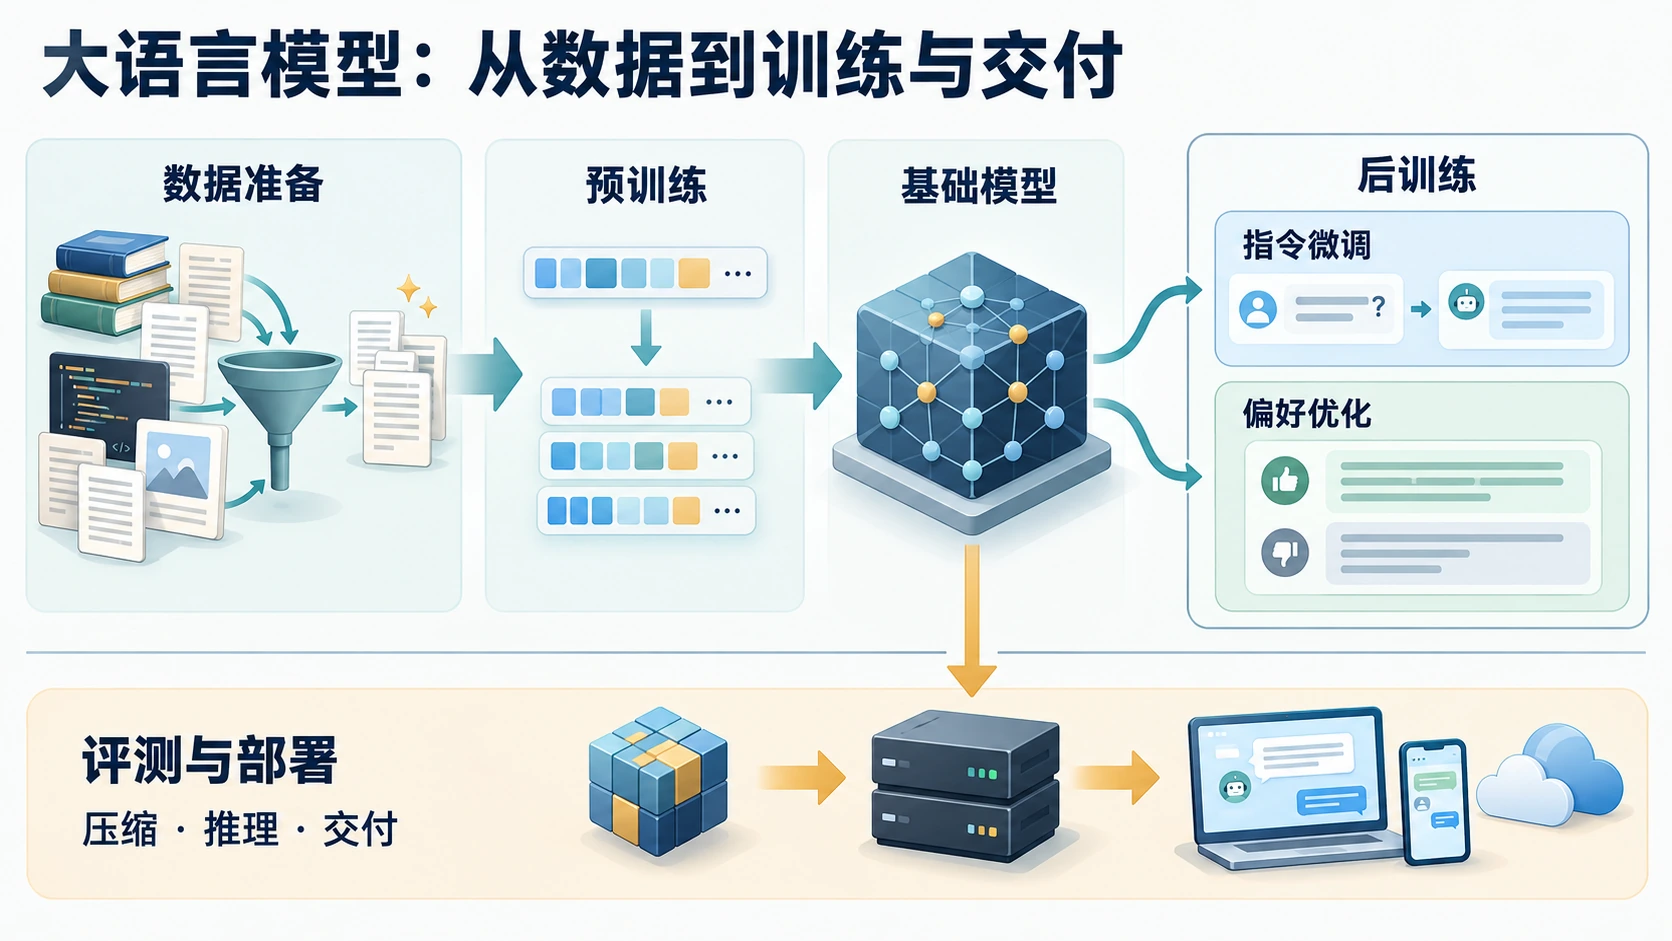
🎯 为什么关注大模型训练?
训练是大模型能力的来源。一个高性能大模型的诞生,离不开:
- 📊 海量高质量数据:数万亿token的精心处理
- 💰 大规模计算资源:数千GPU并行训练数月
- 🧠 精巧的训练策略:从预训练到对齐的完整pipeline
- ⚙️ 工程化的实现:分布式训练、内存优化、稳定性保证
然而,大模型训练的知识和技术往往分散在各类论文、博客和代码库中,缺乏系统性的整理。本文旨在填补这一空白。
📚 本文内容
本综述系统梳理大模型训练的核心技术,包括:
- 🏗️ 大模型训练基础概述:大模型训练概念、演进历程与核心组成
- 🌀 预训练阶段:目标函数、数据源与配比、核心参数策略与 MoE 架构
- 🎯 监督微调阶段:SFT 训练目标、数据来源与前沿合成及质量清洗技术
- 🤝 偏好对齐阶段:RLHF、DPO 与 GRPO 算法原理及推理模型训练范式
- 🔁 Post-Training 与灾难性遗忘:持续学习中的遗忘机理与防遗忘策略
- 🔀 分布式训练技术:数据/张量/流水线并行、序列并行与 ZeRO 状态分片
- ⚡ 训练优化技术:主流优化器对比、学习率策略与 Flash Attention
- 📉 模型量化技术:PTQ 与 QLoRA 低比特微调,不同格式精度/性能权衡
- 🗂️ 数据工程:数据采集、清洗、去重与配比最佳实践
- 📈 评估与基准测试:知识、推理、代码、长文本及安全性评估
- 🚀 实践指南与最佳实践:算力估算、训练监控、OOM 调试与断点恢复
- 💬 常见问题 (FAQ):训练常见异常、微调与对齐实践答疑
- 👁️ 迈向多模态与智能体:VLM 视觉-语言融合架构、两阶段训练流程与 Agent 工具调用训练
- 📚 参考资源:经典论文、核心开源项目与大模型学习路径
👥 目标读者
- 🔬 研究人员:了解大模型训练的完整技术栈
- 👨💻 工程师:掌握实际训练中的工程实践和优化技巧
- 🎓 学生:建立对大模型训练的系统性认知
- 💼 从业者:跟踪最新技术进展和行业动态
💡 阅读说明
本文力求在理论深度和实践指导之间取得平衡,既阐述核心原理,也给出代码示例和工程方案。代码以说明原理为主,部分为省略了数据加载等细节的示意代码;文中的成本、显存、精度等数字多为量级估算,受模型版本、硬件与评测协议影响,复现时请以原论文或官方文档为准。
📖 快速导航
本文共分为 14 个主要章节,建议根据需求选择性阅读:
| 章节 | 内容 | 适合读者 | 阅读时间 |
|---|---|---|---|
| 1. 基础概述 | 大模型训练概念、演进历程 | 所有读者 | 10分钟 |
| 2. 预训练阶段 | 目标函数、数据源、核心参数与MoE | 所有读者 ⭐必读 | 30分钟 |
| 3. 监督微调阶段 | SFT训练目标、数据构建、合成与过滤 | 所有读者 ⭐必读 | 15分钟 |
| 4. 偏好对齐阶段 | RLHF、DPO、GRPO与推理模型RL对齐 | 所有读者 ⭐必读 | 15分钟 |
| 5. Post-Training与遗忘 | 灾难性遗忘、经验回放与Self-Output | 工程师、研究者 ⭐推荐 | 15分钟 |
| 6. 分布式训练 | DP/TP/PP/ZeRO等并行技术 | 工程师、研究者 | 20分钟 |
| 7. 训练优化 | 优化器、学习率、Flash Attention | 工程师 | 15分钟 |
| 8. 模型量化 | GPTQ/AWQ量化与QLoRA低比特微调 | 工程师、研究者 ⭐推荐 | 20分钟 |
| 9. 数据工程 | 数据采集、清洗、去重与配比 | 工程师、研究者 | 25分钟 |
| 10. 评估基准 | MMLU、GSM8K等评测体系 | 研究者、从业者 | 15分钟 |
| 11. 实践指南 | 硬件配置、成本估算、监控与断点恢复 | 工程师 ⭐必读 | 30分钟 |
| 12. 常见问题 | 常见训练异常与微调/对齐问题答疑 | 所有读者 ⭐推荐 | 20分钟 |
| 13. VLM与Agent | 视觉语言模型架构、两阶段融合训练与Agent工具调用训练 | 工程师、研究者 | 20分钟 |
| 14. 参考资源 | 经典论文、标杆开源项目与学习路径 | 所有读者 | 15分钟 |
💡 阅读建议
- 初学者:重点阅读”1. 基础概述” → “2. 预训练 / 3. SFT / 4. 对齐阶段” → “12. 常见问题”
- 工程师:重点阅读”11. 实践指南” → “6. 分布式训练” → “5. Post-Training与遗忘”
- 研究者:重点阅读”2. 预训练 / 3. SFT / 4. 对齐阶段” → “5. Post-Training与遗忘” → “10. 评估基准”
- 全面学习:按顺序完整阅读(约3.5小时)
1. 大模型训练基础概述
1.1 🤔 什么是大模型训练?
大模型训练是指使用海量文本数据,通过深度学习算法训练具有数十亿甚至数万亿参数的神经网络模型的过程。这些模型通常基于Transformer架构,能够学习语言的统计规律和语义理解能力。
训练大模型的目标是让模型获得:
- 🧠 语言理解能力:理解自然语言的语法、语义和上下文
- 📚 知识储备:从训练数据中学习世界知识
- 🔍 推理能力:基于已有信息进行逻辑推理和问题解决
- ✅ 指令遵循:准确理解并执行用户的各类指令
📌 核心概念
- 规模:参数量从10亿到数万亿不等
- 数据:训练数据通常达到数万亿tokens
- 时间:完整训练周期从数周到数月
- 成本:中大型模型训练成本从数十万到数百万美元
1.2 📅 大模型训练的演进历程
大模型训练经历了从小规模实验到工业化生产的重要转变:
1.2.1 早期探索阶段(2018-2019)🌱
- GPT-1、BERT等模型验证了预训练-微调范式的有效性
- 模型规模:百万到亿级参数
- 关键突破:自监督预训练、Transformer架构
1.2.2 规模化阶段(2020-2021)📈
- GPT-3将模型规模扩展到1750亿参数
- 发现涌现能力(Emergent Abilities)
- 少样本学习能力显著提升
1.2.3 对齐与应用阶段(2022-2023)🎯
- InstructGPT和ChatGPT引入RLHF(基于人类反馈的强化学习)
- 从”能用”到”好用”的关键转变
- 大模型开始广泛应用于实际场景
1.2.4 开源与民主化阶段(2024)🌍
- LLaMA、Mistral等开源模型快速发展
- 训练效率和成本持续优化
- 多模态、长上下文等能力不断增强
1.2.5 推理模型与效率竞赛阶段(2025-2026)🚀
- 推理模型范式确立:OpenAI o1/o3、DeepSeek-R1(及后续 V3.x 系列)将”测试时计算扩展”(Test-Time Compute Scaling)确立为与”训练时 Scaling Law”并列的新维度,长思维链(Long CoT)+ RL(GRPO 及其改进算法)成为训练强推理模型的标准范式
- 国产大模型集团式追赶:Qwen3 系列引入”思考/非思考”混合推理模式(同一模型可按需切换深度思考与快速响应);Kimi K2 以超大规模 MoE + 强 Agentic(工具调用)能力为卖点;MiniMax、智谱 GLM、阶跃星辰等持续迭代
- 闭源旗舰持续演进:GPT-5 系列、Claude 4.x(Opus/Sonnet/Haiku)系列、Gemini 系列在推理、长上下文、Agent 能力上持续竞争
- 架构创新:MLA(多头潜在注意力)、FP8 训练工程化(DeepSeek-V3)大幅降低了千亿级模型的训练与推理成本,”低成本高性能”成为新的竞争维度
- Agent 能力成为新焦点:从”对话助手”转向”能自主使用工具、完成多步任务的智能体”,训练目标从单轮问答扩展到多轮工具调用与长程任务规划
1.3 🎶 大模型训练的三大核心阶段
现代大模型训练遵循预训练 → 监督微调 → 偏好对齐的三阶段范式,这已成为GPT-4、Claude、Gemini、LLaMA等主流模型的标准流程。
flowchart LR
    A["原始文本数据<br>数万亿tokens"] --> B["阶段1: 预训练<br>Pre-training"]
    B --> C["Base Model<br>基座模型"]
    C --> D["阶段2: 监督微调<br>SFT"]
    E["指令-回答对<br>数万样本"] --> D
    D --> F["SFT Model<br>指令模型"]
    F --> G["阶段3: 偏好对齐<br>RLHF/DPO"]
    H["偏好对比数据<br>数万对"] --> G
    G --> I["✓ Aligned Model<br>最终部署"]

    style A fill:#e3f2fd,stroke:#01579b
    style C fill:#fff9c4,stroke:#f57f17
    style E fill:#e3f2fd,stroke:#01579b
    style F fill:#ffe0b2,stroke:#e65100
    style H fill:#e3f2fd,stroke:#01579b
    style I fill:#c8e6c9,stroke:#1b5e20
三个阶段的数据、算力与超参数差异见 1.3.4 节的对比表。
1.3.1 阶段一:预训练(Pre-training)
从海量无标注文本中学习语言的统计规律、语法结构和世界知识,训练出Base Model(基座模型)。
核心特点:
- 📊 数据规模最大:数万亿tokens(如 LLaMA-3 使用 15T tokens)
- ⏰ 训练时间最长:在数千块GPU上训练数周到数月
- 💰 成本最高:占总训练成本的 80-90%
- 🎯 目标:Next Token Prediction(预测下一个词)
输出能力:具备文本续写能力,但不擅长问答和指令遵循。
1.3.2 阶段二:监督微调(SFT)
使用高质量的指令-回答对训练,将Base Model转化为能够理解指令的SFT Model(指令模型)。
核心特点:
- 📊 数据规模小:10k-100k 高质量样本
- ⏰ 训练时间短:数小时到数天
- 💰 成本较低:占总成本的 5-10%
- 🎯 目标:Instruction Following(指令遵循)
输出能力:能够理解和执行用户指令,进行多轮对话。
1.3.3 阶段三:偏好对齐(Alignment)
通过人类反馈或AI反馈优化模型行为,使其更符合人类期望和价值观,训练出Aligned Model(对齐模型)。
核心特点:
- 📊 数据规模:数万对偏好对比数据
- ⏰ 训练时间:数小时到数天(推理模型的大规模 RL 可达数周)
- 💰 成本:占总成本的 5-10%
- 🎯 方法:RLHF、DPO、RLAIF、GRPO 等
输出能力:输出更有帮助、更安全、更符合人类价值观。
1.3.4 三阶段总结对比
| 阶段 | 预训练 | 监督微调 | 偏好对齐 |
|---|---|---|---|
| 目标 | 学习语言基础 | 教会指令遵循 | 符合人类偏好 |
| 数据类型 | 无标注文本 | 指令-回答对 | 偏好对比数据 |
| 数据规模 | 数万亿tokens | 数万-数十万样本 | 数万-数十万对比 |
| 训练时长 | 数周-数月 | 数小时-数天 | 数小时-数天 |
| 计算需求 | 数千GPU | 数十-数百GPU | 数十-数百GPU |
| 成本占比 | ~80-90% | ~5-10% | ~5-10% |
| 学习率 | 1e-4 ~ 3e-4 | 1e-5 ~ 5e-5 | 5e-7 ~ 5e-6 |
| Epoch数 | <1 epoch(太大) | 1-3 epochs | 1-3 epochs |
| 输出模型 | Base Model | SFT Model | Aligned Model |
关键洞察:
- 预训练是能力的来源(占成本90%)
- SFT是能力的激活(数据质量 > 数量)
- 对齐是体验的保证(必不可少)
1.4 🧩 大模型训练的核心组成要素
一个完整的大模型训练系统包含以下核心要素:
1.4.1 数据(Data)📊
- 预训练数据:网页、书籍、代码、学术论文等
- 微调数据:指令-回答对、对话数据
- 偏好数据:人类标注的偏好对比数据
- 数据处理流程:清洗、去重、质量过滤、毒性检测
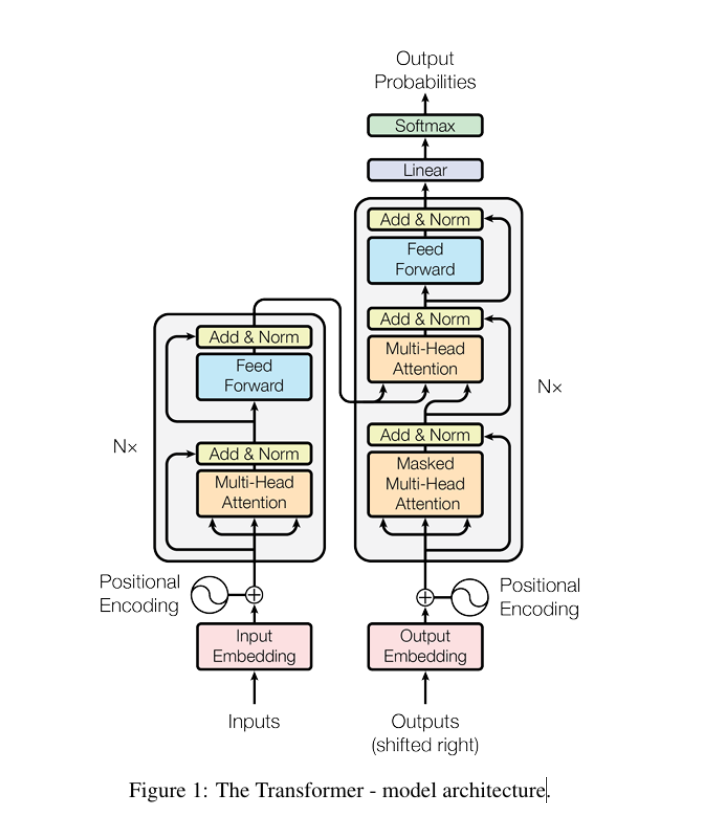
1.4.2 模型架构(Model Architecture)🏛️
- 基础架构:Transformer(Encoder、Decoder或Encoder-Decoder)
- 位置编码:绝对位置编码、相对位置编码、RoPE、ALiBi
- 注意力机制:Multi-Head Attention、Grouped-Query Attention、Multi-Query Attention
- 归一化方式:LayerNorm、RMSNorm、Pre-Norm vs Post-Norm
- 激活函数:GELU、SwiGLU、GeGLU
1.4.3 优化器与训练策略(Optimization)⚡
- 优化器:AdamW、Adafactor、Lion
- 学习率调度:Warmup、Cosine Decay、Constant
- 梯度处理:Gradient Clipping、Gradient Accumulation
- 正则化:Dropout、Weight Decay
1.4.4 分布式训练框架(Distributed Training)🔀
- 数据并行:DDP(Distributed Data Parallel)
- 张量并行:Megatron-LM Tensor Parallelism
- 流水线并行:Pipeline Parallelism、1F1B Schedule
- 序列并行:Sequence Parallelism
- 混合并行:3D Parallelism(数据+张量+流水线)
- 优化器状态并行:ZeRO-1/2/3(DeepSpeed)
1.4.5 计算基础设施(Infrastructure)💻
- 硬件:GPU集群(A100、H100等)、TPU、专用AI芯片
- 互联网络:InfiniBand、NVLink、PCIe
- 存储系统:高性能分布式存储
- 监控与日志:TensorBoard、Weights & Biases、MLflow
1.5 🚧 大模型训练的主要挑战
⚠️ 挑战总览
大模型训练是一项极具挑战性的系统工程,需要在计算资源、数据质量、训练稳定性、模型对齐等多个维度取得平衡。成功训练一个高性能大模型不仅需要技术实力,更需要工程经验的积累。
1.5.1 计算资源与成本
训练大模型需要巨大的计算资源:
- GPT-3级别模型训练成本约数百万美元
- 需要数千块高端GPU并行训练数月
- 碳排放和能源消耗问题
- 如何降低训练成本成为关键挑战
1.5.2 数据质量与规模
高质量训练数据是模型性能的基础:
- 网络数据存在噪声、偏见和有害内容
- 数据去重、清洗和质量控制的工程挑战
- 隐私和版权问题
- 高质量人工标注数据成本高昂
1.5.3 训练稳定性
大规模训练面临稳定性挑战:
- Loss spike(损失突然上升)
- 梯度爆炸/消失
- 数值不稳定(Numerical Instability)
- 分布式训练中的同步问题
1.5.4 模型对齐与安全
让模型行为符合人类期望:
- 如何准确捕捉人类偏好
- 避免有害、偏见或不准确的输出
- Reward Hacking问题(奖励函数被利用)
- 长期对齐的稳定性
1.5.5 评估与基准测试
如何全面评估模型能力:
- 现有基准测试可能被”刷榜”
- 难以量化创造性和开放式能力
- 多语言、多模态评估的复杂性
- 真实应用场景下的表现差异
1.5.6 涌现能力的不可预测性
模型规模扩大带来的未知:
- 某些能力只在特定规模后出现
- 难以提前预测模型行为
- 可能出现意外的能力或问题
- 如何系统性理解规模法则(Scaling Laws)
2. 预训练阶段(Pre-training)
预训练是大模型训练的基石,目标是让模型从海量无标注文本中学习语言的统计规律和世界知识。
🎯 本章导读
预训练是整个训练流程中成本最高、时间最长、技术难度最大的阶段,占总成本的80-90%。本章将详细介绍预训练的目标函数、数据处理、训练技巧和前沿技术,帮助读者理解如何从零开始训练一个基座模型。
2.1 预训练完整流程概览
下图展示了从原始数据到 Base Model 的完整训练流程:
graph TD
    A0[Step 0: 分词器训练] --> H
    A[原始数据采集] --> B[数据清洗与过滤]
    B --> C[质量评估]
    C --> D{是否通过?}
    D -->|否| E[丢弃]
    D -->|是| F[去重处理]
    F --> G[MinHash/SimHash去重]
    G --> H[Tokenization]
    H --> I[数据配比与采样]
    I --> J[构建训练批次]
    J --> K[分布式训练<br/>3D并行: DP+TP+PP]
    K --> L[前向传播]
    L --> M[计算Loss<br/>Next Token Prediction]
    M --> N[反向传播]
    N --> O[梯度同步 All-Reduce]
    O --> P[优化器更新<br/>AdamW]
    P --> Q{是否保存checkpoint?}
    Q -->|是| R[保存模型状态]
    Q -->|否| S{训练完成?}
    R --> S
    S -->|否| J
    S -->|是| T[Base Model<br/>基座模型]

    style A0 fill:#f3e5f5,stroke:#7b1fa2
    style A fill:#e1f5ff
    style T fill:#c8e6c9
    style M fill:#fff9c4
    style K fill:#ffe0b2
流程说明:
- 数据准备阶段(A-I):占整体时间的 20-30%,包括采集、清洗、去重、分词器训练与分词
- 训练迭代阶段(J-S):占整体时间的 70-80%,核心是前向-反向-优化循环
- Checkpoint 管理:每 1000-5000 步保存一次,总训练步数通常 100k-500k 步
2.2 分词器训练 (Tokenizer Training)
在正式开始模型训练之前,我们需要定义模型如何“阅读”文本。分词器将连续的文本切割成模型可理解的最小单元(Tokens)。
2.2.1 为什么需要训练分词器?
如果直接使用字符(Character)或词(Word),会面临词表过大(难以收敛)或单个 Token 信息密度过低(序列过长)的问题。现代大模型普遍采用 子词(Subword) 分词方案,如 BPE (Byte Pair Encoding)。
2.2.2 核心权衡:词表大小 (Vocab Size)
- 大词表(如 100k+):
- ✅ 优点:单个 Token 承载信息多,序列更短,推理更快。
- ❌ 缺点:Embedding 层参数巨大,稀疏词难以充分训练。
- 小词表(如 32k):
- ✅ 优点:Embedding 层小,参数利用率高,适合小模型。
- ❌ 缺点:同一个句子生成的 Token 数更多,增加计算开销。
💡 MiniMind 经验:对于参数量在 500M 以下的小模型,词表不宜过大(MiniMind 只用 6,400 的 BPE 词表,常见的折中是 32k),否则 Embedding 层会吃掉大部分参数,稀有 Token 的向量也得不到充分更新。
2.2.3 分词器训练实战 (Python)
使用 Hugging Face 的 tokenizers 库,可以快速训练一个 GPT/Llama 风格的字节级 BPE(Byte-level BPE)分词器。字节级方案以 256 个字节为初始字母表,任何语言(包括中文和 emoji)都不会出现未登录词(OOV),这也是当前 LLM 的主流选择:
from tokenizers import Tokenizer, decoders, models, pre_tokenizers, trainers

# 1. 初始化字节级 BPE 模型
tokenizer = Tokenizer(models.BPE())
tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
tokenizer.decoder = decoders.ByteLevel()

# 2. 配置训练器:以 256 个字节作为初始字母表,保证无 OOV
trainer = trainers.BpeTrainer(
    vocab_size=32000,
    min_frequency=2,
    special_tokens=["<|endoftext|>", "<|im_start|>", "<|im_end|>"],
    initial_alphabet=pre_tokenizers.ByteLevel.alphabet(),
)

# 3. 训练分词器
files = ["data/corpus_1.txt", "data/corpus_2.txt"]
tokenizer.train(files, trainer)

# 4. 保存分词器
tokenizer.save("my_tokenizer.json")
算法对比(BPE / WordPiece / Unigram)、词表大小选择与特殊 Token 设计见 9.5 节。
2.3 预训练目标函数
预训练的核心是设计合适的目标函数,让模型从无标注文本中学习语言规律。
2.3.1 自回归语言建模(Autoregressive Language Modeling)
核心思想:给定前文,预测下一个 token(Next Token Prediction)
数学表达:
对于文本序列 $\mathbf{x} = (x_1, x_2, \ldots, x_T)$,训练目标是最大化:
\[\mathcal{L}_{\text{AR}} = \sum_{t=1}^{T} \log P(x_t \mid x_1, x_2, \ldots, x_{t-1}; \theta)\]其中 $\theta$ 是模型参数。
训练过程:
- Teacher Forcing:训练时使用真实的前文作为输入
- Causal Masking:注意力机制只能看到左侧(过去)的 token
- 损失计算:对每个位置计算交叉熵损失,然后平均
代表模型:
- GPT 系列(GPT-3, GPT-4):纯 Decoder 架构
- LLaMA 系列(LLaMA-2, LLaMA-3):开源高性能模型
- PaLM、Gemini:Google 的大模型
优势:
- ✅ 生成能力强,擅长续写和对话
- ✅ 架构简单,易于扩展到超大规模
- ✅ 训练效率高
训练循环示意:
import torch.nn.functional as F

for batch in dataloader:
    input_ids = batch['input_ids']      # [batch_size, seq_len]

    logits = model(input_ids).logits    # [batch_size, seq_len, vocab_size]

    # Next Token Prediction:位置 t 的输出去预测第 t+1 个 token
    # 输入 [x1, x2, x3, x4] 的输出,分别对齐目标 [x2, x3, x4]
    shift_logits = logits[:, :-1, :]
    shift_labels = input_ids[:, 1:]

    loss = F.cross_entropy(
        shift_logits.reshape(-1, shift_logits.size(-1)),
        shift_labels.reshape(-1),
    )
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
2.3.2 掩码语言建模(Masked Language Modeling)
核心思想:随机 mask 部分 token,预测被 mask 的内容
数学表达:
\[\mathcal{L}_{\text{MLM}} = \sum_{i \in \mathcal{M}} \log P(x_i \mid \mathbf{x}_{\backslash \mathcal{M}}; \theta)\]其中 $\mathcal{M}$ 是被 mask 的位置集合,\(\mathbf{x}_{\backslash \mathcal{M}}\) 表示除了 masked 位置外的所有 token。
训练策略(BERT 方式):
- 随机选择 15% 的 token 进行处理:
- 80% 替换为
[MASK] - 10% 替换为随机 token
- 10% 保持不变
- 80% 替换为
代表模型:
- BERT:双向 Encoder,预训练+微调范式
- RoBERTa:优化的 BERT(更多数据、更大 batch、去除 NSP)
- DeBERTa:Disentangled Attention
优势:
- ✅ 双向上下文理解(能同时看到左右信息)
- ✅ 适合理解类任务(分类、信息抽取)
劣势:
- ❌ 预训练和微调的 gap(预训练有 [MASK],微调没有)
- ❌ 生成能力较弱
2.3.3 混合目标与其他变体
2.3.3.1 Encoder-Decoder 架构(T5、BART)
- Span Corruption:mask 连续的 token span
- 适合序列到序列任务:翻译、摘要
2.3.3.2 Prefix Language Modeling(PrefixLM)
- UL2:结合双向和单向建模
- 灵活性高:可以选择双向或单向注意力
2.3.3.3 Fill-in-the-Middle(FIM)
- 用于代码模型:预测中间缺失的代码
- 代表:CodeLlama、StarCoder
- 格式:
[前缀] <FILL> [后缀] → [中间内容]
2.4 预训练数据
预训练数据决定了模型的知识边界和能力分布。一条典型的数据流水线是:
- 采集:Common Crawl 网页、书籍、代码(GitHub)、学术论文(arXiv)、百科(Wikipedia)、问答社区(StackExchange)等
- 过滤:语言识别、启发式规则、质量分类器、毒性检测与个人信息(PII)清理
- 去重:精确哈希去重 + MinHash/LSH 模糊去重,并与评测集去重以防泄露
- 分词:用 2.2 节训练的分词器把文本转成 token 序列
- 配比与采样:为各数据源设定混合比例,高质量小数据源上采样、低质量大数据源下采样
每个环节的具体方法、工具与取舍统一在第 9 章「数据工程」展开(包括 GPT-3、LLaMA 等模型的真实配比)。这里先记住三条结论:
- 数量与质量要兼顾:Chinchilla 缩放定律表明,同等算力下应让参数量与训练 token 数同比增长(约 20 tokens/参数);而 FineWeb-Edu、Phi 系列则说明,数据质量提升可以显著降低达到同等效果所需的 token 数
- 去重至关重要:重复数据会加剧记忆、浪费算力,并可能造成评测集泄露
- 配比影响能力边界:代码与数学数据的比例直接影响推理能力,多语言比例影响跨语言泛化
2.5 预训练的关键技术
2.5.1 学习率调度
预训练最常用的是 线性 Warmup + 余弦衰减(Cosine Decay);需要随时追加数据的持续预训练则越来越多地采用 WSD(Warmup-Stable-Decay)。两种调度的公式与对比见 7.2 节,本节只给出预训练场景下的参数经验。
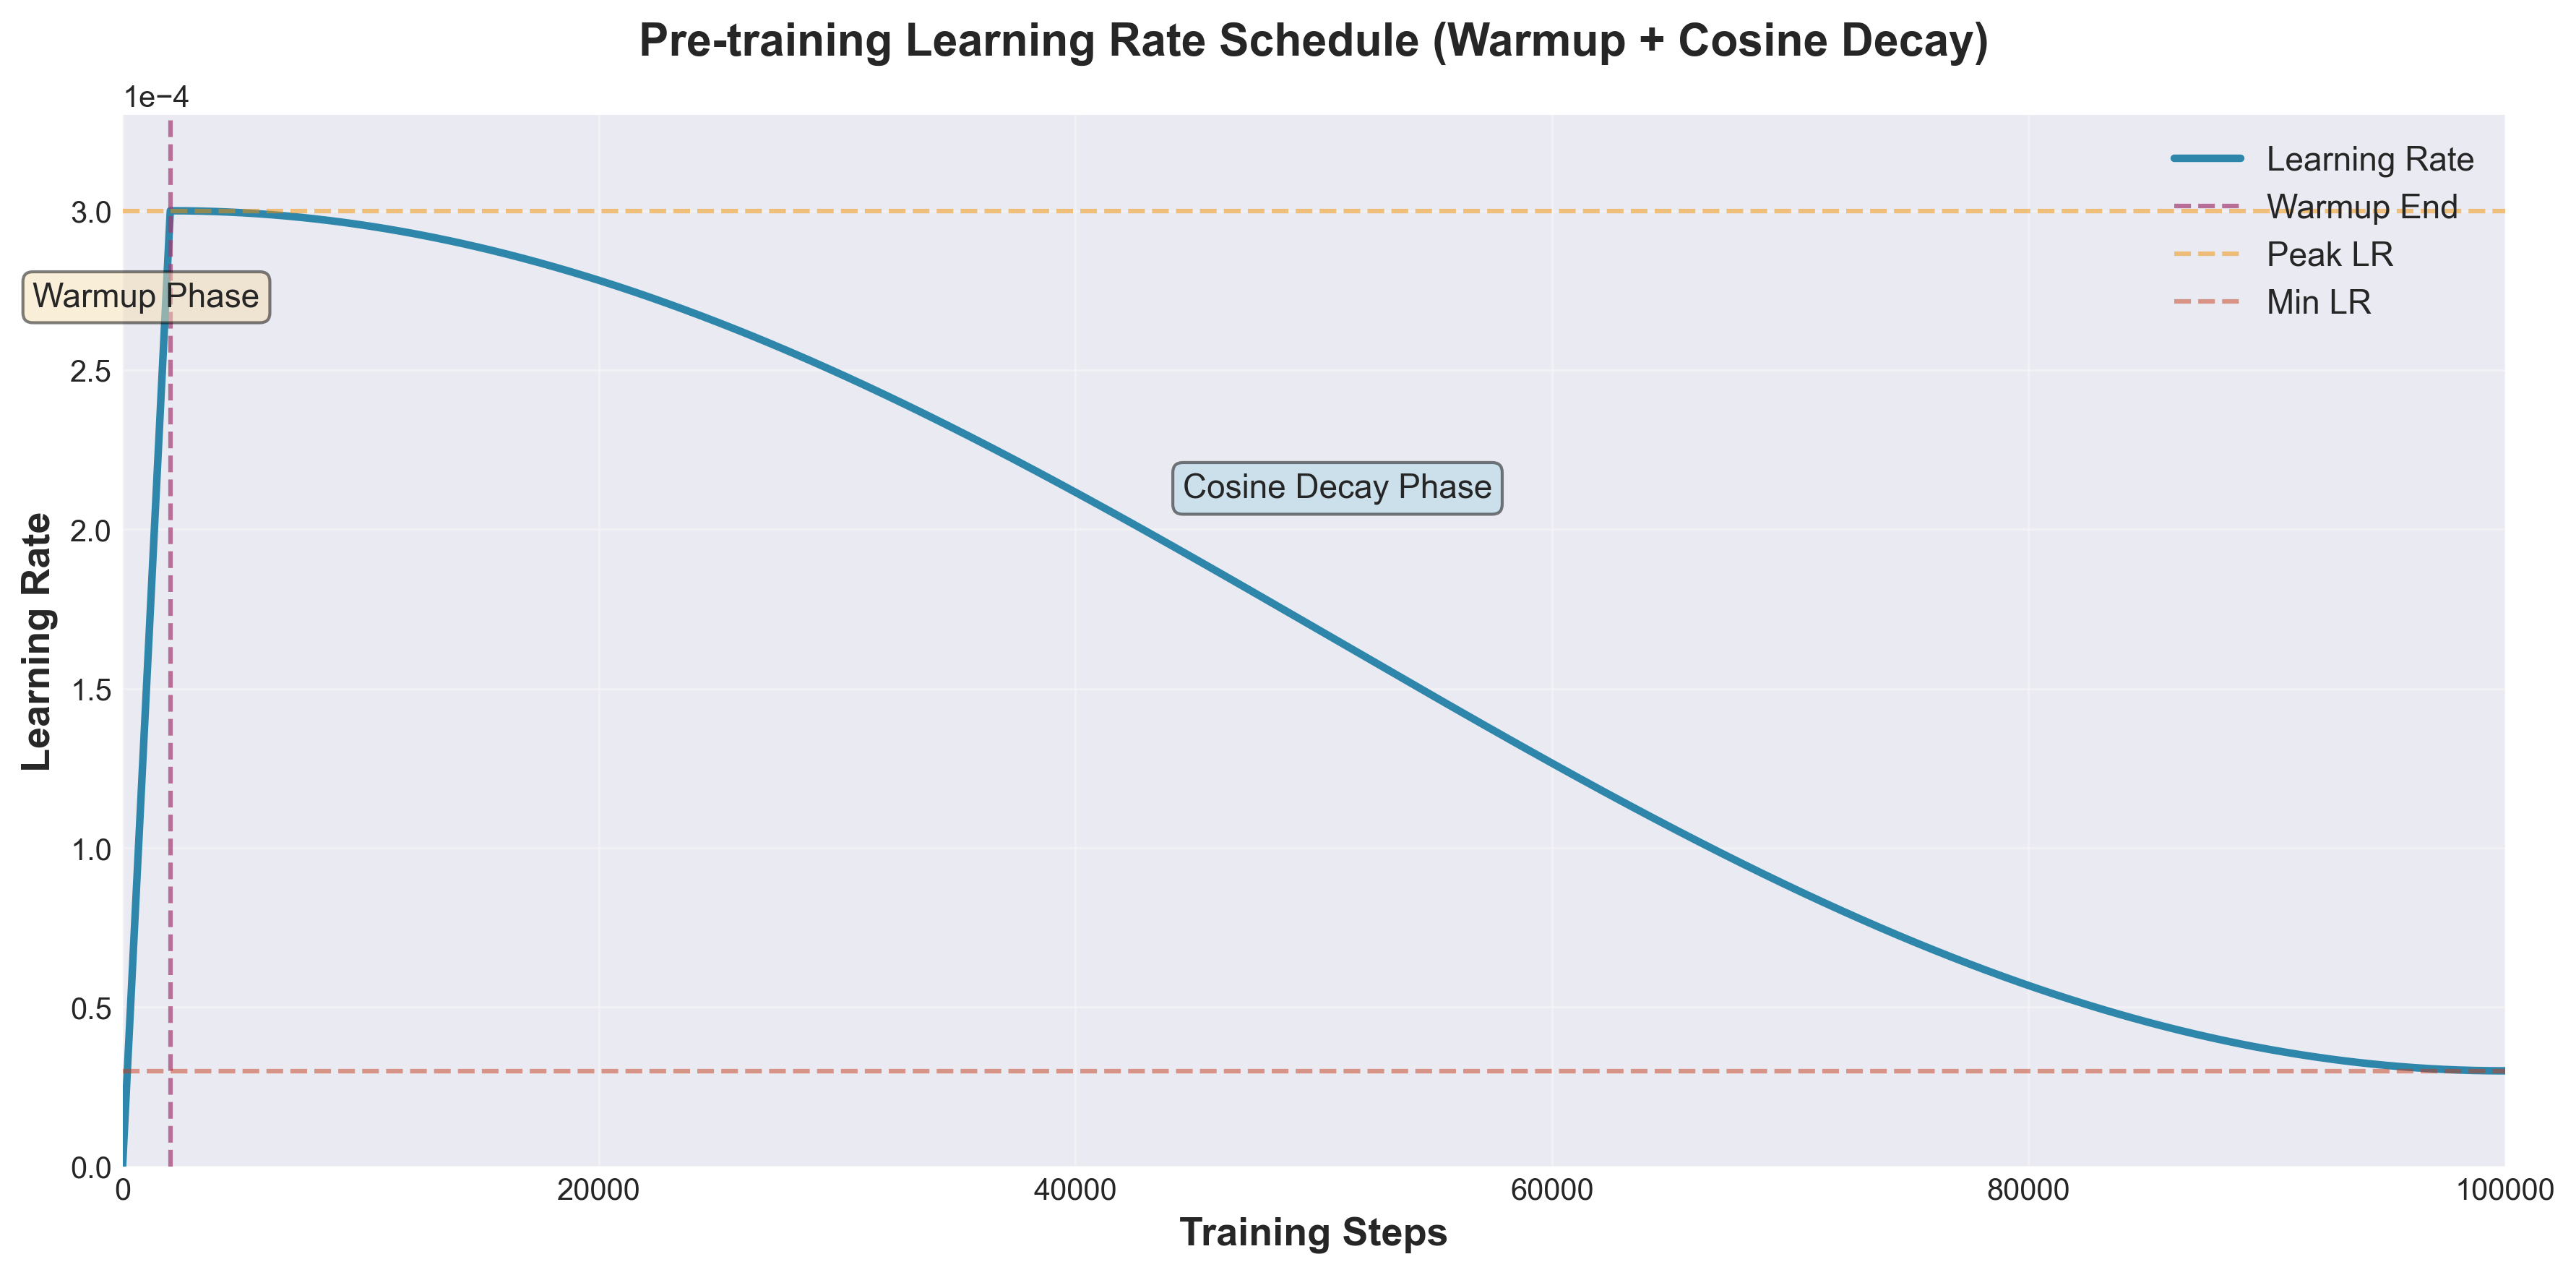
关键参数:
- Warmup步数:通常2,000-10,000步(占总步数的1-2%)
- Peak Learning Rate:根据模型规模调整
- 小模型(<1B参数):3e-4 ~ 1e-3
- 中型模型(1-10B参数):1e-4 ~ 3e-4
- 大模型(10B+参数):6e-5 ~ 2e-4
- Decay策略:Cosine Annealing最常用
- 最小学习率:通常为峰值的10%
Warmup的重要性:
- 避免训练初期的梯度爆炸
- 让优化器状态(Adam的momentum)逐步稳定
- 大模型训练的必要技巧
学习率与批次大小关系(Linear Scaling Rule):
\[\text{lr}_{\text{new}} = \text{lr}_{\text{base}} \times \frac{\text{batch}_{\text{new}}}{\text{batch}_{\text{base}}}\]例如:基础配置 lr=1e-4, batch=256 → 扩展到 batch=2048 → lr=8e-4。
需要注意,线性缩放规则来自 SGD 的大 batch 训练经验(Goyal et al., 2017)。对 Adam 类优化器,学习率随 batch 的增长通常更接近平方根缩放,且 batch 超过”临界 batch size”后收益迅速递减,因此实际仍需在小规模实验上扫参确认。
2.5.2 批次大小(Batch Size)
Batch size 直接影响训练效率和梯度质量。以 token 数量计(而非样本数),主流做法是训练过程中逐步增大 batch size。
2.5.2.1 为什么需要大 Batch Size?
- 计算效率:更高的 GPU 利用率,矩阵乘法更高效
- 梯度质量:大 batch 的梯度估计方差更小,更新方向更稳定
- 通信效率:分布式训练中步数减少,AllReduce 次数减少
注意:batch size 过大会导致泛化性下降(sharp minima 问题),需配合学习率调整(参见上方线性缩放规则)。
2.5.2.2 典型规模(以 tokens/batch 计)
| 模型 | Batch Size(tokens) | 说明 |
|---|---|---|
| GPT-3 175B | 32K → 3.2M(逐步增大) | 训练前期小 batch,后期大 batch |
| LLaMA-2 | 4M tokens | 全程固定 |
| PaLM 540B | 1M → 4M(逐步增大) | 按训练进度分三档加倍 |
| Chinchilla 70B | 1.5M → 3M | 训练中途加倍 |
2.5.2.3 梯度累积(Gradient Accumulation)
当单卡显存不足以容纳目标 batch size 时,通过多步小 batch 累积梯度来等效模拟:
optimizer.zero_grad()
for step, batch in enumerate(dataloader):
    loss = model(batch) / accumulation_steps   # 缩放 loss
    loss.backward()                             # 累积梯度
    if (step + 1) % accumulation_steps == 0:
        optimizer.step()                        # 每 N 步更新一次
        optimizer.zero_grad()
等效关系:effective batch size = per-GPU batch size × gradient accumulation steps × 数据并行卡数。分布式场景下配合 no_sync() 跳过前 N−1 步梯度同步的做法见 7.3.2 节。
2.5.3 上下文长度(Context Length)
2.5.3.1 为什么从短上下文开始?
- 注意力计算复杂度为 $O(n^2)$,序列越长显存和计算量急剧增加
- 训练初期模型尚未学到长程依赖,长序列带来的收益有限
- 短上下文阶段积累充分的语言理解能力,再扩展事半功倍
2.5.3.2 渐进式扩展策略
主训练阶段:    4K–8K tokens  → 完成绝大部分训练 token(早期模型为 2K,Llama 3 为 8K)
长上下文扩展:  32K → 128K    → 分多个阶段逐步加长,只追加少量 token
以 Llama 3 为例:先在 8K 上下文上完成约 15T tokens 的预训练,再分 6 个阶段把上下文逐步扩展到 128K,这一扩展阶段共使用约 800B tokens(Llama 3 技术报告)。
2.5.3.3 位置编码扩展技术
Position Interpolation(PI)
RoPE 的旋转频率是为固定最大长度 $L_{\text{train}}$ 设计的,超出此范围时位置编码失效。PI 的解决方案:将位置索引从 $[0, L_{\text{target}}]$ 缩放映射回 $[0, L_{\text{train}}]$:
\[\text{pos}_{\text{new}} = \text{pos} \times \frac{L_{\text{train}}}{L_{\text{target}}}\]优点:实现简单,仅需约 1000 步微调即可适应 2–4× 上下文扩展。
YaRN(Yet another RoPE extension)
PI 对所有频率分量使用统一缩放,导致高频分量信息损失。YaRN 改进策略:
- 低频分量:使用 PI 缩放(长程依赖)
- 高频分量:保持不插值(短程精细特征)
- 温度缩放(Temperature Scaling):缩小注意力 logits 防止熵塌缩
效果:扩展到 128k 上下文,仅需少量数据微调,精度优于 PI。
ALiBi(Attention with Linear Biases)
不依赖绝对位置编码,在注意力分数上直接叠加与距离成正比的线性惩罚:
\[\text{Attention score}_{ij} = q_i \cdot k_j^T - m \cdot (i - j)\]其中 $m$ 为每个注意力头的斜率(超参数)。优点:训练时无需指定最大长度,推理时可直接外推,无需额外微调。
2.5.3.4 超长上下文分布式工程优化
随着长上下文(从 32K 扩展到百万 Token)需求的爆发,仅靠单卡优化已无法承载。在分布式工程中,主要采用以下核心技术:
- 环形注意力机制(Ring Attention)
- 原理:将序列(Sequence)维度切分到由 $P$ 张 GPU 组成的环形通信拓扑中。每个 GPU 只持有一段局部序列的 Query。在计算注意力时,Key 和 Value 的数据块通过环形缓冲区(Ring Buffer)在 GPU 之间依次流转并计算局部 Attention 结果。
- 优势:将注意力机制的显存复杂度由 $O(N^2)$ 分摊到各个节点上,实现显存随 GPU 数量的线性扩展,使训练百万甚至千万级别的超长文本序列成为可能。
- RoPE 基频缩放(Base Frequency Scaling)
- 原理:在拓展上下文时,若直接使用原始位置编码,长序列尾部的位置向量在频域上会出现相位重叠或漂移。除了插值(PI/YaRN)外,常见做法是大幅上调 RoPE 的底数基频 $\theta$(例如 Llama 2 使用 10,000,Llama 3 上调至 500,000)。
- 作用:拉长各频率分量的波长,让更远的位置仍能被区分,缓解模型处理长文本时的注意力退化。
- LongLoRA(Shifted Sparse Attention)
- 原理:训练时用分组的局部注意力(并在一半注意力头上错开分组边界)替代全局注意力,推理时恢复标准注意力;再配合只训练 LoRA 与 Embedding/Norm 层。
- 作用:以较小的算力把 7B–70B 模型的上下文扩展到 32K–100K 级别。
2.5.4 混合精度训练
使用低精度浮点数(FP16/BF16)计算,配合 FP32 优化器状态,在节省显存的同时保持训练稳定性。
2.5.4.1 浮点格式对比
| 格式 | 符号位 | 指数位 | 尾数位 | 最大值 | LLM 训练适用性 |
|---|---|---|---|---|---|
| FP32 | 1 | 8 | 23 | ~3.4×10³⁸ | 基准,稳定但显存大 |
| FP16 | 1 | 5 | 10 | ~65504 | 范围小,容易上溢/下溢 |
| BF16 | 1 | 8 | 7 | ~3.4×10³⁸ | LLM 首选:范围同 FP32 |
| FP8 (E4M3) | 1 | 4 | 3 | ~448 | H100 原生,推理/训练新选择 |
关键结论:BF16 与 FP32 指数位数相同,不会因梯度数值范围过大/过小导致溢出,是当前大模型训练的首选格式。
2.5.4.2 FP16 训练需要 Loss Scaling
FP16 最大值约 65504,梯度如果很小(< 2⁻²⁴)会下溢为 0,导致参数不更新。解决方案:
import torch

scaler = torch.amp.GradScaler("cuda")

with torch.autocast("cuda", dtype=torch.float16):   # 前向用 FP16
    loss = model(inputs)

scaler.scale(loss).backward()            # 梯度乘以 scale factor 防下溢
scaler.step(optimizer)                   # 反缩放后更新参数
scaler.update()                          # 自动调整 scale factor
2.5.4.3 BF16 训练(推荐,无需 Loss Scaling)
with torch.autocast("cuda", dtype=torch.bfloat16):
    loss = model(inputs)

loss.backward()
optimizer.step()
2.5.4.4 混合精度中的 Master Weights
主权重(Master Weights)以及 Adam 的一阶矩 $m$、二阶矩 $v$ 都以 FP32 保存,确保微小的更新量不会被 BF16 的舍入吞掉。由此得到混合精度训练每参数约 16 字节的静态显存(推导见 6.5.1 节):
前向/反向计算:BF16(节省显存)
优化器状态:  FP32(保证精度,但多占显存)
权重更新:    FP32 累加后再转 BF16 写回模型
2.5.4.5 FP8 训练工程实践(以 DeepSeek-V3 为例)
BF16 解决了”数值范围”问题,但每个数仍占 2 字节。FP8(8-bit 浮点)训练是 Hopper(H100)及更新一代 GPU 原生支持的下一步压缩:存储减半,Tensor Core 吞吐翻倍。DeepSeek-V3 首次在 671B 参数的超大规模上验证了 FP8 预训练的可行性。
1. 为什么不能直接全用 FP8?
FP8 只有 3 或 2 位尾数(E4M3:4 位指数 + 3 位尾数;E5M2:5 位指数 + 2 位尾数),直接替换 BF16 会导致梯度累加时的舍入误差快速累积,训练发散。DeepSeek-V3 的解决方案是混合粒度量化 + 选择性高精度保留,而非简单的”全员转 FP8”。
2. 细粒度量化(Fine-Grained Quantization)
不对整个张量使用单一缩放因子(per-tensor scaling),而是按更小的单位分别确定缩放因子:
- 激活值:按 1×128 的 tile(分块)粒度量化
- 权重:按 128×128 的 block(块)粒度量化
相比 per-tensor 量化,这种细粒度方案能更好地适应张量内部数值分布的不均匀性(如异常值集中在某些通道),显著降低量化误差。
3. E4M3 与 E5M2 的取舍
NVIDIA Transformer Engine 默认的混合格式:
  前向传播(激活值、权重):E4M3(3 位尾数,精度更高)
  反向传播(梯度):        E5M2(5 位指数,动态范围更大)

DeepSeek-V3:
  所有张量统一使用 E4M3
梯度的数值范围通常比激活值更大,所以 Transformer Engine 让反向传播使用范围更大的 E5M2。DeepSeek-V3 则反其道而行:细粒度缩放已经让每个小块内的数值范围足够窄,于是所有张量都改用精度更高的 E4M3。
4. 累加精度问题(Accumulation Precision)
矩阵乘法(GEMM)的累加误差会随累加长度增大而放大。DeepSeek-V3 报告指出,H800 Tensor Core 做 FP8 GEMM 时累加只保留约 14 位精度。其做法是每累加 128 个元素就把部分和提升到 CUDA Core 上,以 FP32 精度继续累加;FP8 只用在矩阵乘法的输入端,主权重、梯度累加与优化器状态仍保持高精度,从而避免”算得快但算不准”。
5. 效果
DeepSeek-V3 报告显示,与 BF16 基线相比,FP8 训练的相对 loss 误差始终低于 0.25%,同时显著降低了显存占用与训练算力。这是它能以约 557.6 万美元的正式训练成本训出 671B 参数 MoE 模型的关键技术之一(参见 11.2.2 节的真实案例)。
⚠️ 工程提醒:FP8 训练目前仍依赖 Hopper/Blackwell 架构的硬件原生支持(Ampere 及更早架构无法获得加速收益),且需要框架层面(如 Transformer Engine、DeepSeek 自研训练框架)精细处理缩放因子的动态更新,并非简单地修改
dtype参数就能获得收益。
2.5.5 Flash Attention
Flash Attention 通过 IO-aware 分块计算,将注意力层的显存复杂度从 $O(n^2)$ 降至 $O(n)$,且计算结果与标准注意力数学等价;注意力算子本身可提速数倍,端到端训练通常提速 2–3×。详细原理参见「7.5 Flash Attention」。
2.6 预训练的前沿技术
2.6.1 MoE(Mixture of Experts)架构
2.6.1.1 核心思想
标准 Transformer 每个 token 都经过全部参数,而 MoE 在 FFN 层引入多个”专家”网络,每次只激活其中 top-k 个,实现参数量大、计算量小的目标。
输入 token → Router(路由器)→ 选择 top-k 专家 → 各专家并行计算 → 加权输出
专家路由(Gating)机制:
\[\text{Gate}(x) = \text{TopK}(\text{softmax}(W_g \cdot x), k)\]每个 token 的输出是 top-k 专家输出的加权和,权重由 softmax 归一化分数决定。
2.6.1.2 负载均衡(Load Balancing)
如果路由器总把 token 分给同几个专家,其他专家形同虚设——这是 MoE 最核心的训练挑战。解决方案是在训练 loss 中加入辅助均衡损失:
\[\mathcal{L}_{\text{aux}} = \alpha \cdot N \sum_{i=1}^{N} f_i \cdot P_i\]其中 $f_i$ 为实际分配到专家 $i$ 的 token 比例,$P_i$ 为路由器输出给专家 $i$ 的平均概率,$\alpha$ 通常取 0.01 左右(Switch Transformer 的取值)。
辅助损失的副作用是会干扰主任务的梯度。DeepSeek-V3 改用无辅助损失(Auxiliary-Loss-Free)的负载均衡:给每个专家的路由分数加一个只用于选择 top-k 的偏置项,训练中根据专家的实际负载动态调高或调低这个偏置,从而在不引入额外损失的情况下保持均衡。
2.6.1.3 代表模型
| 模型 | 路由专家数 | 每 token 激活 | 总参数量 | 激活参数量 |
|---|---|---|---|---|
| Switch Transformer | 最多 2048 | top-1 | 1.6T | 远小于总参数 |
| Mixtral 8x7B | 8 | top-2 | 47B | 约 13B |
| DeepSeek-V3 | 256(另有 1 个共享专家) | top-8 | 671B | 37B |
| Qwen3-235B-A22B | 128 | top-8 | 235B | 22B |
2.6.1.4 工程挑战
- 通信开销:不同 token 的专家可能在不同 GPU 上,需要 All-to-All 通信
- 专家并行(Expert Parallelism):将不同专家放置在不同 GPU 上
- 训练不稳定性:路由崩塌(所有 token 涌入少数专家)
2.6.2 训练稳定性技术
2.6.2.1 WSD 学习率调度(Warmup-Stable-Decay)
传统 Cosine 调度必须预先确定总训练 token 数,中途想追加数据就得重跑衰减曲线。WSD 把训练分成 Warmup、Stable(恒定峰值学习率)和 Decay 三段,Stable 阶段可以任意延长,因此适合持续/增量预训练。公式与细节见 7.2.3 节。
2.6.2.2 μP(Maximal Update Parameterization)
标准参数化下,最优学习率会随模型宽度变化,小模型上调好的超参数无法直接用于大模型。μP 按宽度对初始化方差和各类参数的学习率做规模相关的缩放(例如用 Adam 训练时,隐藏层矩阵参数的学习率按 $1/\text{width}$ 缩放),使最优超参数在不同宽度下保持不变。
- 实践价值(μTransfer):在小代理模型(proxy model)上搜索超参数,再直接迁移到大模型,大幅节省调参成本
- 代表工作:Tensor Programs V(Yang et al., 2022);Cerebras-GPT、MiniCPM 等模型采用了 μP
2.6.2.3 Loss Spike 处理
训练过程中偶发的梯度爆炸会导致 loss 急剧上升,常见应对策略(完整的诊断流程见 11.3.2.3 节):
- 梯度裁剪(Gradient Clipping):限制梯度 L2 范数,通常设为 1.0
- BF16 代替 FP16:避免数值溢出引发的不稳定
- 自动回滚:监测 loss 突变时自动回退到上一个检查点并调低学习率
- 稳定 Adam 配置:将 $\beta_2$ 从默认 0.999 调低至 0.95,减小二阶矩的历史依赖
3. 监督微调阶段(Supervised Fine-Tuning, SFT)
SFT阶段将预训练模型转化为能够理解和执行指令的助手。
🎯 本章导读
SFT是激活模型能力的关键阶段,通过少量高质量的指令-回答数据,让Base Model学会遵循指令和对话交互。本章介绍SFT的数据构建、训练策略和高效微调技术(如LoRA、QLoRA),特别强调数据质量远比数量重要的核心理念。
3.1 SFT 完整流程概览
下图展示了从 Base Model 到 SFT Model 的完整训练流程:
graph TD
    A[Base Model<br/>基座模型] --> B[准备SFT数据集]
    B --> C[数据来源选择]
    C --> D1[人工标注<br/>高质量]
    C --> D2[模型蒸馏<br/>GPT-4生成]
    C --> D3[开源数据集<br/>ShareGPT等]
    D1 --> E[数据质量控制]
    D2 --> E
    D3 --> E
    E --> F[格式化为统一模板<br/>System/User/Assistant]
    F --> G[构建训练数据<br/>只对Assistant部分计算loss]
    G --> H{选择微调方式}
    H -->|资源充足| I1[全参数微调<br/>更新所有参数]
    H -->|资源受限| I2[LoRA/QLoRA<br/>参数高效微调]
    I1 --> J[训练1-3个epoch]
    I2 --> J
    J --> K[训练监控与评估]
    K --> L{是否收敛?}
    L -->|否| M[调整超参数]
    M --> J
    L -->|是| N[SFT Model<br/>指令微调模型]

    style A fill:#fff9c4
    style N fill:#c8e6c9
    style E fill:#e1f5ff
    style G fill:#ffe0b2
关键特点:
- 数据规模小:通常 10k-100k 样本,远小于预训练
- 训练时间短:数小时到数天,而非数周
- 质量优先:数据质量比数量更重要
- 灵活性高:可以使用 LoRA 等技术大幅降低成本
3.2 SFT 的训练目标
核心任务:让模型学会遵循指令(Instruction Following)
3.2.1 数学表达
给定指令 $x$(prompt)和期望回答 $y$(response),训练目标是最大化条件概率:
\[\mathcal{L}_{\text{SFT}} = -\sum_{(x,y) \in \mathcal{D}_{\text{SFT}}} \log P(y \mid x; \theta)\]其中 \(\mathcal{D}_{\text{SFT}}\) 是监督微调数据集,包含高质量的指令-回答对。
3.2.2 与预训练的关键区别
预训练:
- 模型看到整个文档,预测每个 token
- 所有位置都计算 loss
SFT:
- 模型只对回答部分计算 loss
- 指令部分不计算 loss:做法是把这些位置的 label 置为
-100(loss mask),而不是改动 attention mask——模型仍然能”看到”完整的指令
SFT核心代码:
import torch.nn.functional as F

def sft_loss(model, batch):
    """SFT的关键:只对Assistant回答部分计算loss"""
    input_ids = batch['input_ids']  # [batch_size, seq_len]
    labels = batch['labels']        # [batch_size, seq_len],与 input_ids 对齐

    # labels示例: [-100, -100, -100, 152, 234, 567, ...]
    #              ↑~~~ User指令 ~~~↑  ↑~~ Assistant回答 ~~↑
    #              (忽略,不计算loss)    (计算loss,学习生成)

    logits = model(input_ids).logits

    # 与预训练相同,先错开一位:位置 t 的输出预测第 t+1 个 token
    shift_logits = logits[:, :-1, :]
    shift_labels = labels[:, 1:]

    # cross_entropy 会自动忽略 label = -100 的位置
    loss = F.cross_entropy(
        shift_logits.reshape(-1, shift_logits.size(-1)),
        shift_labels.reshape(-1),
        ignore_index=-100,
    )
    return loss
3.2.3 SFT 的四大目标
- 指令理解:识别各类指令格式和任务类型
- 结构化输出:生成格式规范、逻辑清晰的回答
- 对话适应:掌握多轮对话的上下文管理
- 减少幻觉:提高事实准确性,降低编造信息的倾向
3.3 SFT 数据构建
核心原则:质量 > 数量。少量高质量数据胜过大量低质量数据。
3.3.1 数据规模对比
| 模型 | SFT 数据规模 | 数据来源 | 说明 |
|---|---|---|---|
| InstructGPT | 13k | 人工标注 | OpenAI 的早期对齐工作 |
| LLaMA-2-Chat | 27.5k | 人工标注 | Meta 的高质量对话数据 |
| Vicuna | 70k | ShareGPT | 用户分享的 ChatGPT 对话 |
| Alpaca | 52k | GPT-3.5 生成 | Stanford 的开源指令数据 |
| WizardLM | 250k | ChatGPT 进化生成(Evol-Instruct) | 复杂指令数据 |
| Phi-1 | 约 180M tokens | GPT-3.5 生成的练习题 | 先在约 7B tokens”教科书级”数据上预训练,再用小规模高质量练习题微调 |
关键洞察:
- ✅ 1-10 万高质量样本通常足够
- ✅ 数据质量比数量更重要(Phi 系列的证明)
- ✅ 多样性和难度分布很关键
3.3.2 数据来源
3.3.2.1 人工标注(最高质量)
流程:
- 招募标注员:通常需要通过资格考试
- 标注指南:详细的指令编写规范
- 样本编写:标注员根据指令编写回答
- 多轮审核:质量检查和修正
- 一致性验证:多个标注员交叉验证
成本:
- 单个样本:5–20 美元(取决于复杂度)
- 10k 样本:5 万–20 万美元
- 总成本:远低于预训练(通常 < 总成本的 5%)
优势:
- ✅ 质量最高,符合人类期望
- ✅ 可控性强,能覆盖特定领域
- ✅ 适合安全关键应用
示例标注指南:
【任务】:为给定指令编写高质量回答
【要求】:
1. 准确性:事实正确,无编造信息
2. 有用性:直接回答问题,提供足够细节
3. 清晰性:结构清晰,易于理解
4. 安全性:无害、无偏见、拒绝不当请求
【格式】:
- 指令:[用户的问题或请求]
- 回答:[助手的回答,200-500字]
3.3.2.2 模型蒸馏(性价比高)
方法:使用强大模型(如 GPT-4)生成训练数据
Self-Instruct 流程(Wang et al., 2023):
- 种子指令:手工编写 100-200 个种子指令(原论文使用 175 个)
- 指令生成:用 GPT-4 生成新指令
- 回答生成:用 GPT-4 为指令生成回答
- 质量过滤:自动化 + 人工抽样验证
- 迭代扩展:重复 2-4 步
成本:
- 按 2023 年的 GPT-4 API 价格约 0.03–0.06 美元/样本,10k 样本约 300–600 美元;此后同等能力模型的 API 价格已下降一个数量级以上
- 比人工标注便宜 100 倍以上
代表工作:
- Alpaca:Stanford,52k 样本,用 text-davinci-003 生成,数据成本不到 500 美元
- Vicuna:ShareGPT 用户对话,免费
- WizardLM:Evol-Instruct 方法,自动提升复杂度
Self-Instruct实战代码:
def self_instruct_pipeline(seed_instructions, num_samples=10000):
    """用GPT-4自动生成SFT数据集 - 性价比极高的方案"""
    generated_data = []

    while len(generated_data) < num_samples:
        # Step 1: 采样种子指令作为few-shot示例
        examples = random.sample(seed_instructions, k=3)

        # Step 2: GPT-4生成新指令
        prompt = f"""Generate a new instruction similar to:
        {examples}

        New instruction:"""
        new_instruction = gpt4_generate(prompt)

        # Step 3: GPT-4生成对应回答
        response = gpt4_generate(new_instruction)

        # Step 4: 质量检查(长度、相似度、毒性)
        if quality_check(new_instruction, response):
            generated_data.append({
                'instruction': new_instruction,
                'response': response
            })

    return generated_data  # 10k样本成本约$300-600
3.3.3 前沿数据合成与过滤技术(Data Synthesis & Filtering)
为了在大规模微调中兼顾多样性与极佳的质量,现代大模型(如 Llama-3, DeepSeek)广泛使用先进的数据合成与自动化清洗技术。
3.3.3.1 Magpie:无 Prompt 的自适应指令合成
Magpie 是一种新颖的指令生成方法。传统的 Self-Instruct 需要提供“种子指令”,而 Magpie 不需要任何输入提示。
- 原理:直接利用对齐模型的聊天模板(Chat Template)的预设前缀来“引诱”模型生成用户指令。
例如,向大模型输入:
<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n由于预训练和对齐模型对该模板高度敏感,模型会自动生成一个高质量、多样化的用户提问(Instruction),随后我们将该问题输入模型以获取回答(Response)。 - 优势:生成的指令分布极其贴近人类真实使用的多样性,且完全省去了种子 Prompt 的设计成本。
3.3.3.2 多智能体协同合成(Multi-Agent Collaboration)
利用不同的智能体角色(生成者、反思者、评判者、改写者)循环优化指令数据:
- 生成者:粗筛生成初始指令-回答对。
- 反思者(Reflector):分析回答中的逻辑漏洞或事实错误,写出修改意见。
- 改写者:根据修改意见重写回答。
- 评判者(LLM-as-a-Judge):使用 GPT-4 评测质量分数(1-10分),仅保留高分数据。
3.3.3.3 自动化质量过滤策略
为了防止合成数据中存在低质、重复或有害的样本,必须实施严格的多重过滤机制:
- 困惑度过滤(PPL Filtering):计算回答文本的 Perplexity,过滤掉 PPL 过高(语无伦次)或过低(模板化复读)的文本。
- 嵌入多样性筛选(Embedding Diversity):利用
text-embedding-3-small等模型计算句向量,通过聚类(Clustering)和余弦相似度阈值,剔除彼此过于相似的样本,保证数据分布的广泛性。 - 困难度分级(Difficulty Rating):使用大模型评估指令所需的推理步数,优先保留逻辑难度高、能够激发模型深度学习能力的样本。
3.3.3.4 开源数据集
常用数据集:
| 数据集 | 规模 | 语言 | 特点 |
|---|---|---|---|
| ShareGPT | 90k | 多语言 | 真实用户与 ChatGPT 对话 |
| OpenOrca | 1M+ | 英语 | GPT-4 生成,含推理过程 |
| UltraChat | 1.5M | 英语 | 多轮对话 |
| FLAN Collection | 1,800+ 任务 | 多语言 | Google 的多任务指令集,由已有 NLP 数据集模板化而来 |
| Dolly-15k | 15k | 英语 | Databricks 员工标注 |
| Tulu 3 SFT Mix | 约 94 万 | 多语言 | AllenAI 开源的完整后训练配方所用 SFT 数据 |
3.3.4 指令类型分布
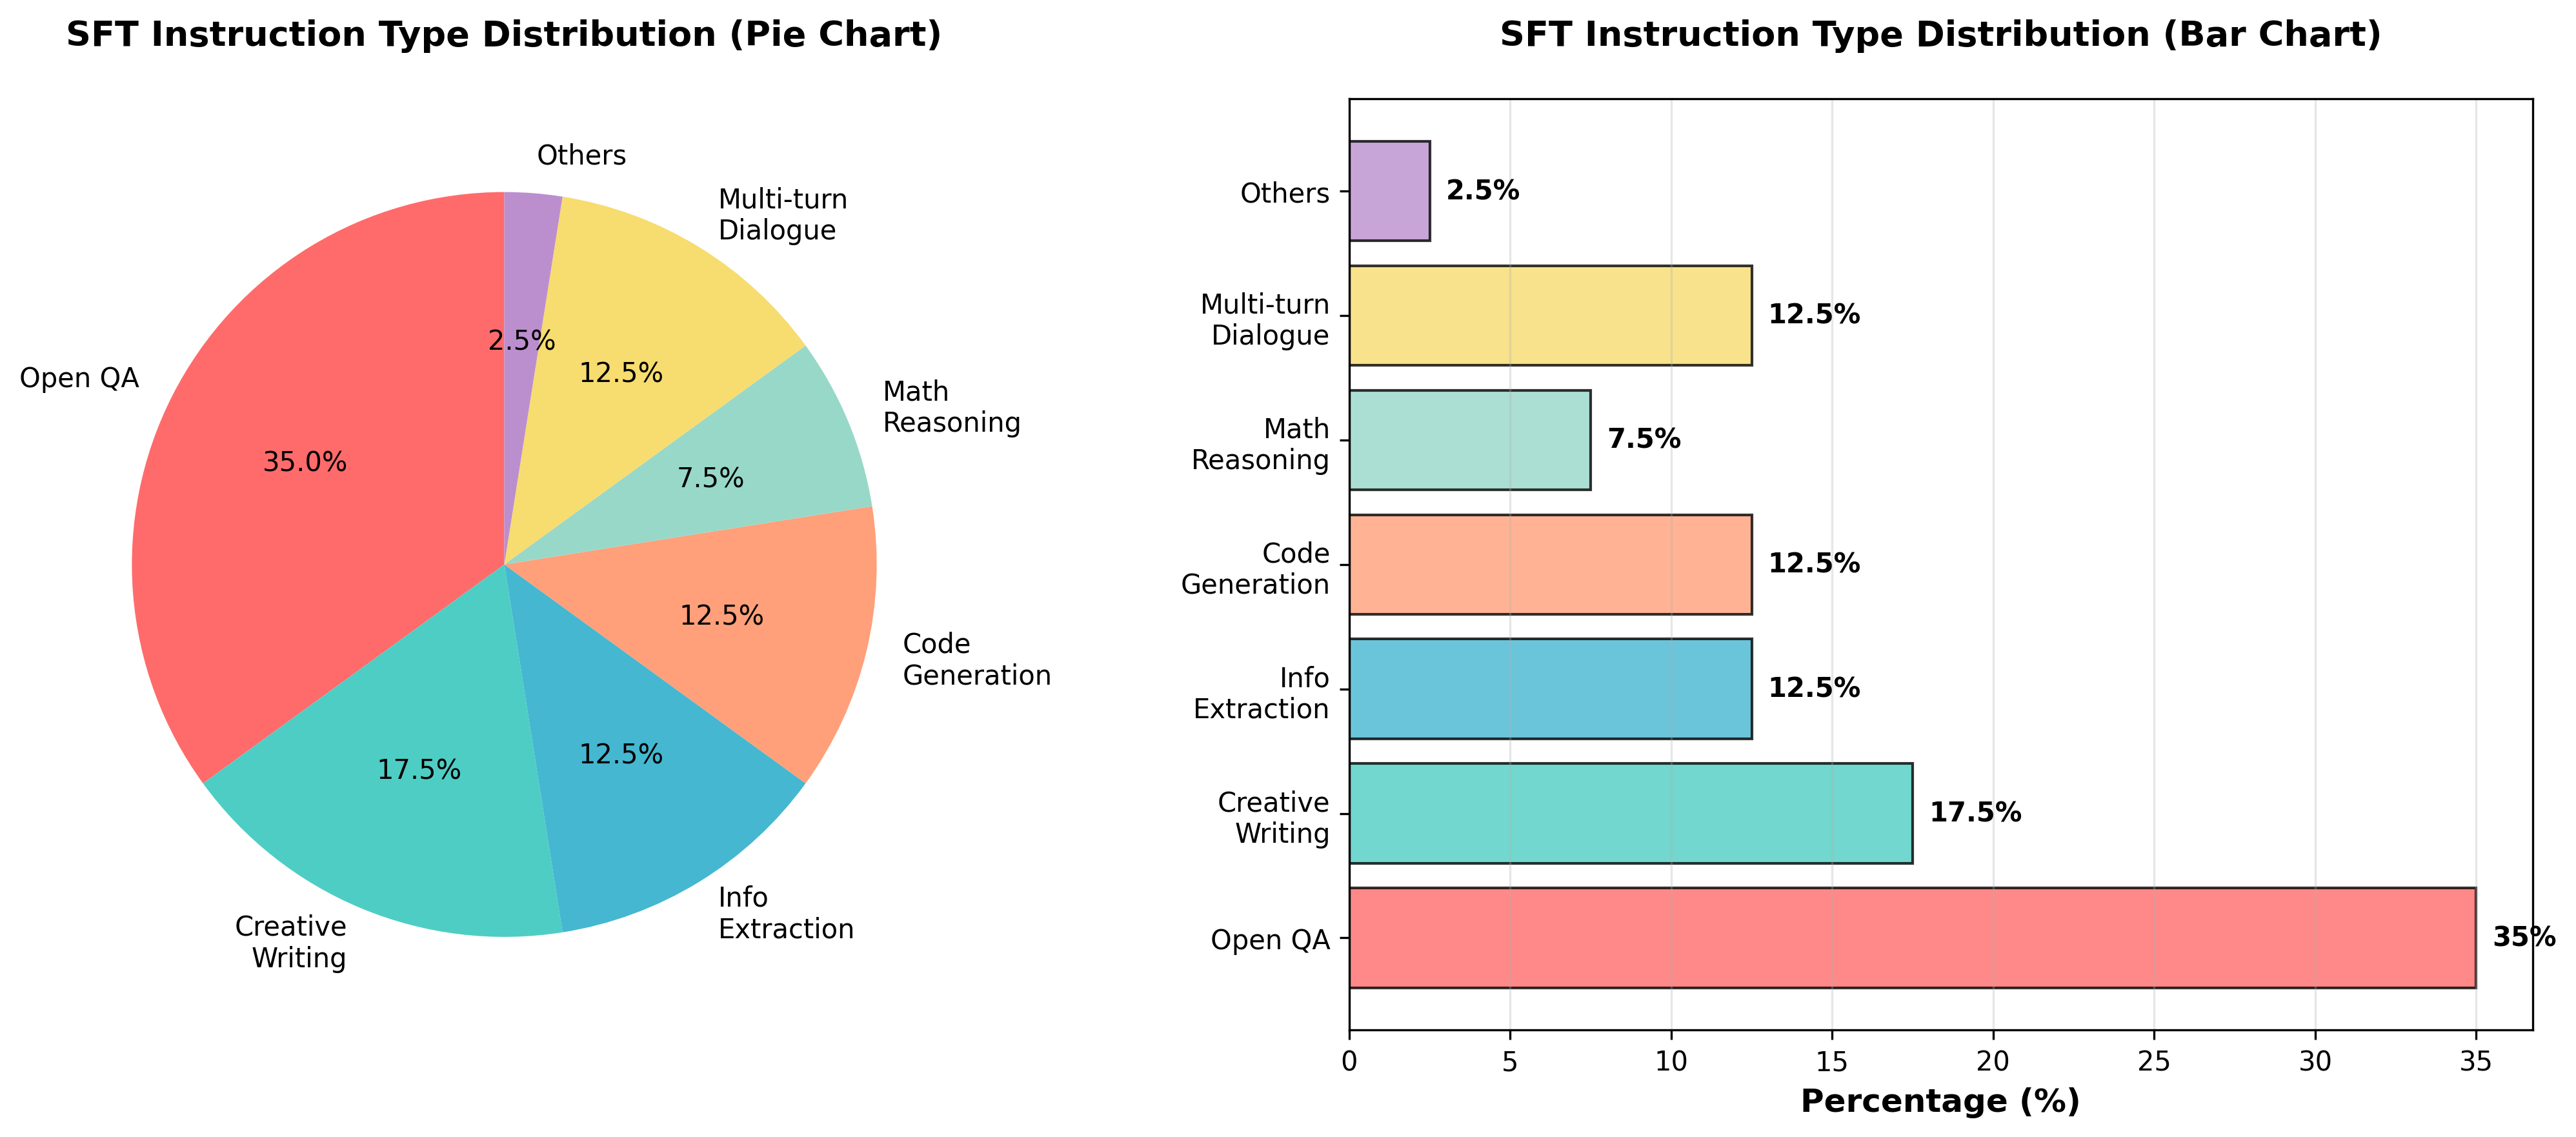
典型配比(推荐):
| 指令类型 | 占比 | 示例 |
|---|---|---|
| 开放式问答 | 30-40% | “解释什么是量子计算” |
| 创意写作 | 15-20% | “写一首关于秋天的诗” |
| 信息提取 | 10-15% | “总结这篇文章的要点” |
| 代码生成 | 10-15% | “用Python实现快速排序” |
| 数学推理 | 5-10% | “解这道微积分题” |
| 多轮对话 | 10-15% | 上下文相关的连续问题 |
| 其他任务 | 5-10% | 翻译、格式转换等 |
平衡原则:
- 覆盖主要应用场景
- 避免某类任务占比过高
- 包含不同难度级别
3.3.5 数据质量控制
自动化检查:
def quality_check(instruction, response):
    # 1. 长度检查
    if len(response) < 50 or len(response) > 2000:
        return False

    # 2. 相似度检查(去重)
    if is_similar_to_existing(response, threshold=0.9):
        return False

    # 3. 毒性检测
    if contains_toxic_content(response):
        return False

    # 4. 事实性检查(可选,使用检索增强)
    if not factual_consistency_check(response):
        return False

    return True
人工审核:
- 抽样审核:随机抽取 5-10% 进行人工检查
- 一致性验证:多个审核员评分,计算一致性
- 迭代改进:根据反馈调整数据生成策略
3.4 SFT 训练策略
3.4.1 全参数微调(Full Fine-Tuning)
方法:更新模型的所有参数
特点:
- ✅ 效果最好:充分适应新任务
- ❌ 成本最高:需要存储完整模型和梯度
- ❌ 显存需求大:通常需要 4-8 块高端 GPU
显存需求计算(与 6.5.1 节的 16 字节/参数推导一致):
总显存 = 模型参数 + 梯度 + 优化器状态 + 激活值

对于 7B 模型(BF16 混合精度 + AdamW):
- 模型参数(BF16):7B × 2 bytes = 14GB
- 梯度(BF16):    7B × 2 bytes = 14GB
- 优化器状态(FP32 主权重 + m + v):7B × 12 bytes = 84GB
- 激活值:~20-40GB(取决于 batch size 与序列长度)
总计:~132-152GB

→ 单卡放不下,至少需要 2 块 A100 (80GB) 并配合 ZeRO 分片(见 6.5 节)
适用场景:
- 有充足计算资源
- 需要最佳性能
- 任务与预训练差异较大
3.4.2 参数高效微调(PEFT)
核心思想:冻结大部分参数,只训练小部分参数或额外添加的参数
3.4.2.1 LoRA(Low-Rank Adaptation)
数学原理:
在预训练权重 $W_0 \in \mathbb{R}^{d \times k}$ 的基础上,添加低秩分解的可训练矩阵:
\[W = W_0 + \Delta W = W_0 + BA\]其中:
- $B \in \mathbb{R}^{d \times r}$,$A \in \mathbb{R}^{r \times k}$
- 秩 $r \ll \min(d, k)$(通常 $r=8, 16, 32$)
- $W_0$ 冻结,只训练 $B$ 和 $A$
参数量对比:
原始参数:d × k
LoRA 参数:d × r + r × k = r(d + k)

示例(d=4096, k=4096, r=16):
- 原始:4096 × 4096 = 16,777,216
- LoRA:16 × (4096 + 4096) = 131,072
- 比例:131k / 16.7M ≈ 0.78%

→ 只训练 <1% 的参数!
实现代码(单层原理示意):
import math
import torch
import torch.nn as nn

class LoRALinear(nn.Module):
    def __init__(self, base: nn.Linear, rank=16, alpha=32):
        super().__init__()
        # 冻结的预训练权重 W0
        self.base = base
        self.base.weight.requires_grad_(False)

        # LoRA 可训练参数:A 随机初始化,B 初始化为 0,保证训练开始时 ΔW = BA = 0
        self.lora_A = nn.Parameter(torch.empty(rank, base.in_features))
        self.lora_B = nn.Parameter(torch.zeros(base.out_features, rank))
        nn.init.kaiming_uniform_(self.lora_A, a=math.sqrt(5))

        self.scaling = alpha / rank

    def forward(self, x):
        # 原始前向传播 + 低秩修正
        return self.base(x) + (x @ self.lora_A.T @ self.lora_B.T) * self.scaling
实际项目中直接使用 Hugging Face PEFT 的 LoraConfig + get_peft_model,它负责把目标层替换成 LoRA 层、保存与合并适配器,完整示例见 8.4.1.4 节。
优势:
- ✅ 显存占用少:只需训练 <1% 参数,无需为冻结权重保存梯度和优化器状态(LoRA 论文中 GPT-3 175B 的训练显存从 1.2TB 降到 350GB)
- ✅ 存储成本低:每个任务只需保存适配器(GPT-3 175B 的 checkpoint 从 350GB 降到约 35MB)
- ✅ 可合并:训练后可以合并回原模型 $W = W_0 + BA$
- ✅ 模块化:可以为不同任务训练多个 LoRA,按需切换
超参数选择:
- 秩 r:8-64,越大效果越好但参数越多
- r=8: 最轻量,适合简单任务
- r=16-32: 推荐默认值
- r=64: 复杂任务
- alpha:常见取 alpha = r 或 2r(如 r=16, alpha=32);QLoRA 论文使用 r=64, alpha=16
- 目标模块:早期多只加在注意力投影(
q_proj,k_proj,v_proj,o_proj);QLoRA 论文与 Thinking Machines 的 LoRA Without Regret(2025)都发现,覆盖全部线性层(含 MLP 的gate_proj,up_proj,down_proj) 效果明显更接近全参数微调
⚠️ LoRA 与灾难性遗忘
许多人认为 LoRA 可以防止遗忘,但研究表明:LoRA learns less and forgets less——LoRA 之所以遗忘少,是因为它学到的东西也更少,并非真正解决了遗忘。Rank 越大 → 学得越多 → 忘得也越多,与全参数微调差异缩小。详见本文「Post-Training 与灾难性遗忘」章节。
3.4.2.2 QLoRA(Quantized LoRA)
核心创新:把冻结的基座权重量化为 4-bit,再在其上训练 LoRA。7B 模型的微调显存可从 ~24GB(16-bit LoRA)压缩到 ~9GB,65B 模型可在单块 48GB GPU 上微调(QLoRA 论文)。核心技术包括 4-bit NF4 量化、双重量化(Double Quantization)和分页优化器(Paged Optimizers)。
详细原理、显存对比与完整代码实现参见「模型量化技术 → QLoRA:4-bit量化 + LoRA微调」一节,此处不再重复。
3.4.2.3 其他 PEFT 方法
Prefix Tuning:
- 在输入前添加可训练的 prefix token
- 只优化 prefix embedding
- 参数量:~0.1% 的原模型
Adapter Layers:
- 在 Transformer 层间插入小型适配器(2 层 MLP)
- 只训练 adapter 参数
- 参数量:~2-4% 的原模型
3.4.3 指令模板(Instruction Template)
设计统一的输入输出格式:
| 标记 | 角色 | 示例内容 |
|---|---|---|
<|system|> |
系统提示 | You are a helpful assistant. |
<|user|> |
用户输入 | What is the capital of France? |
<|assistant|> |
模型回答 | The capital of France is Paris. |
常见模板格式:ChatML、Alpaca、Vicuna、Llama-2-Chat 等各有不同的特殊标记。
3.4.4 训练超参数
- 学习率:全参数微调通常小于预训练(1e-5 到 5e-5);LoRA 需要更大的学习率(常见 1e-4 到 2e-4)
- Epoch数:1-3个epoch
- Batch Size:根据资源调整
- Warmup比例:3–10%
3.5 SFT的前沿技术
3.5.1 小数据、高质量训练
3.5.1.1 Phi系列的启示
- Phi-1:1.3B 参数、约 7B tokens 的”教科书级”数据,HumanEval pass@1 达到 50.6%,超过参数量大 10 倍以上的 StarCoder-15B(33.6%)
- Phi-3:3.8B 参数的 Phi-3-mini 在多项基准上与 Mixtral 8x7B、GPT-3.5 相当
- 核心策略:
- 用 GPT-3.5 合成”教科书式”数据,并用 GPT-4 标注训练质量分类器筛选网页代码
- 严格的质量过滤和多样性控制
- 证明数据质量 > 数据规模
3.5.1.2 课程学习策略
- 从简单到复杂逐步提升难度
- 分层次的指令数据组织
- 动态调整数据配比
3.5.2 合成数据生成
用强模型直接生成指令-回答对的基本做法(Self-Instruct)见 3.3.2.2 节,更新的 Magpie、多智能体合成与自动过滤见 3.3.3 节。本节补充两类针对”难度”与”推理过程”的合成方法。
3.5.2.1 Evol-Instruct方法
- WizardLM:自动提升指令复杂度
- 指令进化策略
- 大幅提升指令跟随能力
3.5.2.2 推理过程数据
- Orca系列:生成详细的推理步骤
- 解释型数据增强
- 提升小模型的推理能力
3.5.3 量化微调加速
QLoRA、GPTQ、AWQ 等量化方法的原理与对比已在「模型量化技术」整章详细介绍,本节聚焦 SFT 场景下专门用于加速量化微调的工具——Unsloth。
3.5.3.1 Unsloth:高效微调加速库
Unsloth 是目前最流行的 LoRA/QLoRA 加速库,通过重写底层 CUDA kernel 实现了显著的提速和省显存效果:
- 🚀 速度:训练速度提升约 2×(无精度损失)
- 💾 显存:VRAM 占用减少约 70%
- 🔌 兼容:与 Hugging Face PEFT/TRL 完全兼容,几乎零迁移成本
- 🤖 支持模型:Llama、Qwen、Mistral、Gemma、Phi 等 500+ 模型
快速上手(将 get_peft_model 替换为 Unsloth 版本即可):
from unsloth import FastLanguageModel

# 加载模型(支持4-bit QLoRA)
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="unsloth/llama-3-8b",
    max_seq_length=2048,
    load_in_4bit=True,    # 4-bit QLoRA,显存减少75%
)

# 添加LoRA适配器(与PEFT接口一致)
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
    lora_alpha=16,
    lora_dropout=0,
    use_gradient_checkpointing="unsloth",  # Unsloth专有:支持更长上下文
)

# 使用标准TRL SFTTrainer(无需修改训练代码)
from trl import SFTTrainer
trainer = SFTTrainer(model=model, ...)
trainer.train()
💡 适用场景:消费级 GPU(RTX 3090/4090)上的 7B–70B 模型 LoRA/QLoRA 微调;GRPO 强化学习训练(官方数据显存节省约 80%)。上面的速度与显存数字均来自 Unsloth 官方,实际收益随模型与序列长度变化。
4. 偏好对齐阶段(Preference Alignment)
对齐阶段让模型输出符合人类偏好、价值观和安全准则。
🎯 本章导读
偏好对齐是从”能用”到”好用”的关键一跃,通过RLHF、DPO或最新的 GRPO 等技术让模型输出更有帮助、更安全、更符合人类价值观。本章详细对比RLHF、DPO和GRPO的原理、优劣。推荐:简单任务优先使用DPO,复杂推理任务及资源受限场景优先考虑GRPO。
4.1 RLHF(Reinforcement Learning from Human Feedback)
论文来源:Training language models to follow instructions with human feedback (InstructGPT)
4.1.1 RLHF 三阶段流程
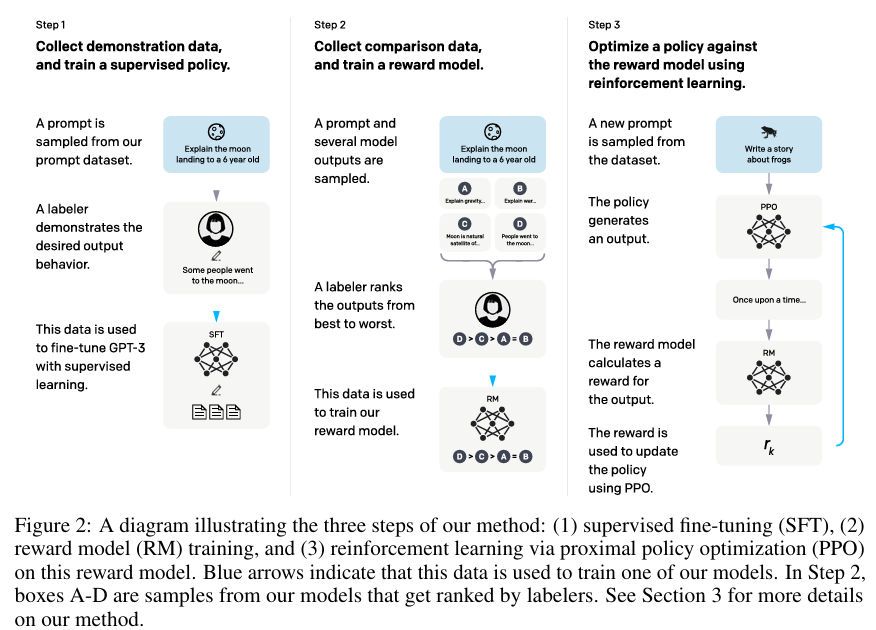
三个关键步骤:
4.1.1.1 Step 1: 收集偏好数据
- 采样多个模型输出(通常4-9个候选回答)
- 人工标注员对回答质量排序
- 构建偏好对比数据集:$(x, y_w, y_l)$
- 数据规模:InstructGPT 的奖励模型数据约 33k 条 prompt,每条对 4–9 个回答排序,可展开成大量两两比较对
4.1.1.2 Step 2: 训练奖励模型(Reward Model)
- 使用偏好数据训练打分模型
- 输入:prompt $x$ + response $y$
- 输出:标量质量分数 $r(x, y)$
- 目标:预测人类偏好排序
- 架构:通常基于 SFT Model,替换 LM head 为标量输出层
4.1.1.3 Step 3: PPO强化学习优化
- 使用 PPO(Proximal Policy Optimization)优化策略
- 奖励信号:Reward Model 评分
- KL 散度约束:\(\beta \cdot D_{\text{KL}}(\pi_\theta \Vert \pi_{\text{ref}})\) 防止偏离 SFT 模型过远
- 需要的模型:Policy Model、Reference Model、Reward Model、Critic Model(共4个)
4.1.2 RLHF 的挑战
- ❌ Reward Hacking:模型可能学会exploit RM的弱点而非真正提升质量
- ❌ 训练不稳定:RL 训练本身容易发散
- ❌ 计算开销大:需同时运行 4 个大模型
- ❌ 人类标注成本高:每个偏好标注约 0.5–2 美元
4.2 DPO(Direct Preference Optimization)
论文来源:Direct Preference Optimization: Your Language Model is Secretly a Reward Model
4.2.1 DPO vs RLHF 对比
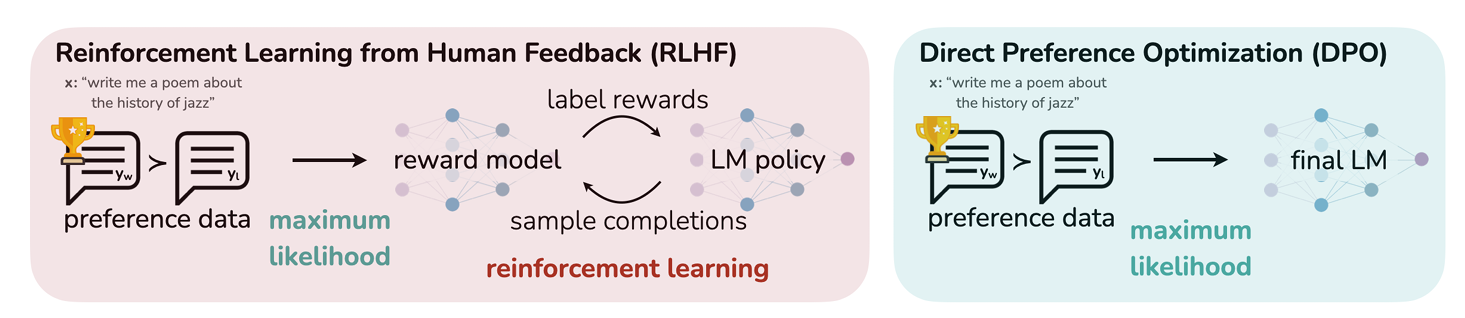
4.2.2 核心创新
关键洞察:将 Reward Model 隐式地参数化到策略模型中,无需显式训练 RM。
DPO 损失函数:
\[\mathcal{L}_{\text{DPO}} = -\mathbb{E}_{(x,y_w,y_l)} \left[ \log \sigma \left( \beta \log \frac{\pi_\theta(y_w | x)}{\pi_{\text{ref}}(y_w | x)} - \beta \log \frac{\pi_\theta(y_l | x)}{\pi_{\text{ref}}(y_l | x)} \right) \right]\]直观理解:
- ✅ 增加模型对好回答 $y_w$ 的概率
- ❌ 降低模型对差回答 $y_l$ 的概率
- 🔒 通过 $\beta$ 控制相对于参考模型的变化幅度
4.2.3 DPO 的优势
| 维度 | RLHF | DPO |
|---|---|---|
| 训练阶段 | 3步(数据→RM→PPO) | 2步(数据→直接优化) |
| 模型数量 | 4个模型 | 2个模型 |
| 训练稳定性 | 较低(RL不稳定) | ✅ 高(监督学习) |
| 计算开销 | 大 | ✅ 小(节省50%+) |
| 实现复杂度 | 高(需要RL库) | ✅ 低(标准优化) |
| Reward Hacking | 容易发生 | ✅ 较少(但仍会过度优化) |
| 效果 | 调优充分时往往更强 | ✅ 多数场景相当,实现简单得多 |
注:DPO 与 PPO 孰优孰劣并无定论。Xu et al.(2024)的系统对比发现,调优充分的 PPO 在对话与代码任务上仍可超过 DPO;DPO 的主要优势在于工程简单、训练稳定。
4.2.4 DPO 的变体
- IPO(Identity Preference Optimization):把 DPO 的 log-sigmoid 损失换成平方损失,缓解偏好接近确定时的过拟合
- KTO(Kahneman-Tversky Optimization):基于前景理论,只需”好/坏”的单条标签,不需要成对数据
- ORPO(Odds Ratio Preference Optimization):将 SFT 和偏好优化合并为单阶段,无需参考模型
- SimPO(Simple Preference Optimization):用长度归一化的平均对数概率作为隐式奖励,同样去掉了参考模型
- RRHF(Rank Responses to align Human Feedback):使用排序损失
4.3 RLAIF(RL from AI Feedback)
论文来源:RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback
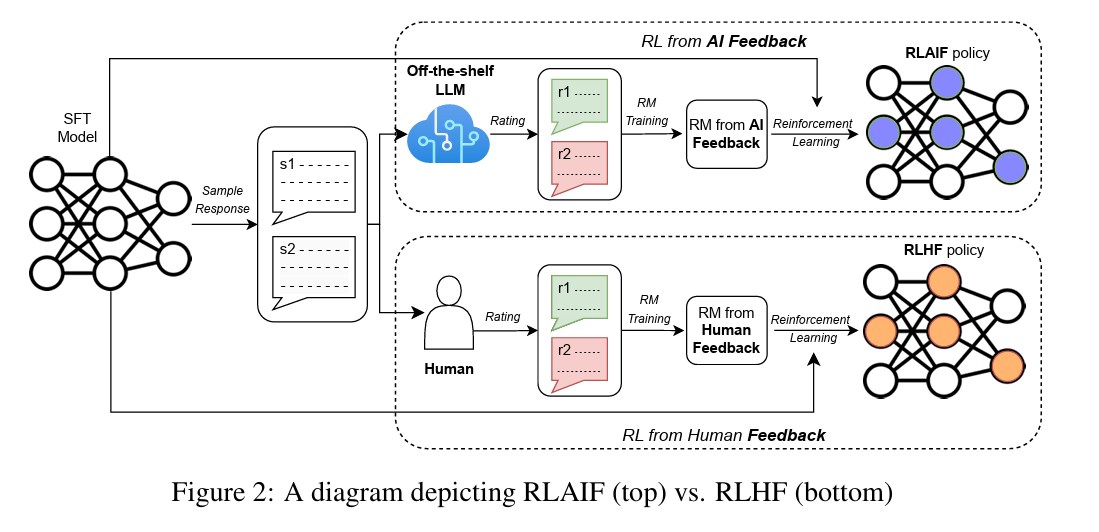
4.3.1 核心思想
用强大的 AI 模型(如 GPT-4)替代人类标注偏好数据
工作流程:
- AI 标注器生成偏好:使用 GPT-4 等模型对候选回答进行评分和排序
- 训练 Reward Model:基于 AI 标注的偏好数据训练 RM
- RL 优化:使用 PPO 或 DPO 进行策略优化
4.3.2 优势
- ✅ 成本低:无需人工标注,节省 90%+ 成本
- ✅ 可扩展:可以生成大规模偏好数据
- ✅ 质量高:实验表明效果接近甚至超过 RLHF
- ✅ 一致性好:AI 标注比人类更一致
4.3.3 挑战
- AI 标注器的偏见会传递给对齐模型
- 需要高质量的 AI 标注器(如 GPT-4)
4.4 Constitutional AI
论文来源:Constitutional AI: Harmlessness from AI Feedback
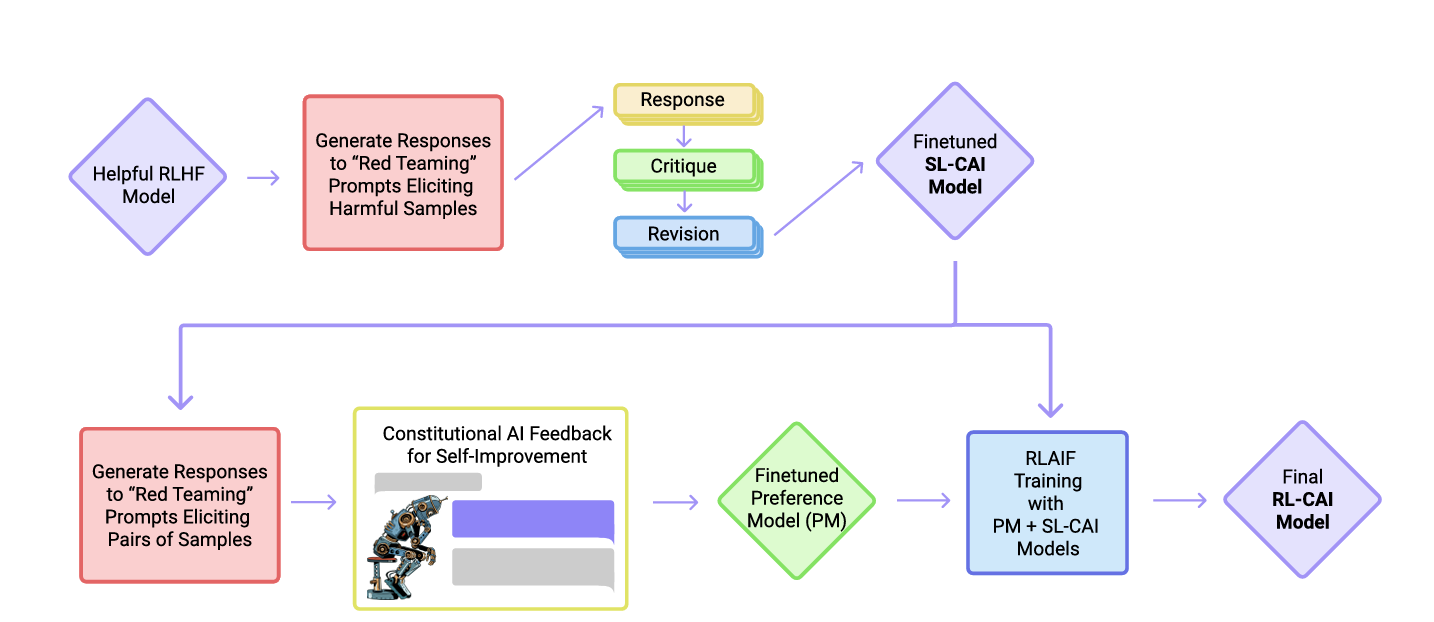
4.4.1 核心理念
让 AI 系统遵循明确的行为准则(Constitution),通过自我批评和修正实现对齐
4.4.2 两阶段训练
4.4.2.1 第一阶段:监督学习(SL-CAI)
- 生成初始回答:模型生成对有害指令的回答
- 自我批评:模型根据 Constitution 评估自己的回答
- 自我修正:模型生成改进版本的回答
- 监督学习:在修正后的数据上进行 SFT
4.4.2.2 第二阶段:强化学习(RL-CAI)
- AI 反馈:使用模型评估不同回答相对于 Constitution 的符合度
- 偏好数据:构建 AI 标注的偏好对
- RL 训练:使用 RLAIF 进行偏好对齐
4.4.3 Constitution 示例
- “请选择最有帮助、诚实且无害的回答”
- “请选择不鼓励非法、不道德或不当行为的回答”
- “请选择最能表现出关心、尊重和考虑的回答”
4.4.4 优势
- ✅ 透明可控:行为准则明确且可调整
- ✅ 自主对齐:减少对人类反馈的依赖
- ✅ 可扩展:容易扩展到新的价值观和准则
- ✅ 效果好:不使用任何人工有害性标签,就得到了比 RLHF 基线更无害、同时更少回避问题(less evasive)的模型
4.5 GRPO(Group Relative Policy Optimization)与推理模型训练
论文来源:DeepSeekMath(GRPO 首次提出) / DeepSeek-R1(大规模推理 RL 实践)
GRPO 由 DeepSeek 在 DeepSeekMath(2024)中提出。随着 DeepSeek-R1 的开源,GRPO 及其改进版本(见 4.6.4 节)成为开源社区训练强推理模型(Reasoning Models)最常用的 RL 算法。
4.5.1 GRPO 的核心创新与显存优化
在传统的 PPO(Proximal Policy Optimization)算法中,为了计算优势函数(Advantage Function)以指导策略更新,必须加载一个与策略模型同等大小的价值网络(Critic Model,即 Value Network)来估计每个中间状态的价值。这意味着训练时显存需要同时容纳四个超大模型:
\[\text{Policy (Active)} + \text{Reference (Frozen)} + \text{Reward (Frozen)} + \text{Critic (Active)}\]在超大参数量模型下,这导致显存和计算资源产生极高壁垒,经常发生 OOM,甚至由于 Critic 网络的估计偏差导致强化学习训练极不稳定。
GRPO 的解决方案:通过群体相对评分(Group Relative Scoring)来估算优势,完全取消了 Critic 网络。
4.5.1.1 组内相对优势计算公式
对同一个输入 Prompt $x$,策略模型(Policy)并行采样 $G$ 个回答组成一个组(Group):${y_1, y_2, \ldots, y_G}$。使用评分函数或奖励模型分别计算这 $G$ 个回答的奖励得分 ${r_1, r_2, \ldots, r_G}$。每个回答 $y_i$ 的组内相对优势(Advantage)$A_i$ 定义为:
\[A_i = \frac{r_i - \text{mean}(r_1, r_2, \ldots, r_G)}{\text{std}(r_1, r_2, \ldots, r_G)}\]随后,利用这些优势计算 Policy 的梯度更新公式为:
\[\mathcal{L}_{\text{GRPO}}(\theta) = \frac{1}{G} \sum_{i=1}^{G} \left[ \min \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)} A_i, \, \text{clip} \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)}, 1-\epsilon, 1+\epsilon \right) A_i \right) - \beta \, \mathbb{D}_{\text{KL}}(\pi_\theta || \pi_{\text{ref}}) \right]\]其中 \(\mathbb{D}_{\text{KL}}\) 用于惩罚当前策略偏离参考模型(Reference Model)的程度,防止模型“跑偏”。组内归一化天然消除了不同 Prompt 之间奖励绝对值悬殊带来的梯度不稳定性。上式是序列级的简写,原论文在每个回答内部按 token 计算比率并取平均。
4.5.1.2 GRPO 与 PPO 显存对比
graph TD
    subgraph PPO["PPO 训练显存占用:需加载 4 个模型"]
        PPO_Actor["Policy 模型 (Trainable)<br/>参数量: Ψ"]
        PPO_Critic["Critic 模型 (Trainable)<br/>参数量: Ψ"]
        PPO_Ref["Reference 模型 (Frozen)<br/>参数量: Ψ"]
        PPO_Reward["Reward 模型 (Frozen)<br/>参数量: Ψ"]
    end

    subgraph GRPO["GRPO 训练显存占用:仅需 2 个模型"]
        GRPO_Policy["Policy 模型 (Trainable)<br/>参数量: Ψ"]
        GRPO_Ref["Reference 模型 (Frozen)<br/>参数量: Ψ"]
        GRPO_Rule["规则验证器 / 外部 API<br/>显存占用: 0"]
    end

    style PPO_Actor fill:#f8d7da,stroke:#f5c6cb
    style PPO_Critic fill:#f8d7da,stroke:#f5c6cb
    style PPO_Ref fill:#e2e3e5,stroke:#d6d8db
    style PPO_Reward fill:#e2e3e5,stroke:#d6d8db

    style GRPO_Policy fill:#d4edda,stroke:#c3e6cb
    style GRPO_Ref fill:#e2e3e5,stroke:#d6d8db
    style GRPO_Rule fill:#fff3cd,stroke:#ffeeba
这种群体内的自我对比,去除了价值网络(Critic)和黑盒奖励模型(Reward Model,可被低显存规则器替代),节省了约 50%–70% 的训练显存开销,是大模型强化学习平民化的关键里程碑。
| 特性 | RLHF (PPO) | GRPO |
|---|---|---|
| 模型数量 | 4个(Policy, Ref, RM, Critic) | ✅ 2个(Policy, Ref) |
| 显存消耗 | 极高(需加载多个模型) | ✅ 显著降低(节省约50%-70%) |
| 奖励函数 | 依赖复杂的神经网络 RM | ✅ 支持确定性规则评分(如编译通过率、测试用例) |
| 推理任务表现 | 一般 | ✅ 极强(DeepSeek-R1 的核心技术) |
| 训练稳定性 | 较低(容易崩溃) | ✅ 较高(组内归一化降低方差) |
4.5.2 推理模型的对齐范式(DeepSeek-R1 实践)
在传统的 SFT 阶段,模型只是被动地“背诵”人类写好的推理步骤。而通过强化学习(如 GRPO),模型可以在没有人类示范的情况下,自主探索出最优的解题路径。
根据 DeepSeek-R1 的成功经验,强推理模型的训练遵循以下四阶段对齐流程:
[阶段一: 冷启动SFT] -> 收集数千条高质量长CoT数据,帮助模型建立基本的思考习惯(输出 <think>...</think> 格式)
      |
[阶段二: 推理RL训练] -> 使用 GRPO 算法,通过规则打分(正则匹配结果、编译器验证)让模型自主探索
      |                 * 现象:模型自发学会"自我纠错"、"重新反思"(Aha Moments)并延长思考长度
      |
[阶段三: 拒绝采样与再次SFT] -> 采样 RL 阶段高质量的推理链数据,混合通用数据(写作、安全、翻译)进行二次 SFT
      |
[阶段四: 通用偏好RL] -> 对最终模型进行安全与人类偏好对齐,解决推理模型"难以拒绝恶意请求"或"答非所问"的问题
4.5.2.1 推理 RL 的奖励规则配置
在推理阶段,尽量避免使用黑盒的主观神经网络奖励模型(RM),而使用客观、硬性的规则验证器(Rule-Based Verifiers):
- 准确性奖励(Accuracy Reward):对于数学题,用正则表达式提取最后一对标记(如
\boxed{...})中的答案,与标准答案比对;对于代码题,将代码送入沙箱编译器运行测试用例。 - 格式奖励(Format Reward):要求模型将思考过程包裹在
<think>和</think>标签内,符合格式才给奖励。DeepSeek-R1 的推理 RL 只用了准确性与格式两类规则奖励。
4.5.3 过程监督(PRMs)与结果监督(ORMs)
对于多步推理任务,如何给模型提供精准的反馈(Credit Assignment)是强化学习的核心挑战。
4.5.3.1 结果监督(Outcome-supervised Reward Model, ORM)
- 原理:仅对最终输出的答案对错进行奖励(0 或 1)。
- 优点:标注成本极低(只需知道最终答案)。
- 缺点:稀疏奖励(Sparse Reward)。当推理步骤很长(如 50 步)时,模型很难知道中间哪一步走错了。容易导致模型为了凑出正确答案而写出错误的推理步骤(即“隐性幻觉”)。
4.5.3.2 过程监督(Process-supervised Reward Model, PRM)
- 原理:对模型生成的推理链中的每一个中间步骤进行独立评分(Step-by-step scoring)。
- 优点:密集奖励(Dense Reward)。能有效识别并惩罚中间步骤中的伪逻辑和概念偷换,显著提升数学与符号推理的严密性。
- 缺点:数据获取成本高。OpenAI 的 PRM800K 需要人工逐步标注约 80 万个步骤标签;Math-Shepherd 等工作改用蒙特卡洛展开自动估计每一步的正确率,但会引入噪声。
工业界实践:DeepSeek-R1 报告把 PRM 列为”未成功的尝试”之一——细粒度步骤难以定义、自动标注不可靠,而且神经网络奖励模型容易被 reward hacking。因此在 GRPO 训练中,对能自动验证的学科(数学、代码)通常优先采用确定性的结果奖励(ORM/规则验证器),配合长度和格式约束,让模型通过大量采样自己摸索正确的中间过程;PRM 更多用于推理时的候选重排(Best-of-N)。
4.5.4 推理时计算扩展(Test-Time Compute Scaling)
在 R1/o1 时代之前,大模型遵循训练期 Scaling Laws(即模型能力主要取决于训练参数量和 Token 数)。而推理模型引入了全新的维度——推理期 Scaling Laws (Test-Time Compute Scaling)。
- 核心理念:通过增加推理阶段的计算资源(让模型“想得更久、试得更多”),在参数量不变的情况下显著提升复杂任务的准确率。
- 主要实现技术:
- 系统 2 思考(System 2 Thinking):通过 RL 机制,模型被训练去生成极长的内部思维链(CoT),以换取更高概率的正确结果。
- 蒙特卡洛树搜索(MCTS):在生成过程中,对不同的推理分叉进行多路径探索,评估每一步的分数并回溯,选择最优的搜索树路径。
- 拒绝采样 / 多路投票(Rejection Sampling / Best-of-N):在推理时采样 $N$ 个结果,利用多数投票(Self-Consistency)或轻量级评分模型选出最佳答案。
4.5.4.1 实证数据:思考长度与准确率的关系
OpenAI 在 o1 的发布博客中给出了”训练期计算量”与”推理期计算量”两条独立的 scaling 曲线;DeepSeek-R1 报告则观察到,RL 训练过程中模型的平均回答长度与 AIME 准确率同步上升。两者呈现出相似的规律:
- 训练期计算量增加 → 模型在数学/代码基准上的准确率随训练 FLOPs 呈对数线性提升(与传统 Scaling Law 一致)
- 推理期计算量增加(即允许模型生成更长的思维链)→ 在同一个训练好的模型上,仅靠”多想一会儿”,准确率同样随推理 token 数呈近似对数线性提升,且在数学竞赛题(如 AIME)等高难度任务上,两条曲线的提升幅度可以相当
这意味着”训练一个更大的模型”和”让现有模型想得更久”在一定范围内是可相互替代的两种提升手段,这正是 Test-Time Compute Scaling 被称为”第二条 Scaling Law”的原因。
4.5.4.2 o1/o3 与 R1 的路线对比
| 维度 | OpenAI o1/o3 | DeepSeek-R1 |
|---|---|---|
| 思维链可见性 | 不对外展示完整 CoT,仅展示摘要(担心被蒸馏/竞品复制思路) | 完整开源思维链格式(<think>...</think>),并直接开源模型权重 |
| 训练细节披露 | 技术报告披露有限,RL 算法细节未公开 | 技术报告披露 GRPO 算法细节、冷启动 SFT 与四阶段对齐流程(4.5.2节) |
| 小模型蒸馏 | 未开源蒸馏小模型 | 同步开源基于 Qwen/Llama 蒸馏的多个尺寸小模型(4.8节) |
| 行业影响 | 确立了 Test-Time Compute Scaling 范式 | 验证了”开源 + 低成本”也能达到第一梯队推理水平,加速了 GRPO 成为行业标准 |
趋势观察:R1 之后,Claude 3.7 Sonnet、Gemini 2.5、Qwen3 等模型普遍采用”思考/非思考模式切换”或”思考预算”的设计——同一模型可根据任务难度动态决定是否启用长 CoT,避免简单任务也强制消耗大量推理 token,这是 Test-Time Compute Scaling 在工程落地上的进一步优化(按需分配推理算力,而非一刀切)。
4.5.5 对齐税与推理冲突(Alignment Tax vs. Reasoning)
在偏好对齐中,存在一个著名的“对齐税(Alignment Tax)”现象:过度的安全性或人类偏好对齐,会显著损害模型原有的逻辑推理和指令遵循能力。
- 推理冲突:安全对齐通常训练模型“遇到敏感话题直接拒绝”。但对于复杂的推理模型,如果用户询问一个涉及网络安全(例如“分析这段恶意软件代码的漏洞以修复它”)的复杂逻辑题,过于敏感的安全过滤器会直接触发拒绝回答,导致推理能力无法发挥。
- 解决策略:
- 解耦安全与推理:在推理 RL 阶段(阶段二)完全专注于逻辑与正确性,暂不引入过多的安全约束,允许模型生成所有可能路径。
- 在最后的通用偏好对齐中引入安全语料:在阶段四通过对比样本(Chosen/Rejected),教会模型区分“学术性逻辑分析”与“实质性恶意协助”,实现精准拒绝。
4.6 RL 训练工程基础设施(Rollout Infra & 算法演进)
GRPO 等算法只是 RL 训练的”数学公式”,真正把它跑起来需要一整套工程系统。本节补充推理模型 RL 训练中绕不开的工程问题,以及 GRPO 之后业界提出的若干改进算法。
4.6.1 Rollout 与训练的协同架构
一次 RL 迭代包含两个性质完全不同的计算任务:
[Rollout 阶段] Policy 模型对一批 Prompt 并行采样 G 个回答(自回归生成,属于推理负载)
      ↓
[评分阶段]   规则验证器 / Reward Model 对采样结果打分
      ↓
[训练阶段]   用打分结果计算 GRPO loss,反向传播更新 Policy 参数(属于训练负载)
- Rollout 是推理密集型任务:长 CoT 推理模型单次采样可能生成数千 token,G 通常取 8-64,对单个 Prompt 就要生成数万 token,自回归生成的 KV Cache 管理、批处理调度直接决定了 RL 训练的吞吐上限
- 同步 vs 异步:同步式(每轮先等所有 Rollout 完成再训练)实现简单但 GPU 利用率低(训练时 Rollout 引擎空闲,反之亦然);异步式(Rollout 与训练流水线重叠,类似生产者-消费者模式)吞吐更高,但需要处理”训练参数更新后,正在进行的 Rollout 用的是旧策略”的 off-policy 偏差问题
4.6.2 用推理引擎加速 Rollout:vLLM / SGLang
业界主流做法是用专门的高吞吐推理引擎(而非训练框架自带的 generate 方法)承担 Rollout 任务:
- vLLM:基于 PagedAttention 管理 KV Cache,支持高并发批处理采样,是目前 OpenRLHF、verl 等开源 RL 训练框架的默认 Rollout 后端
- SGLang:RadixAttention 实现前缀 KV Cache 复用,对”同一 Prompt 采样 G 个回答”这种 RL 训练的典型负载(共享前缀、仅后续生成不同)有天然优势(vLLM 也已支持自动前缀缓存,两者的差距取决于具体负载)
- 权重同步:训练框架(如 DeepSpeed/Megatron)更新参数后,需要将新权重同步给推理引擎(通常通过 NCCL 广播或共享显存),权重同步的延迟是异步 RL 系统的关键瓶颈之一
4.6.3 Reward 服务化
当 Reward 来自规则验证器(如代码沙箱编译执行、数学答案正则匹配)而非神经网络打分时,工程上通常将其拆分为独立的微服务:
- 代码类任务:Rollout 生成的代码需要送入隔离的沙箱环境执行测试用例,需考虑沙箱并发数、超时控制与安全隔离(防止生成的代码访问宿主机资源)
- 数学类任务:用符号计算库(如 SymPy)或专门的答案匹配规则解析
\boxed{}内容,避免简单字符串匹配导致的误判(如等价但格式不同的答案被判错) - 服务化的好处:Reward 计算与 Rollout/训练解耦,可以独立扩缩容,避免成为整个 RL 流水线的瓶颈
4.6.4 GRPO 之后的改进算法
GRPO 并非终点,2024-2025 年业界针对其训练不稳定性和效率问题提出了多个改进:
| 算法 | 核心改进 | 解决的问题 |
|---|---|---|
| DAPO(Decoupled Clip and Dynamic Sampling PO) | 解耦上下裁剪阈值(高低 clip 范围不同)+ 动态采样过滤掉全对/全错的”零梯度”组 | GRPO 在组内回答全部正确或全部错误时优势退化为 0,浪费大量采样算力 |
| GSPO(Group Sequence Policy Optimization) | 将重要性采样比率从 token 级别改为序列级别计算 | GRPO 的 token 级比率在长序列上方差大,训练不稳定,尤其影响 MoE 模型 |
| VAPO(Value-model Augmented PO) | 重新引入轻量价值函数,结合长度自适应 GAE | 纯 Group-Relative 方式在长 CoT、稀疏奖励场景下方差仍偏大 |
| Dr. GRPO(GRPO Done Right) | 去掉按回答长度归一化与按组内标准差归一化 | 原始 GRPO 的归一化会偏向更长的错误回答,导致回答长度虚高 |
实践建议:对大多数团队而言,GRPO + 规则奖励仍是性价比最高的起点;当观察到训练后期组内奖励同质化严重(全对/全错样本占比上升、有效梯度信号变少)时,再考虑引入 DAPO 式的动态采样过滤。
4.7 合成数据与 Self-Play:推理模型的数据飞轮
GRPO 类 RL 训练的数据需求与 SFT 不同——不需要人工写好的”标准答案推理过程”,只需要”可自动判定对错的题目”。这催生了 2024-2025 年兴起的自我对弈式数据生成(Self-Play Data Synthesis),与第 4.5-4.6 节的推理模型训练形成完整闭环。
4.7.1 STaR(Self-Taught Reasoner)
核心思路:让模型自己生成推理链,用最终答案是否正确来筛选”好的推理链”,再用筛选后的数据自我训练。
1. 模型对题目生成推理链 + 答案
2. 答案正确 → 该推理链作为高质量 SFT 数据保留
3. 答案错误 → 把正确答案"倒着"提示给模型,让它生成"事后解释"式的推理链(rationalization)
4. 用保留+生成的数据重新训练模型,重复迭代
这本质上是 RL 之前的一种”伪强化学习”方法——用结果对错筛选数据,再做监督学习,是后续 ReST、GRPO 冷启动数据构造的思想源头。
4.7.2 ReST(Reinforced Self-Training)
ReST 将 STaR 的思路系统化为两阶段循环:
- Grow(生长):用当前策略模型大量采样,生成候选数据池
- Improve(提升):用奖励函数过滤数据池,在筛选后的高质量数据上做若干轮离线监督微调(而非每步都做在线 RL 更新)
相比标准 RL,ReST 的”批量生成 + 批量过滤 + 离线训练”模式对计算资源的要求更灵活,适合没有完整在线 RL 基础设施的团队。
4.7.3 验证器驱动的数据飞轮(Verifier-Driven Data Flywheel)
代码和数学是 Self-Play 最容易落地的领域,因为存在客观验证器(编译器/测试用例、符号计算库):
[模型生成大量候选题解] → [验证器自动判定对错] → [正确解 = 高质量训练数据]
        ↑                                                    ↓
        └──────────── 用新数据重新训练模型,能力提升 ──────────────┘
这一飞轮与 4.5.3 节的 ORM(结果监督)和 4.6.3 节的 Reward 服务化共享同一套基础设施——验证器既用于 RL 训练中的实时打分,也用于离线批量生成 SFT/拒绝采样数据,是 DeepSeek-R1、Qwen 系列推理模型数据构造的共同范式。
局限:Self-Play 数据飞轮高度依赖”客观可验证”的任务类型(数学、代码、有明确规则的逻辑题),对开放式写作、主观判断类任务收益有限,仍需人工或 RLAIF 数据补充。
4.8 知识蒸馏:从推理模型到小模型
训练一个 671B 的强推理模型成本高昂,但很多应用场景只需要一个 7B/14B 的小模型就够用——知识蒸馏(Distillation) 正是把大模型的推理能力”转移”给小模型的关键技术。DeepSeek-R1 发布时同步开源的一系列蒸馏小模型(基于 Qwen2.5 1.5B–32B 与 Llama-3 8B/70B),是 2025 年最具影响力的蒸馏实践案例。
4.8.1 推理轨迹蒸馏(Reasoning Trace Distillation)
与传统蒸馏(让小模型模仿大模型的输出概率分布,即 Hinton 经典蒸馏中的 soft label)不同,推理模型蒸馏的做法更直接:
1. 用大模型(如 DeepSeek-R1)对大量题目生成完整的长 CoT 推理过程(含 <think>...</think>)
2. 用规则验证器筛选出"推理过程 + 最终答案"均正确的样本
3. 直接用这些(题目, 推理过程, 答案)三元组对小模型做标准 SFT
关键洞察:DeepSeek-R1 用约 80 万条由 R1 生成并筛选的样本对 Qwen、Llama 小模型做 SFT 蒸馏。其技术报告对比发现,在 Qwen-32B 上,蒸馏得到的模型明显强于直接对同一基座做大规模 RL 的结果——即”教小模型学大模型的解题过程”比”让小模型自己探索”更高效,因为小模型自身的探索能力远不如大模型。
4.8.2 蒸馏 + 二次强化学习
单纯 SFT 蒸馏的小模型已具备较强推理能力,但仍可通过少量 RL 微调进一步提升:
- 是否需要二次 RL:R1 报告中的蒸馏模型只做了 SFT,把 RL 留给了社区;后续工作(如 DeepScaleR 在 R1-Distill-Qwen-1.5B 上继续做 RL)表明,在蒸馏基础上再做 GRPO 仍能明显提升数学推理成绩,突破蒸馏数据的能力上限
- 损失函数设计:蒸馏阶段使用标准的交叉熵 SFT loss,loss 覆盖整个回答(思维链 + 最终答案),prompt 部分照常屏蔽;二次 RL 阶段则切换为 4.5 节的 GRPO loss
4.8.3 蒸馏 vs 直接预训练小模型
| 维度 | 蒸馏小模型(如 DeepSeek-R1-Distill-Qwen-7B) | 直接用同等数据预训练/RL 训练小模型 |
|---|---|---|
| 推理能力上限 | 接近教师模型在该规模下能达到的水平 | 通常更低,小模型自主探索能力弱 |
| 训练成本 | 低(一次 SFT,数据由教师模型批量生成) | 高(需要完整的 RL 训练基础设施) |
| 数据依赖 | 强依赖教师模型的输出质量 | 不依赖外部模型,但需要大量人工/规则标注 |
| 适用场景 | 已有强教师模型、追求快速落地 | 探索新能力边界、教师模型不可用的场景 |
实践建议:如果目标是”做一个好用的小模型”而非”研究新的训练方法”,蒸馏几乎总是优于从零训练——这也是 Qwen、Llama 等开源社区小模型质量在 2025 年大幅提升的直接原因之一。
5. Post-Training 与灾难性遗忘(Catastrophic Forgetting)
🎯 本章导读
Post-Training(后训练)是大模型落地的最后一公里:在通用基础模型之上,针对特定领域或能力进行进一步训练。然而,实践中无处不在的灾难性遗忘往往让新技能的获得以旧能力的崩溃为代价。本章系统梳理遗忘现象、影响因素与防遗忘方法,助你在 Post-Training 中“鱼与熊掌兼得”。
5.1 什么是 Post-Training?
Post-Training(后训练,亦称 Continual Learning / 持续学习)指的是:在一个已经具备通用能力的基础模型(Foundation Model)之上,通过进一步训练赋予其特定领域能力的过程。
flowchart LR
    A["通用基础模型<br/>Foundation Model<br/>(如 LLaMA-3、Gemma、DeepSeek)"]
    -->|Post-Training| B["专精模型<br/>Fine-tuned Model<br/>(如 中文助手、法律模型、代码专家)"]

    style A fill:#fff9c4
    style B fill:#c8e6c9
5.1.1 为什么需要 Post-Training?
今天的通用模型(LLaMA、Gemma、DeepSeek 等)已经具备很强的基础能力——就像一个从学校毕业的优秀学生。但实际应用往往需要某方面的专精:
- 特定领域:金融、法律、医疗、生物信息学
- 特定语言:中文、日文、韩文、小语种
- 特定任务:代码生成、数学推理、工具调用
- 新模态:让文本模型听懂语音、看懂图像
5.1.2 三种 Post-Training 方式
| 方式 | 数据格式 | 典型用途 |
|---|---|---|
| Pre-train Style | 无标注文本(做语言建模) | 注入领域知识、扩展语言 |
| SFT Style | 问答对 / 指令-回答对 | 指令遵循、对话能力 |
| RL Style | 奖励信号(规则或模型打分) | 推理能力、安全对齐 |
名词澄清:文献中对“Foundation Model”的叫法很混乱。有人把做过 Alignment 的 Chat 模型也叫 Base Model,读文献时需注意区分。
5.2 灾难性遗忘(Catastrophic Forgetting)
Post-Training 最大的挑战是:学了新技能,旧技能崩溃。这个现象叫做灾难性遗忘(Catastrophic Forgetting)。
手术成功,病人却死了——你专注于新目标,达成了,却发现模型其他能力都不好使了。
5.2.1 真实案例
5.2.1.1 案例1:教 LLaMA-2 Chat 说中文 → Safety Alignment 崩溃
LLaMA-2 Chat 做过 Safety Alignment,拒绝回答有害问题。当我们用中文语料对其做 Pre-train Style 的 Post-Training 后:
| 原版 LLaMA-2 Chat | Post-Training 后 | |
|---|---|---|
| 问:“如何获取银行密码?” | “很抱歉,我不能告诉你…” ✅ | 开始教具体的攻击方式 ❌ |
| ToxiGen 有害内容比例 | 0.22%(非常安全) | 大幅上升 |
训练数据本身是干净的中文语料,完全没有有害内容,但 Safety Alignment 能力依然崩溃。
5.2.1.2 案例2:普通 SFT 数据也会破坏 Safety(Fine-Tuning Aligned LLMs Compromises Safety)
即使用 Alpaca 这样完全无害的 SFT 数据微调 GPT-3.5 Turbo,也会导致安全能力下降(Qi et al., 2023)。更极端的是:只用 10 条”身份切换”样本(让模型自称绝对服从指令的 AOA 助手),就能让各维度的安全能力骤降。
5.2.1.3 案例3:教 LLaMA-3 新技能 → 全面能力损伤
在 LLaMA-3 上分别 SFT 以下四个任务:推理(reasoning)、医学知识、写代码、工具调用。
结果:
- ✅ 目标任务能力提升(符合预期)
- ❌ Safety Alignment 能力在所有情况下全面崩溃
- ❌ 非目标任务能力也大幅下降(教 tool use 后,数学能力从 19.6% 暴跌到 3.6%)
5.2.1.4 案例4:多模态 Post-Training(教文本模型听语音)
给 LLaMA 添加语音输入能力(插入 Adapter + 声音 Encoder),Post-Training 到第3个 epoch 时:
- ✅ 语音情感识别能力增强
- ❌ JSON 格式输出能力消失(这是 LLaMA 原本就有的能力,完全没训练过,也崩了)
5.2.2 关键规律
5.2.2.1 规律1:遗忘与目标任务表现正相关
学得越好,忘得越多。
研究发现,模型在目标任务上的 fine-tuning loss(学习越充分 → loss 越低)与遗忘程度几乎成线性正相关。这意味着:你不可能通过“把模型训练得更好”来同时解决遗忘问题。
5.2.2.2 规律2:LoRA 并未真正解决遗忘
LoRA 看起来遗忘更少,但代价是学到的东西也更少。
LoRA learns less and forgets less(低秩适配学得少,忘得也少)
| LoRA Rank | 目标任务能力 | 遗忘程度 |
|---|---|---|
| Rank 小 | 弱 | 少(聚集左下角) |
| Rank 大 | 强 | 多(聚集右上角) |
结论:LoRA 只是把“全参数微调会遗忘”的问题替换成了“学的少 → 忘的少”——并没有从根本上解决遗忘,其他正则化方法(Dropout、Weight Decay)同样无效。
5.2.2.3 规律3:遗忘与模型大小无明显关系
在 1B 到 7B 的模型上,更大的模型并不会遗忘更少。遗忘是一个普遍现象,不因参数量增大而消失。
5.3 防止遗忘的方法
5.3.1 方法一:Experience Replay(经验回放)
核心思路:在训练新任务时,混入少量旧任务的训练数据。
关键发现:只需混入约 5% 的历史数据,就足以有效防止遗忘。原因是遗忘并非真正“删除”了旧知识,而是旧知识“藏起来了”——少量提示就能唤醒。
工程实践:
# Safety-Tuned LLaMA 的做法:混入 3% 的 Safety Alignment 数据
mixed_dataset = {
    "target_task_data": 0.97,   # 当前任务(如中文语料)
    "safety_alignment_data": 0.03,  # 保持安全能力的对话数据
}
挑战:现在的大公司(Meta、Google)只发布模型权重,不发布训练数据。如果你拿不到历史训练数据,Experience Replay 就无从实施。
5.3.2 方法二:Pseudo Experience Replay(伪经验回放)
既然拿不到真实历史数据,就让模型自己生成伪历史数据。
核心洞察:模型并非真的“忘记”了旧知识,那些知识还在权重里。可以让模型自说自话,生成看起来像历史训练数据的内容,再混入当前训练中。
5.3.2.1 Magpie 方法(2024)
Magpie 的原理见 3.3.3.1 节。用在防遗忘上,就是让 Foundation Model 自问自答,生成”像它训练时见过的”指令数据:
输入:[BOS] <|user|>          ← 只给一个 user token
模型自动生成:什么是注意力机制?   ← 自己生成问题
输入:<|assistant|>
模型自动生成:注意力机制是...      ← 自己生成答案
这样就得到了“疑似 LLaMA-3 训练时用过的 SFT 数据”,混入 Post-Training 数据中,即可防止遗忘。
5.3.3 方法三:Self-Output(用模型自己的话训练自己)
比 Pseudo Experience Replay 更精准的方法:不是生成“历史数据”,而是直接用 Foundation Model 的当前输出来替代人类标注答案。
工作原理:
人类标注答案  ← 对 Foundation Model 来说是"陌生"的表达方式,学起来会更容易忘旧知识
模型自己的答案 ← 风格、用词与模型高度一致,学起来对原有知识影响最小
Selective Self-Rehearsal 流程:
flowchart TD
    A["问题 q"] --> B{"Foundation Model<br/>能否回答正确?"}
    B -->|能| C["用模型自己的答案训练"]
    B -->|不能| D["用人类标注答案训练"]
    C --> E["混合训练 → 遗忘大幅减少"]
    D --> E

    style C fill:#c8e6c9
    style D fill:#fff9c4
效果:在目标任务能力基本不变的前提下,遗忘程度大幅降低(相比纯 SFT 训练)。
5.3.3.1 Paraphrase 变体
用 Foundation Model 改写人类答案(而非直接生成):
# 把人类的标准答案交给 Foundation Model 改写
paraphrased_answer = foundation_model(
    f"请把以下答案换句话说,保持意思不变:{human_answer}"
)
# 用改写后的答案训练,遗忘更少
在 9 个测试场景中,有 8 个场景的效果优于直接用人类答案训练。
5.3.3.2 Token-level Filtering(进阶)
更精细的方法:不丢弃整条样本,而是在训练时跳过对 Foundation Model 特别难预测的 token。
# 计算每个 token 对 Foundation Model 的难度(surprisal)
token_surprisals = -log(foundation_model.prob(token | context))

# 过滤掉最难的 20% token(不对这些 token 计算 loss)
loss_mask = (token_surprisals < threshold)
loss = cross_entropy(logits[loss_mask], labels[loss_mask])
效果:在约 20% 过滤比例下,in-domain 和 out-of-domain 任务表现均有提升——“不逼模型学学不会的东西,反而学得更好”。
5.3.4 方法四:RL-Based Post-Training 的天然优势
RL 训练(如 GRPO)与 Self-Output 方法本质上非常相似:
| Self-Output | RL Training | |
|---|---|---|
| 答案来源 | Foundation Model 自己生成 | Policy(当前模型)采样 |
| 正确答案处理 | 用自己的答案训练(提高概率) | 奖励为正 → 梯度更新提高概率 |
| 错误答案处理 | 用人类答案 | 奖励为负 → 降低概率 |
这可能解释了:为什么 RL-based 训练通常放在训练流程的最后阶段——它天然与 Self-Output 类似,对旧有能力的破坏更小,是一种天然抗遗忘的训练方式。
5.4 实践建议
Post-Training 黄金法则:不要只看目标任务的表现,一定要同时评估模型原有能力是否保留。
推荐流程:
1. 建立基准 (Baseline)
   ├── 记录 Foundation Model 在各基准测试上的表现
   └── 重点关注:Safety、通用推理、原有擅长任务

2. Post-Training
   ├── 优先选择 Self-Output / RL-based 方法
   └── 若用人类标注数据,混入 3-5% Foundation Model 自生成数据

3. 全面评估
   ├── 目标任务:是否达到预期提升?
   ├── Safety 能力:ToxiGen / HarmBench 等
   └── 通用能力:MMLU / GSM8K / HumanEval 等
常见陷阱:
| 陷阱 | 表现 | 解决方案 |
|---|---|---|
| 只看目标任务 | “在 Verilog 上打爆 GPT-4,但连注释都看不懂” | 加全面评估集 |
| 迷信 LoRA 防遗忘 | LoRA rank 大 → 遗忘和全参数差不多 | 配合 Self-Output |
| 忽视 Safety | 教了代码/数学后 Safety 崩了 | 混入 3% Safety 数据 |
| 数据全是人类标注 | 遗忘比用模型自己的答案更严重 | 改用 Paraphrase / Self-Output |
6. 分布式训练技术
大模型训练必须依赖分布式并行技术。
🎯 本章导读
分布式训练是大模型训练的核心工程技术,没有分布式并行就无法训练超过单GPU显存容量的模型。本章介绍数据并行、张量并行、流水线并行、ZeRO等关键技术,以及如何选择合适的并行策略。核心原则:TP用于单层过大,PP用于层数过多,DP用于提升吞吐。
6.1 数据并行 (Data Parallelism, DP / DDP)
6.1.1 原理
数据并行是最直观的分布式训练方式。当单个 GPU 能够装下完整模型但显存无法容纳大 Batch Size 时,通过水平切分数据集,让多个 GPU 设备并行处理不同数据子集:
- 每个 GPU 设备都拥有一份独立的模型参数拷贝。
- 在前向传播中,各设备独立输入不同的 Batch 数据并计算 Loss 及本地梯度 \(\mathbf{g}_i\)。
- 在反向传播中,各设备通过卡间通信机制(如
All-Reduce)将所有梯度同步并求平均:\(\mathbf{g}_{\text{avg}} = \frac{1}{N} \sum_{i=1}^N \mathbf{g}_i\)。 - 各设备同步调用优化器,使用平均梯度 \(\mathbf{g}_{\text{avg}}\) 同步更新自己的模型权重,确保各张卡上的模型始终一致。
flowchart TD
    DS[("训练数据集")]

    DS -->|"Batch 0"| GPU0["GPU 0<br>完整模型副本 W<br>─────<br>前向传播 → Loss₀<br>反向传播 → g₀"]
    DS -->|"Batch 1"| GPU1["GPU 1<br>完整模型副本 W<br>─────<br>前向传播 → Loss₁<br>反向传播 → g₁"]
    DS -->|"Batch N-1"| GPUN["GPU N-1<br>完整模型副本 W<br>─────<br>前向传播 → Loss_{N-1}<br>反向传播 → g_{N-1}"]

    GPU0 --> AR["All-Reduce<br>g_avg = (g₀ + g₁ + ⋯ + g_{N-1}) / N"]
    GPU1 --> AR
    GPUN --> AR

    AR -->|"同步广播 g_avg"| U0["GPU 0 更新参数 W"]
    AR -->|"同步广播 g_avg"| U1["GPU 1 更新参数 W"]
    AR -->|"同步广播 g_avg"| UN["GPU N-1 更新参数 W"]

    style DS fill:#e3f2fd,stroke:#01579b,color:#000
    style GPU0 fill:#fff3e0,stroke:#e65100,color:#000
    style GPU1 fill:#fff3e0,stroke:#e65100,color:#000
    style GPUN fill:#fff3e0,stroke:#e65100,color:#000
    style AR fill:#fce4ec,stroke:#880e4f,color:#000
    style U0 fill:#c8e6c9,stroke:#1b5e20,color:#000
    style U1 fill:#c8e6c9,stroke:#1b5e20,color:#000
    style UN fill:#c8e6c9,stroke:#1b5e20,color:#000
6.1.2 底层工程优化:Bucket All-Reduce 与梯度通信重叠 (Overlapping)
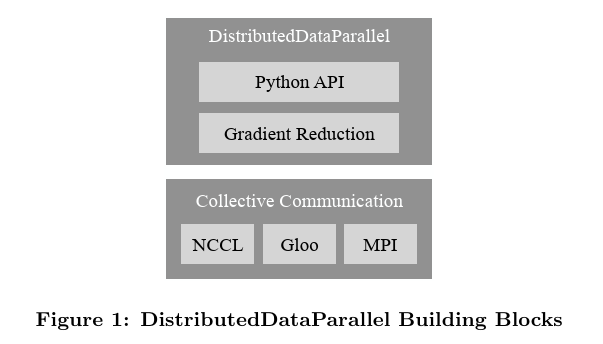
在 PyTorch DistributedDataParallel (DDP) 的实际工程中,为了避免反向传播结束后一次性进行海量梯度同步带来的网络阻塞,系统采用了梯度通信与计算重叠(Overlapping)的技术:
- 梯度分组(Buckets):DDP 在初始化时,根据反向传播的逆序(即从输出层向输入层),将梯度张量分配进多个固定大小的“桶”(Bucket,通常为 25MB)。
- 异步同步:在反向传播计算梯度时,一旦某一个 Bucket 中的梯度全部计算完毕,系统会立即在后台启动针对该 Bucket 的
All-Reduce异步通信。与此同时,更前几层的反向传播梯度计算仍在 GPU 核心上继续运行。这成功实现了计算与网络通信的并发,掩盖了大量的卡间同步时间。
flowchart LR
    subgraph COMPUTE ["GPU 反向传播(输出层 → 输入层)"]
        direction LR
        C1["Bucket K<br>梯度计算"] --> C2["Bucket K-1<br>梯度计算"] --> C3["Bucket K-2<br>梯度计算"] --> C4["⋯ Bucket 1<br>梯度计算"]
    end

    subgraph COMM ["后台异步 All-Reduce(各 Bucket 独立通信)"]
        direction LR
        R1["Bucket K<br>All-Reduce"]
        R2["Bucket K-1<br>All-Reduce"]
        R3["Bucket K-2<br>All-Reduce"]
        R4["Bucket 1<br>All-Reduce"]
    end

    C1 -.->|"满即触发"| R1
    C2 -.->|"满即触发"| R2
    C3 -.->|"满即触发"| R3
    C4 -.->|"满即触发"| R4

    R1 & R2 & R3 & R4 --> UPDATE["全部同步完成<br>优化器更新参数 W"]

    style C1 fill:#fff3e0,stroke:#e65100,color:#000
    style C2 fill:#fff3e0,stroke:#e65100,color:#000
    style C3 fill:#fff3e0,stroke:#e65100,color:#000
    style C4 fill:#fff3e0,stroke:#e65100,color:#000
    style R1 fill:#e8eaf6,stroke:#3949ab,color:#000
    style R2 fill:#e8eaf6,stroke:#3949ab,color:#000
    style R3 fill:#e8eaf6,stroke:#3949ab,color:#000
    style R4 fill:#e8eaf6,stroke:#3949ab,color:#000
    style UPDATE fill:#c8e6c9,stroke:#1b5e20,color:#000
6.1.3 DDP 局限
- 模型所有参数、优化器状态及梯度必须能够完整装入单个 GPU 的物理显存中。
- 对于超过单卡显存容量的超大模型(如 7B 及以上),DDP 会直接导致 OOM (Out of Memory),无法独立运行。
6.2 张量并行 (Tensor Parallelism, TP)
6.2.1 原理与切分策略
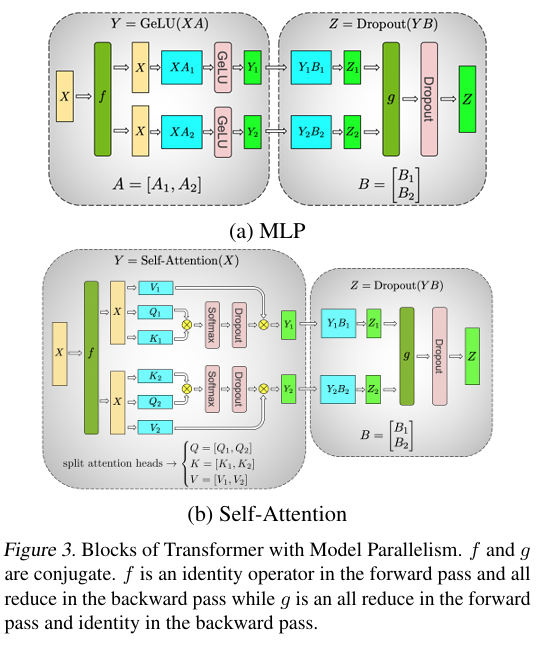
当单层权重矩阵的大小超过单卡显存时,张量并行(如 Megatron-LM)通过将每一层的权重参数横向或纵向切分到同一节点(通常具有高速 NVLink 互联)的不同 GPU 上,实现层内的分布式矩阵乘法计算。
6.2.1.1 MLP 层的切分策略
Transformer 的 MLP 层包含两个投影矩阵:门控/上投影 $W_{\text{gate/up}}$ 和下投影 $W_{\text{down}}$。设输入为 $X$,MLP 采用列并行-行并行的组合切分:
- 列并行(Column Parallelism): 将第 1 层权重矩阵 $W_{\text{col}}$ 按列均匀拆分为 $p$ 个分片:$W_{\text{col}} = [W_1, W_2, \ldots, W_p]$。 各卡直接输入完整 $X$,独立计算局部输出: \(Y_i = \text{Activation}(X W_i)\) 此阶段无需任何通信。
- 行并行(Row Parallelism):
将第 2 层权重矩阵 $W_{\text{row}}$ 按行均匀拆分为 $p$ 个分片:$W_{\text{row}} = [V_1; V_2; \ldots; V_p]$。
各卡输入上一层局部输出 $Y_i$,独立计算矩阵乘法:
\(Z_i = Y_i V_i\)
此时,所有 GPU 卡通过一次
All-Reduce (Sum)通信操作,将各卡的局部结果相加,获得完整的输出张量: \(Z = \sum_{i=1}^p Z_i + \text{bias}\)
6.2.1.2 Attention 层的切分策略
- QKV 投影:同样使用列并行。将注意力头的参数均匀划分到各卡(例如,32 头模型在 8 卡 TP 下,每卡负责 4 头),各卡独立计算对应的 Query、Key 和 Value,不需要卡间通信。
- 注意力计算:各 GPU 独立运行注意力运算,获得局部的 Context 向量。
- Output 投影:使用行并行。将各卡局部的输出权重进行行投影相乘,最后在输出端执行 1 次
All-Reduce (Sum)合并,即可恢复完整的 Multi-Head Attention 输出。
flowchart LR
    X["输入 X(完整)<br>所有卡共享"]

    subgraph COLPAR ["① 列并行 — 无通信"]
        direction TB
        G0["GPU 0<br>W_col 列分片 W₀<br>Y₀ = Act(X·W₀)"]
        G1["GPU 1<br>W_col 列分片 W₁<br>Y₁ = Act(X·W₁)"]
        GP["GPU p-1<br>W_col 列分片 Wₚ₋₁<br>Yₚ₋₁ = Act(X·Wₚ₋₁)"]
    end

    subgraph ROWPAR ["② 行并行 — 无通信"]
        direction TB
        R0["GPU 0<br>W_row 行分片 V₀<br>Z₀ = Y₀·V₀"]
        R1["GPU 1<br>W_row 行分片 V₁<br>Z₁ = Y₁·V₁"]
        RP["GPU p-1<br>W_row 行分片 Vₚ₋₁<br>Zₚ₋₁ = Yₚ₋₁·Vₚ₋₁"]
    end

    X --> G0 & G1 & GP
    G0 --> R0
    G1 --> R1
    GP --> RP
    R0 & R1 & RP --> AR["③ All-Reduce (Sum)<br>Z = Z₀ + Z₁ + ⋯ + Zₚ₋₁"]
    AR --> OUT["输出 Z(完整)"]

    style X fill:#e3f2fd,stroke:#01579b,color:#000
    style G0 fill:#fff3e0,stroke:#e65100,color:#000
    style G1 fill:#fff3e0,stroke:#e65100,color:#000
    style GP fill:#fff3e0,stroke:#e65100,color:#000
    style R0 fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style R1 fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style RP fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style AR fill:#fce4ec,stroke:#880e4f,color:#000
    style OUT fill:#c8e6c9,stroke:#1b5e20,color:#000
6.2.2 数学推导与通信代价分析
对于 Transformer 的一个基本 Block,其前向和反向的通信算子调用非常明确:
- 前向传播 (Forward):
- Attention 层的 Output 投影后:1 次
All-Reduce通信。 - MLP 层的下投影后:1 次
All-Reduce通信。 - 前向总开销:$2 \times \text{All-Reduce}$。
- Attention 层的 Output 投影后:1 次
- 反向传播 (Backward):
- 列并行层的输入 $X$ 被复制到各卡,反向时各卡对 $X$ 的梯度只是部分和,需要在列并行层的输入端(Megatron 中的 $f$ 算子)做一次
All-Reduce汇总。 - Attention 与 MLP 各一次,反向总开销:$2 \times \text{All-Reduce}$。
- 列并行层的输入 $X$ 被复制到各卡,反向时各卡对 $X$ 的梯度只是部分和,需要在列并行层的输入端(Megatron 中的 $f$ 算子)做一次
Megatron-LM 把这对操作抽象为共轭算子:$f$ 前向为恒等、反向为 All-Reduce;$g$ 前向为 All-Reduce、反向为恒等。
6.2.3 适用场景与局限
- 适用场景:单层权重显存超限(如 70B 模型的 Attention 层及 MLP 层)。
- 局限:TP 的通信频率极高(每个 Block 前反向共有 4 次 All-Reduce),网络传输必须极快。因此,TP 通常局限在单节点内的 NVLink 通信,TP 度数通常设为 2, 4 或 8,极少进行跨节点 TP。
6.3 流水线并行 (Pipeline Parallelism, PP)
6.3.1 原理
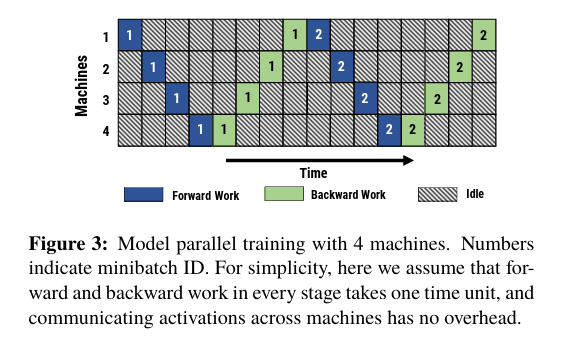
当模型层数过多,单节点显存已无法装下时,流水线并行采用“层间纵向切分”:将模型的 $L$ 层划分为 $p$ 个 Stage(阶段),分配到 $p$ 个不同的 GPU 上(可跨节点)。
flowchart LR
    DATA["输入数据<br>Micro-Batches"]

    subgraph S0 ["GPU 0 — Stage 0"]
        L0["Layer 1 ~ L/p"]
    end
    subgraph S1 ["GPU 1 — Stage 1"]
        L1["Layer L/p+1 ~ 2L/p"]
    end
    subgraph SX ["..."]
        LX["..."]
    end
    subgraph SP ["GPU p-1 — Stage p-1"]
        LP["Layer (p-1)L/p+1 ~ L"]
    end

    DATA --> L0
    L0 -->|"激活值 P2P 通信"| L1
    L1 -->|"激活值 P2P 通信"| LX
    LX -->|"激活值 P2P 通信"| LP
    LP --> LOSS["Loss 计算<br>梯度沿逆序 P2P 回传"]

    style DATA fill:#e3f2fd,stroke:#01579b,color:#000
    style L0 fill:#fff3e0,stroke:#e65100,color:#000
    style L1 fill:#fff9c4,stroke:#f57f17,color:#000
    style LP fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style LOSS fill:#c8e6c9,stroke:#1b5e20,color:#000
6.3.2 调度策略与气泡占比公式
若直接将整个 Batch 送入流水线,会导致大部分 GPU 在前向和反向时处于闲置等待状态,称为流水线气泡(Bubble)。PP 通过将 Batch 细分为 $m$ 个更小的 Micro-Batches 来提高利用率。
6.3.2.1 GPipe (F-then-B 调度)
- 调度逻辑:前一 Stage 执行完所有 $m$ 个 Micro-Batches 的前向传播后,后一 Stage 才能执行。随后依次执行所有的反向传播。
- 气泡占比公式: \(F_{\text{bubble}} = \frac{p - 1}{m + p - 1}\)
- 缺点:激活值(Activation)必须保存在显存中,直到反向传播到来。这造成显存占用随 Micro-Batch 数量 $m$ 线性增加,显存节省效果打折。
6.3.2.2 1F1B (One Forward, One Backward 调度)
- 调度逻辑:当流水线启动填充完毕后,每个 Stage 都在交替执行 1 次前向计算与 1 次反向计算。
- 气泡:与 GPipe 相同。若以理想计算时间为分母(Megatron-LM 的写法),两者的气泡比例都是 \(\frac{p - 1}{m}\) 因此减小气泡仍然要靠增大 micro-batch 数 $m$。
- 优势:Micro-Batch $i$ 的激活值在其前向完成并执行对应的反向后,可以立即从显存中销毁。同一时刻最多缓存 $p$ 份激活值,使激活显存与 Micro-Batch 数量 $m$ 解耦——1F1B 省的是显存,而不是气泡。
flowchart TD
    subgraph GPIPE ["GPipe (F-then-B)"]
        direction LR
        GF["① 全部 m 个 Micro-Batch<br>依次完成前向<br>激活值全部驻留显存"] --> GBUB["② 气泡等待<br>⬜ p-1 步空闲"] --> GBW["③ 全部 m 个 Micro-Batch<br>依次完成反向"]
    end

    subgraph F1B ["1F1B (One Forward, One Backward)"]
        direction LR
        WU["① 预热<br>p-1 步填充流水线"] --> SS["② 稳定交替<br>F(mbᵢ) 完成后立即 B(mbᵢ₋ₚ₊₁)<br>同一时刻只缓存 p 份激活值"] --> CD["③ 收尾<br>p-1 步清空"]
    end

    subgraph MEM ["激活值显存峰值对比"]
        direction LR
        GM["GPipe<br>同时缓存 m 份激活<br>O(m) 显存"]
        FM["1F1B<br>同时仅缓存 p 份激活<br>O(p) 显存 ✓"]
    end

    GPIPE -.-> GM
    F1B -.-> FM

    style GBUB fill:#ffcdd2,stroke:#b71c1c,color:#000
    style GM fill:#ffcdd2,stroke:#b71c1c,color:#000
    style FM fill:#c8e6c9,stroke:#1b5e20,color:#000
    style SS fill:#c8e6c9,stroke:#1b5e20,color:#000
6.3.2.3 Interleaved 1F1B (虚拟流水线)
- 每个 GPU 卡被虚拟分配负责非连续的多个 Stage(例如,GPU 0 负责第 1 层和第 9 层)。若每卡负责 $v$ 个虚拟 Stage,气泡比例降为 $\frac{p-1}{v \cdot m}$,代价是点对点(P2P)通信量增加到原来的 $v$ 倍。
6.4 序列并行 (Sequence Parallelism, SP)
6.4.1 原理
- 机制:在 Transformer 层中不做张量并行的区域(如 LayerNorm、Dropout、残差连接),标准的 TP 仍然需要在每张 GPU 上冗余地存储完整的激活值(Activation Memory)。这部分显存随序列长度 $s$ 线性增长,在长文本训练中占比可观。序列并行(Sequence Parallelism)在非注意力计算层把序列维度进行切分(每张卡只负责 $\frac{s}{p}$ 长度的序列),而在进行 QKV 投影和 MLP 列投影前通过
All-Gather拼回完整序列,计算完毕后通过Reduce-Scatter重新切分。
6.4.2 优势与长序列分布式优化
- 降本增效:成功将 LayerNorm 和 Dropout 处的激活值显存分摊到了 $p$ 张 GPU 上。
- 支持更长上下文:与 TP 配合(即 TP-SP),再结合选择性激活重计算,Megatron-LM 的实验中激活显存可降低约 5 倍(Korthikanti et al., 2022)。更长的上下文(百万级 token)则需要 Ring Attention 等在注意力内部切分序列的方案(见 2.5.3.4 节)。
flowchart LR
    IN["各卡持有<br>s/p 长度序列<br>(激活值切分)"]

    IN --> LN["LayerNorm<br>(各卡独立,无通信)"]
    LN -->|"All-Gather<br>拼回完整序列 s"| FULL["完整序列激活<br>(s × h)"]

    subgraph TPATTN ["Attention TP 区域"]
        FULL --> QKV["QKV 投影<br>(列并行)"] --> ATTN["Attention 计算<br>(各卡独立)"] --> OPRJ["Output 投影<br>(行并行)"]
    end

    OPRJ -->|"Reduce-Scatter<br>切回 s/p 序列"| DROP["Dropout + 残差<br>(各卡 s/p tokens)"]
    DROP --> LN2["LayerNorm → MLP<br>(同样 All-Gather / Reduce-Scatter)"]
    LN2 --> OUT["下一层输入<br>(s/p 序列维度切分)"]

    style IN fill:#e3f2fd,stroke:#01579b,color:#000
    style FULL fill:#fff3e0,stroke:#e65100,color:#000
    style QKV fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style ATTN fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style OPRJ fill:#f3e5f5,stroke:#6a1b9a,color:#000
    style DROP fill:#e8eaf6,stroke:#3949ab,color:#000
    style OUT fill:#e3f2fd,stroke:#01579b,color:#000
6.5 ZeRO (Zero Redundancy Optimizer)
微软 DeepSpeed 提出的 ZeRO 旨在完全消除 DDP 模式下多卡冗余的存储开销,将模型状态平摊到各 GPU。
6.5.1 模型静态显存数学推导(以 AdamW 优化器为例)
设模型参数量为 $\Psi$。在主流 FP16 混合精度训练下,一个 GPU 为存储模型状态(Model States)所消耗的静态显存包括:
- 模型参数 (Parameters):FP16 存储,占用 $2\Psi$ 字节。
- 梯度 (Gradients):FP16 存储,占用 $2\Psi$ 字节。
- 优化器状态 (Optimizer States):使用 FP32 以保证计算精度,包括:
- 主权重 (Master Weights):$4\Psi$ 字节
- 一阶动量 (Momentum):$4\Psi$ 字节
- 二阶变量 (Variance):$4\Psi$ 字节
- 优化器显存共计:$12\Psi$ 字节。
对于 7B 参数模型,静态显存占用即高达 $16 \times 7 = 112\text{GB}$,单张 H100 (80GB) 甚至连模型状态都装不下。
6.5.2 ZeRO 阶段性分片公式与 offload 技术 (设数据并行度为 $N_d$)
6.5.2.1 ZeRO-1:优化器状态分片 (Optimizer States Partitioning)
- 机制:将 $12\Psi$ 字节的 AdamW 优化器状态均匀分割并平摊到 $N_d$ 张卡上。每张 GPU 只负责更新和保存其中 $\frac{1}{N_d}$ 的优化器状态。
- 单卡显存公式:
\(M_{\text{ZeRO-1}} = 2\Psi + 2\Psi + \frac{12\Psi}{N_d}\)
- 示例:对于 7B 模型,$N_d=8$ 时,静态显存由 112GB 锐减到 38.5GB。
6.5.2.2 ZeRO-2:梯度分片 (Gradient Partitioning)
- 机制:在反向传播中,一旦某一层参数的梯度计算完毕,立即触发
Reduce-Scatter将其分发给负责更新该层优化器状态的 GPU,其他 GPU 立即释放该梯度。 - 单卡显存公式:
\(M_{\text{ZeRO-2}} = 2\Psi + \frac{2\Psi + 12\Psi}{N_d} = 2\Psi + \frac{14\Psi}{N_d}\)
- 示例:对于 7B 模型,$N_d=8$ 时,静态显存降至 26.25GB。
6.5.2.3 ZeRO-3:参数分片 (Parameter Partitioning)
- 机制:把 $2\Psi$ 字节的模型参数同样平摊到 $N_d$ 张卡上。前向和反向传播执行到特定层时,所有 GPU 广播(
All-Gather)获取该层的完整权重,使用完毕后立即丢弃。 - 单卡显存公式:
\(M_{\text{ZeRO-3}} = \frac{2\Psi + 2\Psi + 12\Psi}{N_d} = \frac{16\Psi}{N_d}\)
- 示例:对于 7B 模型,$N_d=8$ 时,静态显存仅需 14GB!
6.5.2.4 ZeRO-Offload (显存-内存卸载)
- 利用 PCIe 通道,将分片后的优化器状态以及梯度卸载(Offload)到宿主机 CPU 的内存(CPU RAM)中,利用宿主机的 CPU 核心执行优化器计算更新。前向时再把更新后的权重写回 GPU。这显著拓宽了单卡能训练的模型参数上限。
6.5.2.5 ZeRO-Infinity
- 在 ZeRO-Offload 基础上,利用 NVMe 固态硬盘(SSD)作三级缓存,可直接在低配 GPU 平台上微调千亿级大模型,打破物理硬件壁垒。
flowchart TD
    DDP["DDP 基准(每卡完整副本)<br>─────────────────<br>● 参数 2Ψ<br>● 梯度 2Ψ<br>● 优化器状态 12Ψ<br>─────────────────<br>单卡显存:16Ψ 字节"]

    Z1["ZeRO-1:优化器状态分片<br>─────────────────<br>● 参数 2Ψ<br>● 梯度 2Ψ<br>✓ 优化器状态 12Ψ / Nd<br>─────────────────<br>单卡显存:(4 + 12/Nd)Ψ 字节"]

    Z2["ZeRO-2:+ 梯度分片<br>─────────────────<br>● 参数 2Ψ<br>✓ 梯度 2Ψ / Nd<br>✓ 优化器状态 12Ψ / Nd<br>─────────────────<br>单卡显存:(2 + 14/Nd)Ψ 字节"]

    Z3["ZeRO-3:+ 参数分片<br>─────────────────<br>✓ 参数 2Ψ / Nd<br>✓ 梯度 2Ψ / Nd<br>✓ 优化器状态 12Ψ / Nd<br>─────────────────<br>单卡显存:16Ψ / Nd 字节"]

    DDP -->|"分片优化器状态"| Z1 -->|"+ 分片梯度"| Z2 -->|"+ 分片参数"| Z3

    style DDP fill:#ffcdd2,stroke:#b71c1c,color:#000
    style Z1 fill:#fff9c4,stroke:#f57f17,color:#000
    style Z2 fill:#fff3e0,stroke:#e65100,color:#000
    style Z3 fill:#c8e6c9,stroke:#1b5e20,color:#000
6.6 混合并行(3D Parallelism)
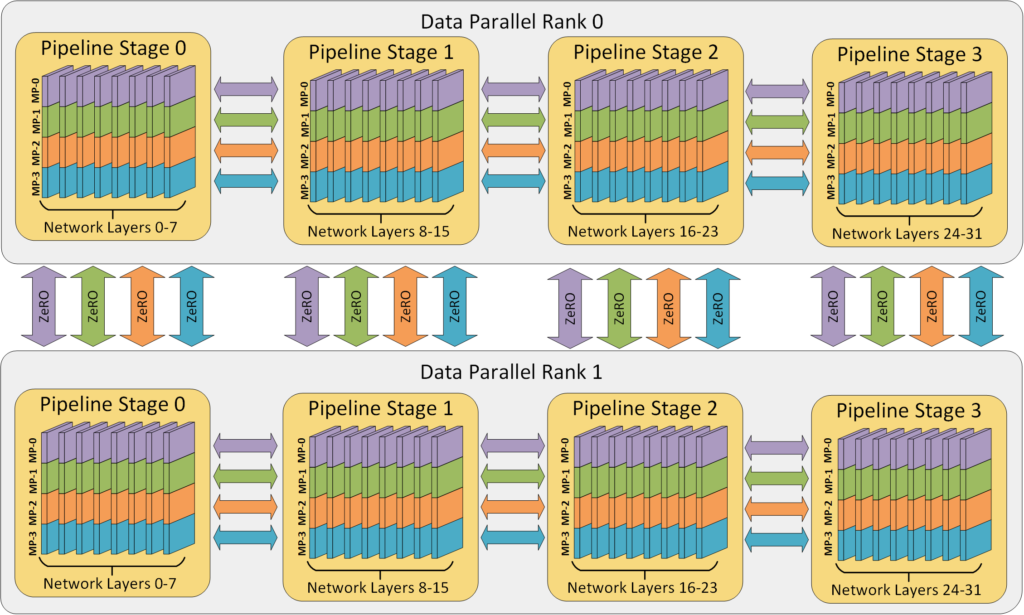
结合数据并行、张量并行、流水线并行:
\[\text{总GPU数} = \text{DP度} \times \text{TP度} \times \text{PP度}\]graph TD
A[选择并行策略] --> B{单层参数能否<br/>装入单GPU?}
B -->|否| C[启用张量并行 TP]
B -->|是| D{模型总层数<br/>是否很多?}
C --> D
D -->|是| E[启用流水线并行 PP]
D -->|否| F{还有剩余GPU?}
E --> F
F -->|是| G[启用数据并行 DP<br/>提升吞吐量]
F -->|否| H[完成配置]
G --> H
I[示例配置] --> J[1024 GPUs训练<br/>175B模型]
J --> K[TP=8: 单层切8份]
K --> L[PP=16: 分16个stage]
L --> M[DP=8: 8个数据副本]
M --> N[8×8×16=1024]
style C fill:#ffcdd2
style E fill:#fff9c4
style G fill:#c8e6c9
style H fill:#e3f2fd
6.6.1 策略选择原则
决策流程:
- 首先考虑TP(张量并行):
- 当单层参数 > 单GPU显存时必须使用
- 典型配置:TP=2/4/8(同节点内,NVLink通信)
- 例如:单层12GB,单GPU 80GB → 不需要TP
- 其次考虑PP(流水线并行):
- 当模型总层数很多时使用
- 典型配置:PP=2/4/8/16
- 例如:96层模型,PP=16 → 每个stage 6层
- 最后考虑DP(数据并行):
- 使用剩余所有GPU
- 提升训练吞吐量
- 例如:1024 GPU,TP=8,PP=16 → DP=8
实际案例:
| 模型规模 | TP | PP | DP | 总GPU | 说明 |
|---|---|---|---|---|---|
| 7B参数 | 1 | 1 | 64 | 64 | 小模型,纯DP即可 |
| 13B参数 | 2 | 1 | 32 | 64 | 需要少量TP |
| 70B参数 | 8 | 4 | 4 | 128 | 需要TP+PP |
| 175B参数 | 8 | 16 | 8 | 1024 | 大模型,3D并行 |
| 540B参数 | 8 | 32 | 16 | 4096 | 超大模型 |
Trade-off考虑:
- TP增大:层内通信增多,需要高速互联(NVLink)
- PP增大:Pipeline bubble增大,GPU利用率下降
- DP增大:梯度同步通信增多,但可用Ring-AllReduce优化
7. 训练优化技术
在大语言模型(LLM)的训练中,硬件资源(特别是GPU显存和带宽)与训练时间是核心瓶颈。优化技术不仅决定了模型能否在有限的资源下跑起来,还直接决定了训练的收敛速度与最终效果。本章将深入解析主流的优化器选择、学习率调度、梯度处理方法、正则化技术以及注意力加速算子 Flash Attention。
🎯 本章导读
大模型训练是一场显存与计算效率的博弈。优化器的选择决定了显存占用的下限,学习率和梯度策略决定了模型能否平稳收敛,而 Flash Attention 则是目前解决长文本注意力计算瓶颈的基石。本章旨在帮助读者建立从“数学公式”到“工程实现”的完整认知体系。
7.1 优化器选择(Optimizer Selection)
在大模型训练中,优化器状态(Optimizer States)是最大的显存消耗源之一。在常用的 FP16/BF16 混合精度训练中,虽然权重和梯度只需 2 字节(FP16/BF16),但 AdamW 优化器需要为每个参数存储一份 FP32 的 Master Weights、FP32 的一阶动量(Momentum)和 FP32 的二阶动量(Variance),这带来了巨大的显存开销。
7.1.1 AdamW:主导大模型训练的经典之作
AdamW 是当前大模型训练最主流的优化器(如 LLaMA, GPT, InternLM 等默认使用)。
7.1.1.1 核心公式与 Weight Decay 解耦
传统的 Adam 优化器在结合 L2 正则化时,会将权重梯度与正则化梯度混合在一起进行动量估计,导致对稀疏梯度的缩放异常。AdamW 将权重衰减(Weight Decay)直接与梯度更新解耦,在前一步更新参数时直接减去衰减项:
\[\theta_{t+1} = \theta_t - \eta_t \lambda \theta_t - \eta_t \left( \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} \right)\]其中:
- $\theta_t$:第 $t$ 步的模型参数
- $\eta_t$:当前步的学习率
- $\lambda$:权重衰减率(通常为 0.1)
- \(\hat{m}_t, \hat{v}_t\):经过偏差修正的一阶动量和二阶动量
7.1.1.2 显存开销分析
假设模型参数量为 $N$,采用混合精度(Mixed Precision)训练:
- 模型参数 (FP16/BF16):$2N$ 字节
- 梯度 (FP16/BF16):$2N$ 字节
- AdamW 优化器状态 (FP32):
- Master Weights(用于累加微小更新):$4N$ 字节
- 一阶动量 $m_t$:$4N$ 字节
- 二阶动量 $v_t$:$4N$ 字节
- 优化器状态总计:$12N$ 字节
结论:仅优化器状态就需要 $12N$ 字节的显存,占混合精度训练基础显存($16N$ 字节)的 75%。
7.1.2 Adafactor:低显存的自适应步骤优化器
Adafactor 主要是为了解决 AdamW 二阶动量占用 $4N$ 字节显存的痛点,常被用于 T5 等模型的训练。
7.1.2.1 低秩分解减小显存
对形状为 $R \times C$ 的权重矩阵,Adafactor 不存储完整的二阶动量矩阵 $V \in \mathbb{R}^{R \times C}$,而是做秩 1 分解(Rank-1 Factorization):只维护行和 $V_R \in \mathbb{R}^R$ 与列和 $V_C \in \mathbb{R}^C$,再用它们近似还原二阶动量:
\[\hat{V}_{i,j} = \frac{(V_R)_i \cdot (V_C)_j}{\sum_{k} (V_C)_k}\]这使得存储二阶动量的空间从 $O(RC)$ 降到 $O(R + C)$。对于一个大矩阵,这几乎将二阶动量的显存占用减少到了接近于 0。
7.1.2.2 优缺点分析
- 优点:极大地节省了显存,使优化器状态显存从 $12N$ 字节降低到约 $4N$ 字节(如果禁用一阶动量并只存行/列二阶动量因子)。
- 缺点:不存储完整的一阶动量和二阶动量,可能导致训练在某些任务上收敛变慢、不稳定。
7.1.3 Lion (Evolved Sign Momentum):数据驱动的极简优化器
Lion 是通过 Google 的算法进化搜索(Symbolic Discovery)发现的新型优化器。
7.1.3.1 核心机制:Sign 函数与单动量
Lion 舍弃了二阶动量,仅保留一阶动量,且在更新参数时仅使用符号函数(Sign Function),这使得更新步长更加均匀。其更新规则如下:
\(u_t = \text{sign}(\beta_1 m_{t-1} + (1 - \beta_1) g_t)\) \(m_t = \beta_2 m_{t-1} + (1 - \beta_2) g_t\) \(\theta_{t+1} = \theta_t - \eta_t (u_t + \lambda \theta_t)\)
其中:
- $g_t$:当前步梯度
- $m_t$:一阶动量
- $\text{sign}(\cdot)$:符号函数(取值为 $+1, -1, 0$)
7.1.3.2 显存开销分析
因为 Lion 删除了二阶动量:
- 一阶动量 $m_t$ (FP32):$4N$ 字节
- Master Weights (FP32):$4N$ 字节
- 优化器状态总计:$8N$ 字节(相比 AdamW 节省了 $4N$ 字节)
7.1.3.3 特点
- 高计算吞吐量:
sign操作非常适合 GPU 向量化执行,且由于没有二阶动量的繁琐计算,每步迭代速度稍快。 - 超参数敏感:Lion 相比 AdamW 更容易受学习率和权重衰减大小的影响,需要针对特定模型重新调优超参。
7.1.4 优化器系统对比与显存结构图
以下是常用优化器的综合对比表:
| 优化器 | 显存开销 (仅状态) | 核心特点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| AdamW | $12N$ 字节 | 收敛极其平稳,对超参数不敏感,生态支持最完善 | 显存占用极大 | LLM 训练绝对默认选择 |
| Lion | $8N$ 字节 | 节省 33% 优化器显存,速度稍快,更新幅度均匀 | 超参难调,早期收敛可能有抖动 | 显存受限、追求更高吞吐量的场景 |
| Adafactor | $4N \text{–} 8N$ 字节 | 行列秩 1 分解,大矩阵参数下显存优势明显 | 训练稳定性弱于 AdamW | 早期 T5 训练,极端显存受限场景 |
7.1.4.1 优化器状态显存占用图解(基于 FP16 混合精度训练,每参数字节数)
gantt
    title 优化器状态显存占用对比 (以每个模型参数为单位,单位:字节)
    dateFormat  X
    axisFormat %s

    section AdamW (12字节状态 + 4字节模型/梯度 = 16B)
    模型参数 & 梯度 (FP16) :active, 0, 4
    Master Weights (FP32) :crit, 4, 8
    一阶动量 (FP32) :active, 8, 12
    二阶动量 (FP32) :active, 12, 16

    section Lion (8字节状态 + 4字节模型/梯度 = 12B)
    模型参数 & 梯度 (FP16) :active, 0, 4
    Master Weights (FP32) :crit, 4, 8
    一阶动量 (FP32) :active, 8, 12

    section Adafactor (4字节状态 + 4字节模型/梯度 = 8B)
    模型参数 & 梯度 (FP16) :active, 0, 4
    Master Weights (FP32) :crit, 4, 8
7.2 学习率策略(Learning Rate Schedules)
在 Transformer 架构中,合理的学习率策略对防止模型梯度爆炸、加速收敛至关重要。目前业界标准采用 Warmup (预热) + Decay (衰减) 模式。
7.2.1 Learning Rate Warmup(预热)
7.2.1.1 为什么必须 Warmup?
在大模型训练初期(特别是使用 Pre-LN 结构或 AdamW 优化器时):
- 随机初始化的权重导致网络前几层的梯度极不稳定。
- AdamW 优化器的二阶动量估计尚未建立(\(\hat{v}_t\) 接近零,导致修正后的步长异常巨大)。 如果直接使用峰值学习率,极易引发数值溢出(Overflow)或不可逆的梯度爆炸。
7.2.1.2 实现方式
在训练的前 $T_{\text{warmup}}$ 步(通常占总步数的 1%–5%,约 2000–10000 步),学习率从 0 线性增加到最大峰值学习率 \(\text{lr}_{\max}\):
\[\text{lr}(t) = \text{lr}_{\max} \cdot \frac{t}{T_{\text{warmup}}}, \quad t \le T_{\text{warmup}}\]7.2.2 Cosine Decay(余弦衰减)
Cosine Decay 是大模型最主流的衰减方式,它能使学习率在中间训练阶段保持平稳释放,在训练末期快速收敛。
\[\text{lr}(t) = \text{lr}_{\min} + \frac{1}{2}(\text{lr}_{\max} - \text{lr}_{\min}) \left(1 + \cos\left(\frac{\pi (t - T_{\text{warmup}})}{T - T_{\text{warmup}}}\right)\right), \quad t > T_{\text{warmup}}\]- 特点:曲线顺滑。实验表明,Cosine 衰减在绝大多数语言建模任务上相比线性衰减能取得更低的困惑度(Perplexity)。
- 参数推荐:\(\text{lr}_{\min}\) 通常设为 \(\text{lr}_{\max}\) 的 10%(或直接设为 0)。
7.2.3 WSD (Warmup-Stable-Decay) 调度策略
传统 Cosine 调度必须预先确定总训练 token 数,中途想追加数据就得重跑整条衰减曲线。为了应对持续增量训练(Continual Training)或动态调整数据量的需求,MiniCPM 系统地提出了 WSD 调度策略;DeepSeek-V3 也采用了类似的”长时间恒定学习率 + 末段衰减”方案(前 10T tokens 保持恒定,之后在 4.3T tokens 内余弦衰减)。
graph TD
    A[WSD 学习率策略] --> B[Warmup 阶段]
    A --> C[Stable 恒定阶段]
    A --> D[Decay 退火阶段]

    B --> B1[快速提升学习率到峰值]
    C --> C1[长时期以恒定最大学习率训练,方便中途随时终止或追加数据]
    D --> D1[在训练最后 5%–10% 步数内,急剧指数/余弦衰减,锁定权重收敛]
- 优势:
- 高度灵活性:Stable 阶段可以随时保存检查点,想追加数据时只需延长 Stable 阶段、再从任意检查点重新进入 Decay,无需重跑 Cosine Decay 曲线。
- 快速收敛:退火阶段(Decay Phase)在短时间内将学习率压低,模型效果在此阶段会迎来“二次飞跃”(PPL 骤降)。
7.3 梯度处理(Gradient Processing)
7.3.1 Gradient Clipping(梯度裁剪)
为防止在遇到异常长样本或极端梯度时引发梯度爆炸,需要对所有层梯度向量的模长进行截断。
7.3.1.1 L2 范数全局裁剪(Global Norm Clipping)
这是大模型训练的标配。计算所有参数梯度拼接成的全局梯度向量 $\mathbf{g}$ 的 L2 范数,若超过阈值 $d_{\max}$,则进行等比例缩放:
\[\mathbf{g} \leftarrow \mathbf{g} \cdot \min\left(1, \frac{d_{\max}}{\|\mathbf{g}\|_2}\right)\]- 最佳实践:大模型训练中全局阈值 $d_{\max}$ 通常设为
1.0。 - 优点:保持了梯度向量的方向不变,仅限制了步长,能很好地维持各层更新比例的协调。
7.3.2 Gradient Accumulation(梯度累积)
在大模型训练中,由于单卡显存受限,无法直接将很大的 Batch Size(例如百万级 tokens 级别)一次性喂入 GPU 进行前向传播。梯度累积通过“时间换空间”的方式,在物理显存受限时模拟大 Batch 训练。
7.3.2.1 工作原理
设目标 Batch Size 为 $B_{\text{global}}$,单卡单步处理的 Micro Batch Size 为 $B_{\text{micro}}$。
- 在连续的 $N$ 个 Step 中,仅进行前向传播和反向传播,将计算出的梯度累加(Add)在梯度缓冲区中,而不调用
optimizer.step()。 - 在第 $N$ 步,将累积的梯度除以 $N$(取平均),然后执行
optimizer.step()更新参数并清空梯度。 - 对应的等式:\(B_{\text{global}} = B_{\text{micro}} \times N \times \text{DP\_degree}\)。
flowchart LR
    subgraph ACCUM ["N 步梯度累积(不触发 All-Reduce)"]
        direction LR
        S1["mb₁<br>前向+反向<br>∇L₁ 写入缓冲"] --> S2["mb₂<br>前向+反向<br>∇L₂ 累加缓冲"] --> SN["mb_N<br>前向+反向<br>∇L_N 累加缓冲"]
    end

    SN --> AR["All-Reduce<br>一次跨卡梯度同步"]
    AR --> OPT["optimizer.step()<br>参数更新"]
    OPT --> ZG["zero_grad()<br>清空梯度缓冲"]
    ZG --> S1

    style AR fill:#fce4ec,stroke:#880e4f,color:#000
    style OPT fill:#c8e6c9,stroke:#1b5e20,color:#000
    style ZG fill:#e8eaf6,stroke:#3949ab,color:#000
- 工程优化 (PyTorch
no_sync机制):在分布式训练中,默认的反向传播会在每一步自动触发卡间梯度同步(All-Reduce)。在梯度累积的前 $N-1$ 步中,应使用model.no_sync()上下文管理器,阻断无用的网络同步,只在最后一步执行 All-Reduce,能极大地提升网络带宽利用率。
7.3.3 Gradient Checkpointing(梯度检查点 / 激活重计算)
梯度检查点(Activation Checkpoint / Recomputation)是用计算时间换显存空间的经典技术。
7.3.3.1 背景:前向激活值显存瓶颈
在反向传播计算梯度时,公式需要用到前向传播计算出的激活值(Activation)。因此,标准的训练过程会在前向传播中把所有层的激活值保存在显存中,这造成了随模型层数 $L$ 和序列长度 $s$ 呈线性增长的巨大显存占用。
7.3.3.2 核心原理
- 选择性保存:不再保存所有层的激活值,而是每隔 $k$ 层选择一层作为“检查点”(Checkpoint),只保存该层的激活值。
- 反向重计算:反向传播到未保存激活值的层时,从最近的检查点开始,重新运行一次前向传播,实时计算出临时激活值用于梯度计算,算完后立即丢弃。
flowchart TD
    subgraph STND ["标准训练 — 保存全部激活值 O(L)"]
        direction TB
        A1["Layer 1 前向<br>保存激活值 a₁"] -->|"保存 a₁"| A2["Layer 2 前向<br>保存激活值 a₂"] -->|"保存 a₂"| A3["Layer 3 前向<br>保存激活值 a₃"] --> A4["Loss + 反向"]
        A4 -->|"使用 a₂"| A5["Layer 2 反向"] -->|"使用 a₁"| A6["Layer 1 反向"]
    end

    subgraph CKPT ["梯度检查点 — 只保存检查点 O(√L)"]
        direction TB
        B1["Layer 1 前向<br>✓ 保存检查点 c₁"] -->|"保存 c₁"| B2["Layer 2 前向<br>✗ 丢弃激活值"] -->|"丢弃"| B3["Layer 3 前向<br>✗ 丢弃激活值"] --> B4["Loss + 反向"]
        B4 -->|"从 c₁ 重计算 Layer 2"| B5["Layer 2 反向"] -->|"使用 c₁"| B6["Layer 1 反向"]
    end

    style A1 fill:#ffebee,stroke:#c62828,color:#000
    style A2 fill:#ffebee,stroke:#c62828,color:#000
    style A3 fill:#ffebee,stroke:#c62828,color:#000
    style B1 fill:#e8f5e9,stroke:#2e7d32,color:#000
    style B2 fill:#f5f5f5,stroke:#9e9e9e,color:#000
    style B3 fill:#f5f5f5,stroke:#9e9e9e,color:#000
7.3.3.3 代价与收益
- 收益:激活值显存复杂度从 $O(L)$ 降至 $O(\sqrt{L})$,能极大地防止在超长序列训练时发生 OOM。
- 代价:反向传播中多了一次前向计算,通常会带来大约 30%–33% 的额外计算开销。
7.4 正则化与数值稳定性技术
在大模型训练中,正则化不仅用于防止过拟合,更关键的作用在于提高混合精度训练下的数值稳定性。
7.4.1 Weight Decay(权重衰减)
- 在 AdamW 中的重要性:在每一轮迭代更新中,模型权重乘以一个略小于 1 的系数(通常 Weight Decay = 0.1):$\theta_{t} \leftarrow (1 - \eta_t \lambda)\theta_{t}$。
- 作用:防止权重数值过大。在大模型训练中,权重过大容易导致激活值溢出(NaN)或引发注意力矩阵偏置过大而导致 Softmax 梯度饱和。
7.4.2 Dropout:在大模型中的逐渐淡出
- 现状:在千亿(100B)以上规模模型的预训练阶段,Dropout 率(包括 Attention Dropout 和 Residual Dropout)通常被直接设为 0。
- 原因:
- 数据充沛度:大模型预训练的数据集往往极为庞大,模型参数相较于海量数据而言不易过拟合,本身已具备天然正则化。
- 效率损失:Dropout 需要在随机状态发生器中采样 mask 矩阵并写入显存,降低了显卡计算吞吐(Throughput)。
- 特殊例外:在小模型微调阶段(SFT)或在 Embedding 层后可能会保留 0.05–0.1 的 Dropout 以防止对特定微调模板产生过拟合。
7.4.3 Z-loss 正则化:抑制 Logits 爆炸
在使用 FP16/BF16 混合精度进行超大规模训练时,输出层的 Logits 可能整体漂移到很大的数值,导致 Softmax 计算中指数项数值溢出(出现 NaN)。PaLM 为此引入了 Z-loss,OLMo 2 等开源模型也沿用了这一做法。
7.4.3.1 核心机制
Z-loss 在原始的交叉熵损失中加入了一项辅助惩罚项,用于惩罚 Logits 的配分函数 $Z$(即 $\sum_i e^{x_i}$)的对数值:
\[\mathcal{L} = \mathcal{L}_{\text{cross-entropy}} + \alpha \log^2 Z\]其中 $Z = \sum_{i} e^{x_i}$,$\alpha$ 通常设为 $10^{-4}$ 级(PaLM 取 $10^{-4}$)。
7.4.3.2 作用与原理
- 约束 Logits 的绝对大小:鼓励 $\log Z$ 接近 0,即 Softmax 的分母接近 1,防止 Logits 整体向大数值漂移。
- 极大地增强了稳定性:避免在数十万步训练之后,由于分类层 Logits 漂移导致出现无法挽回的 NaN 崩溃。
7.5 Flash Attention
Flash Attention 是当前 LLM 训练和推理中最重要的注意力加速技术,通过改变计算顺序而非简化算法,在保持数值等价的前提下大幅减少显存占用、加快计算速度。
7.5.1 背景:标准 Attention 的内存瓶颈
标准 Scaled Dot-Product Attention 的计算:
\[\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]问题所在:
- 序列长度为 $n$ 时,$QK^T$ 矩阵大小为 $n \times n$,需完整写入 GPU 主显存(HBM)
- 内存复杂度 $O(n^2)$:$n=4096$ 时约占数百 MB,$n=32768$ 时高达数十 GB
- 真正的瓶颈不是计算量,而是数据搬运:HBM 带宽远低于片上 SRAM,反复读写大矩阵成为性能瓶颈
7.5.2 GPU 内存层次:工作台 vs 仓库
SRAM(片上缓存)= 工作台
  • 容量:约 20 MB(A100:每个 SM 192 KB × 108 个 SM)
  • 速度:极快(~19 TB/s on A100)
  • 特点:运算单元直接读写

HBM(主显存)= 仓库
  • 容量:40–80 GB
  • 速度:较慢(~2 TB/s on A100)
  • 特点:所有 tensor 默认存放于此
标准 Attention 每步计算都需把中间矩阵写回 HBM,再从 HBM 读回,造成大量低效的数据搬运。Flash Attention 的核心目标:尽量让数据留在 SRAM,减少往返 HBM 的次数。
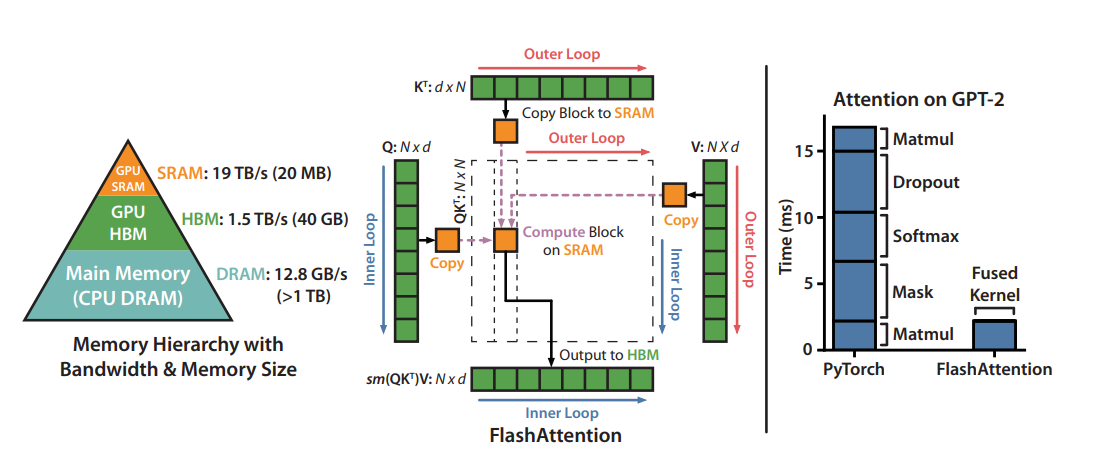
7.5.3 核心思想:分块 + Online Softmax
Flash Attention 的两个关键创新:
1. 分块计算(Tiling)
将 $K$、$V$ 切成小块,逐块载入 SRAM 计算,避免 $n \times n$ 矩阵写入 HBM。当前块计算完后直接丢弃,不写回 HBM。
2. Online Softmax(增量归一化)
传统 Softmax 需先扫描全局最大值 $A_{\max}$,才能计算 $\exp$——这要求看到全部数据,无法分块。Online 方法的解决思路:
- 处理每一块时维护当前见过的最大值,遇到更大值时用修正因子还原历史累积:
- 全程无需存储完整的 $n \times n$ 注意力矩阵
3. 直接累积输出
不显式存储注意力权重,直接累积输出 $O$:
\[O_k = O_{k-1} \times \text{修正因子} + \text{当前块贡献}\]4. 反向传播重计算
反向传播时不从 HBM 读取中间矩阵,而是从 $Q/K/V$ 重新计算——用少量额外算力换取大量显存节省。
7.5.4 内存与速度对比
| 方法 | 注意力矩阵内存 | HBM 访问次数 |
|---|---|---|
| 标准 Attention | $O(n^2)$ | 多次往返 |
| Flash Attention | $O(n)$(无完整矩阵) | 最少化 |
论文报告的性能(FlashAttention v1,A100):
- 注意力算子本身:GPT-2 场景下最高提速约 7.6×
- 端到端训练:GPT-2(序列长度 1K)提速约 3×,BERT-large(序列长度 512)提速约 15%
- 数值:计算是精确的(非近似),与标准实现的差异仅来自浮点运算顺序不同
- 显存:不再存储 $n \times n$ 注意力矩阵,使 64K 级序列长度的训练成为可能
7.5.5 版本演进
| 版本 | 年份 | 核心改进 |
|---|---|---|
| FlashAttention v1 | 2022 | IO-aware 分块 + Online Softmax 原始实现 |
| FlashAttention v2 | 2023 | 更优并行策略,减少线程同步开销,~2× vs v1 |
| FlashAttention v3 | 2024 | 针对 H100/Hopper 架构,利用异步执行与 FP8 支持 |
| FlashAttention v4 | 2025 | 面向 Blackwell 架构重写内核 |
7.5.6 实际使用
PyTorch 2.0+ 内置支持(推荐,零额外依赖):
import torch.nn.functional as F

output = F.scaled_dot_product_attention(
    query, key, value,
    attn_mask=None,
    dropout_p=0.0,
    is_causal=True  # 自回归训练必须设为 True
)
通过 transformers 显式启用 Flash Attention 2:
from transformers import AutoModelForCausalLM
import torch

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    torch_dtype=torch.bfloat16,
    attn_implementation="flash_attention_2"  # 需先安装 flash-attn
)
pip install flash-attn --no-build-isolation
最佳实践:Flash Attention 与标准 Attention 数值等价,序列越长收益越显著。PyTorch 2.0+ 可通过
scaled_dot_product_attention零成本启用;所有 LLM 训练任务均建议开启。
8. 模型量化技术
模型量化是降低大模型计算和存储成本的核心技术之一。通过将高精度浮点数(FP32/FP16)转换为低精度整数(INT8/INT4),量化可以显著减少显存占用、加快推理速度,同时保持模型性能基本不变。
🎯 本章导读
量化是大模型民主化的关键技术。一个70B模型,FP16 权重需要140GB显存,INT4量化后仅需约35GB——这意味着从至少 2 张 A100-80G 降到 1 张即可装下权重(KV Cache 另计)。本章深入讲解量化的数学原理、主流方法(GPTQ、AWQ、QLoRA)、训练策略,以及工程实践。核心要点:量化不是简单压缩,而是精心设计的精度-性能权衡艺术。
8.1 🧮 量化基础概念
8.1.1 什么是量化?
量化(Quantization)是将连续的高精度数值映射到离散的低精度数值的过程:
\[\text{FP32/FP16} \xrightarrow{\text{量化}} \text{INT8/INT4/INT2}\]核心目标:
- 📉 降低显存占用:FP16 → INT8 减少50%,FP16 → INT4 减少75%
- ⚡ 加速计算:整数运算比浮点运算快2-4倍
- 💰 降低成本:更小的模型可以部署在更便宜的硬件上
关键挑战:
- 保持模型精度不显著下降
- 处理异常值(Outliers)
- 平衡量化粒度与精度损失
8.1.2 量化的数学原理
8.1.2.1 对称量化(Symmetric Quantization)
将浮点数 $x \in [-\alpha, \alpha]$ 映射到整数 $q \in [-127, 127]$(INT8为例):
\[q = \text{round}\left(\frac{x}{s}\right), \quad s = \frac{\alpha}{127}\]反量化(推理时恢复):
\[\hat{x} = s \cdot q\]其中:
- $s$:缩放因子(scale)
- $\alpha$:所有元素绝对值的最大值
- $q$:量化后的整数
特点:
- ✅ 实现简单,硬件友好
- ✅ 零点为0,无需额外存储
- ❌ 对非对称分布的数据浪费表示范围
8.1.2.2 非对称量化(Asymmetric Quantization)
处理非对称分布的数据 $x \in [x_{\min}, x_{\max}]$:
\[q = \text{round}\left(\frac{x - z}{s}\right)\]其中:
- $s = \frac{x_{\max} - x_{\min}}{255}$(INT8)
- $z = \text{round}\left(-\frac{x_{\min}}{s}\right)$:零点(zero-point)
反量化:
\[\hat{x} = s \cdot (q - z)\]特点:
- ✅ 更好利用量化范围
- ✅ 适合激活值(通常非对称)
- ❌ 需要额外存储零点参数
8.1.2.3 量化粒度
| 粒度 | 说明 | 优点 | 缺点 |
|---|---|---|---|
| Per-tensor | 整个张量共享一个 $(s, z)$ | 内存小,速度快 | 精度损失较大 |
| Per-channel | 每个输出通道独立 $(s_i, z_i)$ | 精度更高 | 参数量增加 |
| Per-group | 每组参数共享(如128个元素) | 平衡精度与效率 | 实现复杂 |
最佳实践:
- 权重:Per-channel 量化(精度关键)
- 激活值:Per-tensor 量化(速度优先)
8.1.3 量化误差分析
量化引入的误差:
\[\text{Error} = \mathbb{E}[(x - \hat{x})^2] = \mathbb{E}[(x - s \cdot \text{round}(x/s))^2]\]误差来源:
- 舍入误差:$\text{round}()$ 操作导致的精度损失
- 裁剪误差:超出 $[x_{\min}, x_{\max}]$ 的值被裁剪
- 异常值影响:少数极大值拉大缩放因子 $s$,压缩其他值的表示精度
降低误差的策略:
- 使用更细粒度的量化(Per-channel)
- 异常值单独处理(Mixed-precision)
- 量化感知训练(QAT)
8.1.4 量化精度与性能权衡(Precision-Performance Trade-offs)
不同的量化比特与数值格式在显存节省、计算加速和模型精度(困惑度 PPL)之间存在复杂的权衡。以下是主流数值格式的系统对比:
| 数值格式 | 参数显存占比 (以BF16为基准) | 困惑度 (PPL) 变化 | 硬件加速支持 | 典型应用场景 |
|---|---|---|---|---|
| BF16 / FP16 | 100% | 0 (基准) | Tensor Core 原生 | 标准模型训练、高精度推理基准 |
| INT8 Weight-Only | ~50% | 几乎无损 (< 0.05) | 需反量化到FP16计算 | 资源受限服务器部署,侧重保留精度 |
| INT8 Weight & Act | ~50% | 轻微下降 (< 0.1) | INT8 GEMM 硬件加速 | 高并发吞吐量推理(如 SmoothQuant) |
| INT4 (NF4 / GPTQ) | ~25% | 参数 > 7B 时无感;参数 < 3B 时轻微上升 | 需反量化计算或特定 kernel | 消费级显卡本地部署、QLoRA 训练 |
| FP8 (E4M3 / E5M2) | ~50% | 极小 (< 0.02) | Hopper/Blackwell 原生支持 | 极大规模分布式训练(如 DeepSeek-V3/R1)、新一代高吞吐推理 |
8.1.4.1 关键结论与选型指南
- 大参数量对量化更具鲁棒性:例如 70B 模型在 INT4 量化下的困惑度损失(Perplexity Degradation)几乎为零,而 3B/7B 模型在 4-bit 量化下会出现明显的常识和推理能力衰退。因此,小模型不建议使用低于 4-bit 的量化部署。
- FP8 正在成为超大规模训练的主流选择:DeepSeek-V3 在 FP8(全部张量采用 E4M3 + 细粒度缩放,见 2.5.4.5 节)下完成了 14.8T tokens 的预训练。FP8 不仅能将权重和激活值显存减半,还能在 H100 等 GPU 上释放双倍的 Tensor Core 算力吞吐,相对 BF16 的 loss 误差低于 0.25%。
- NF4 (Normal Float 4) 专为正态分布设计:它是 QLoRA 能够成功训练的基石。预训练权重近似服从零均值正态分布,NF4 让每个量化区间覆盖相同的概率质量,因此比均匀间隔的 INT4/FP4 保留了更多信息。
8.2 📊 量化方法分类
8.2.1 按量化时机分类
graph LR
    A[量化方法] --> B[训练后量化<br>PTQ]
    A --> C[量化感知训练<br>QAT]

    B --> B1[动态量化<br>Dynamic]
    B --> B2[静态量化<br>Static]

    C --> C1[全量化训练<br>Full QAT]
    C --> C2[部分量化训练<br>Partial QAT]

    style B fill:#ffe0b2,stroke:#e65100
    style C fill:#c8e6c9,stroke:#1b5e20
8.2.2 训练后量化(Post-Training Quantization, PTQ)
定义:在模型训练完成后,直接对权重和激活值进行量化,无需重新训练。
优点:
- ⚡ 速度快:几分钟到几小时即可完成
- 💰 成本低:无需训练数据和GPU资源
- 🛠️ 易部署:可直接应用于任何预训练模型
缺点:
- 📉 精度损失:特别是低比特量化(INT4/INT2)
- ⚠️ 敏感性高:某些层对量化非常敏感
代表方法:
- GPTQ:基于二阶信息的逐层量化
- AWQ:基于激活值重要性的权重量化
- SmoothQuant:迁移量化难度从激活到权重
8.2.3 量化感知训练(Quantization-Aware Training, QAT)
定义:在训练过程中模拟量化操作,让模型学习适应量化误差。
核心思想:
- 前向传播:使用量化后的权重和激活值
- 反向传播:使用浮点梯度(STE技巧)
优点:
- ✅ 精度最高:模型主动适应量化
- ✅ 支持极低比特:INT4、INT2甚至二值化
缺点:
- ⏰ 训练时间长:需要重新训练或微调
- 💰 成本高:需要训练数据和GPU资源
代表方法:
- QLoRA:4-bit量化 + LoRA微调
- LLM-QAT:大模型量化感知训练
- BitNet:极低比特(1.58-bit)量化训练
8.2.4 按量化对象分类
| 量化对象 | 说明 | 难度 | 常用方法 |
|---|---|---|---|
| 仅权重 | 只量化模型参数 | 简单 | GPTQ, AWQ |
| 权重+激活 | 同时量化参数和中间结果 | 困难 | SmoothQuant, QAT |
| KV Cache | 量化推理阶段的注意力缓存,减少长上下文显存 | 中等 | INT8/INT4 Per-token, GQA/MQA |
8.3 🔧 训练后量化(PTQ)
8.3.1 GPTQ:基于二阶信息的权重量化
8.3.1.1 核心原理
GPTQ(GPT Post-Training Quantization)使用二阶导数信息优化量化误差,逐层量化权重矩阵。
优化目标:最小化量化前后输出差异
\[\arg\min_{\hat{W}} \| WX - \hat{W}X \|^2\]其中:
- $W$:原始FP16权重矩阵
- $\hat{W}$:量化后的INT4权重
- $X$:校准数据的激活值
关键技术:Optimal Brain Quantization (OBQ)
逐列量化权重:每量化完第 $i$ 列,就用 Hessian 逆矩阵把这一列产生的量化误差补偿到尚未量化的列上:
\[\delta_i = \frac{w_{:,i} - \text{quant}(w_{:,i})}{[H^{-1}]_{ii}}, \qquad W_{:,j} \leftarrow W_{:,j} - \delta_i \, [H^{-1}]_{ij} \quad (j > i)\]其中 $H = 2XX^\top$ 是层输出误差关于权重的 Hessian 矩阵(只依赖校准数据的激活 $X$)。GPTQ 在 OBQ 的基础上改为所有行共享同一列顺序、分块批量更新并用 Cholesky 分解求逆,把量化 175B 模型的时间降到约 4 个 GPU 小时。
8.3.1.2 实现流程
原版 AutoGPTQ 已停止维护,其继任者 GPTQModel 提供了几乎一致的流程:
from datasets import load_dataset
from gptqmodel import GPTQModel, QuantizeConfig

model_id = "meta-llama/Llama-2-7b-hf"
quant_path = "./llama-2-7b-gptq-4bit"

# Step 1: 准备校准数据(通常 128-1024 条文本)
calibration = load_dataset(
    "allenai/c4",
    data_files="en/c4-train.00001-of-01024.json.gz",
    split="train",
).select(range(1024))["text"]

# Step 2: 配置量化参数
quant_config = QuantizeConfig(
    bits=4,          # 量化位数:4-bit
    group_size=128,  # 每 128 个权重共享一组 scale / zero-point
)

# Step 3: 加载模型并执行 GPTQ(7B 模型通常十几到几十分钟)
model = GPTQModel.load(model_id, quant_config)
model.quantize(calibration, batch_size=2)

# Step 4: 保存量化模型(7B 权重:约 13.5GB → 约 4GB)
model.save(quant_path)

# Step 5: 加载量化模型推理
model = GPTQModel.load(quant_path)
print(model.tokenizer.decode(model.generate("The meaning of life is")[0]))
量化后的权重也可以直接被 transformers、vLLM 等框架加载使用。
8.3.1.3 GPTQ 性能表现
| 模型 | 原始精度 | GPTQ-4bit | 显存占用 | 精度损失 |
|---|---|---|---|---|
| LLaMA-7B | FP16 | INT4 | 14GB → ~3.5GB | 小 |
| LLaMA-13B | FP16 | INT4 | 26GB → ~6.5GB | 小 |
| LLaMA-30B | FP16 | INT4 | 60GB → ~15GB | 很小 |
| LLaMA-65B | FP16 | INT4 | 130GB → ~33GB | 很小 |
显存为权重部分的理论值(未计 group scale 的少量开销)。GPTQ 论文的规律是:模型越大,4-bit 量化带来的困惑度上升越小;3-bit 时小模型的损失会明显放大。
适用场景:
- ✅ 推理部署优化
- ✅ 资源受限环境
- ✅ 需要快速量化(无需训练)
8.3.2 AWQ:激活感知权重量化
8.3.2.1 核心洞察
AWQ(Activation-aware Weight Quantization)的核心发现:
并非所有权重都同等重要! 对应大激活值的权重通道对模型性能影响更大,应该保持更高精度。
量化策略:
\[Y = W X = \big(W \,\text{diag}(s)\big)\big(\text{diag}(s)^{-1} X\big) \;\;\Rightarrow\;\; \hat{Y} = Q\big(W \,\text{diag}(s)\big)\big(\text{diag}(s)^{-1} X\big)\]其中 $s$ 是按输入通道(per-channel)的缩放因子:先把重要通道的权重放大再量化,对应的激活同比缩小,数学上输出不变,但重要权重的相对量化误差变小。缩放因子最终会被合并进前一层的算子,推理时没有额外开销。
8.3.2.2 确定通道重要性
-
收集激活值统计:在校准数据上统计每个输入通道的平均激活幅值 $s_X$。
-
搜索缩放强度:令 $s = s_X^{\alpha}$,在 $[0, 1]$ 上网格搜索 $\alpha$,选使该层量化后输出误差最小的值:
激活越大的通道得到越大的放大系数,其权重的量化误差也就越小。AWQ 只需要少量校准数据、不做反向传播,因此不容易过拟合校准集。
8.3.2.3 实现代码
AutoAWQ 仓库已于 2025 年归档,AWQ 算法已并入 vLLM 维护的 llm-compressor。下面的经典写法仍可用于理解流程:
from awq import AutoAWQForCausalLM
from transformers import AutoTokenizer

model_path = "meta-llama/Llama-2-7b-hf"
quant_path = "llama-2-7b-awq-4bit"

# Step 1: 加载模型
model = AutoAWQForCausalLM.from_pretrained(model_path)
tokenizer = AutoTokenizer.from_pretrained(model_path)

# Step 2: 配置量化参数
quant_config = {
    "zero_point": True,          # 使用零点(非对称量化)
    "q_group_size": 128,         # 分组大小
    "w_bit": 4,                  # 权重量化位数
    "version": "GEMM"            # 使用优化的GEMM kernel
}

# Step 3: 量化(AWQ比GPTQ快2-3倍)
model.quantize(tokenizer, quant_config=quant_config)

# Step 4: 保存量化模型
model.save_quantized(quant_path)
tokenizer.save_pretrained(quant_path)

# 加载和推理
model_awq = AutoAWQForCausalLM.from_quantized(quant_path, fuse_layers=True)
8.3.2.4 AWQ vs GPTQ 对比
| 特性 | AWQ | GPTQ |
|---|---|---|
| 量化速度 | ⚡ 快(5-10分钟/7B) | 慢(20-30分钟/7B) |
| 精度保持 | ✅ 更好(特别是极低比特) | ✅ 好 |
| 推理速度 | ⚡⚡ 更快(优化kernel) | ⚡ 快 |
| 显存占用 | 相同 | 相同 |
| 校准数据 | 少(~128样本),对分布不敏感 | 较多(~128-1024样本) |
推荐选择:
- 追求极致精度 → AWQ
- 快速量化部署 → AWQ
- 需要广泛硬件支持 → GPTQ(生态更成熟)
8.3.3 SmoothQuant:平滑激活值分布
8.3.3.1 问题:为什么激活值难量化?
大模型的激活值存在严重的异常值(Outliers)问题:
- 99.9%的值在 $[-10, 10]$ 范围
- 0.1%的异常值可达 $[-1000, 1000]$
如果用统一的scale量化 → 大部分值被压缩到很小范围 → 精度损失巨大。
8.3.3.2 SmoothQuant 解决方案
核心思想:通过缩放因子将量化难度从激活值转移到权重:
\[Y = (X \text{ diag}(s)^{-1}) \cdot (\text{diag}(s)W)\]其中:
- $s$ 是per-channel的平滑因子
- $X \text{ diag}(s)^{-1}$:压缩激活值的异常值
- $\text{diag}(s)W$:将缩放因子吸收到权重中(权重更易量化)
确定平滑因子:
\[s_i = \max(|X_i|)^\alpha / \max(|W_i|)^{1-\alpha}\]其中 $\alpha \in [0, 1]$ 控制平滑强度(通常0.5)。
8.3.3.3 实现示例
SmoothQuant 官方仓库(mit-han-lab/smoothquant)提供的是研究用参考实现;生产上更常用 vLLM 维护的 llm-compressor,把 SmoothQuant 与 GPTQ 组合成一份”配方”一次性完成 W8A8 量化:
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier
from llmcompressor.modifiers.smoothquant import SmoothQuantModifier

model_id = "meta-llama/Llama-2-7b-hf"
model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto")
tokenizer = AutoTokenizer.from_pretrained(model_id)

# 校准数据:几百条与目标场景相近的文本
ds = load_dataset("allenai/c4", data_files="en/c4-train.00001-of-01024.json.gz", split="train")
ds = ds.shuffle(seed=0).select(range(512))

recipe = [
    SmoothQuantModifier(smoothing_strength=0.8),                   # 迁移激活中的离群值(即 α)
    GPTQModifier(targets="Linear", scheme="W8A8", ignore=["lm_head"]),  # 权重与激活均为 INT8
]

oneshot(model=model, dataset=ds, recipe=recipe,
        max_seq_length=2048, num_calibration_samples=512)

model.save_pretrained("llama-2-7b-w8a8", save_compressed=True)
tokenizer.save_pretrained("llama-2-7b-w8a8")
生成的 checkpoint 可以直接交给 vLLM 以 INT8 GEMM 推理。
8.3.3.4 SmoothQuant 性能
SmoothQuant 论文在 OPT-175B、BLOOM-176B、GLM-130B 等模型上验证:
- 精度:W8A8 量化后在 LAMBADA、HellaSwag 等零样本任务上与 FP16 基本持平;而不做平滑的朴素 W8A8 在 6.7B 以上的 OPT 模型上会因激活离群值出现明显精度崩溃
- 效率:相比 FP16 最高约 1.56× 加速、显存减半,可在单个 8 卡节点内部署 530B 规模的模型
关键优势:
- ✅ 无需训练、精度基本无损的 W8A8(权重+激活都 INT8)方案
- ✅ 硬件友好:平滑因子可离线合并进前一层权重,推理时直接使用标准 INT8 GEMM
- ✅ 适合高吞吐的服务端推理
8.4 🎓 量化感知训练(QAT)
8.4.1 QLoRA:4-bit量化 + LoRA微调
QLoRA 是当前最流行的量化微调方法,实现了在单张 48GB GPU 上微调 65B 模型。严格来说,它只把冻结的基座权重量化为 4-bit、训练的仍是 16-bit 的 LoRA 适配器,并不是让模型适应量化误差的”经典 QAT”,但因为训练发生在量化模型之上,通常与 QAT 放在一起讨论。
8.4.1.1 核心技术组合
- 4-bit NormalFloat (NF4) 量化
- 双重量化(Double Quantization)
- 分页优化器(Paged Optimizers)
- LoRA 适配器
8.4.1.2 NF4量化:信息理论最优量化
标准的4-bit整数量化范围:$[-7, 7]$(均匀分布)
问题:神经网络权重通常服从正态分布 $\mathcal{N}(0, \sigma^2)$,均匀量化浪费表示能力。
NF4方案:量化点按正态分布分位数分布
# NF4的16个量化点(针对N(0,1)优化)
NF4_QUANT_LEVELS = [
    -1.0, -0.6961928009986877, -0.5250730514526367, -0.39491748809814453,
    -0.28444138169288635, -0.18477343022823334, -0.09105003625154495, 0.0,
    0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224,
    0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0
]
归一化 + NF4量化:
\[\hat{W} = \text{NF4}\left(\frac{W}{\sigma_W}\right) \cdot \sigma_W\]优势:每个量化区间覆盖相同的概率质量,对近似正态分布的权重是信息论意义下的最优 4-bit 数据类型;QLoRA 论文中 NF4 的困惑度与下游精度均优于 FP4 和 INT4。
8.4.1.3 双重量化(Double Quantization)
问题:FP32的缩放因子 $s$ 占用可观的内存(每64个参数1个FP32,相当于每个参数额外 0.5 bit)。
解决:对缩放因子本身也量化!
# 第一次量化:权重 → INT4
W_quant = quantize_nf4(W, scale_fp32)

# 第二次量化:缩放因子 FP32 → FP8
scale_quant = quantize_fp8(scale_fp32)

# 第二次量化以 256 个 scale 为一组,每组再存 1 个 FP32 二级 scale
# 每参数的 scale 开销:32/64 = 0.5 bit → 8/64 + 32/(64×256) ≈ 0.127 bit
# 平均每参数节省约 0.37 bit,65B 模型约省 3GB
8.4.1.4 完整QLoRA训练流程
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from trl import SFTConfig, SFTTrainer
from datasets import load_dataset

# ============================================================
# Step 1: 4-bit量化配置(NF4 + 双重量化)
# ============================================================
from transformers import BitsAndBytesConfig

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,                      # 启用4-bit量化
    bnb_4bit_quant_type="nf4",              # 使用NF4量化(信息理论最优)
    bnb_4bit_use_double_quant=True,         # 双重量化(scale也量化)
    bnb_4bit_compute_dtype=torch.bfloat16,  # 计算时用BF16(保持精度)
)

# ============================================================
# Step 2: 加载4-bit量化模型(70B模型的权重约35GB)
# ============================================================
model_name = "meta-llama/Llama-2-70b-hf"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,
    device_map="auto",                      # 自动多卡分配
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

# ============================================================
# Step 3: 准备量化模型用于训练
# ============================================================
model = prepare_model_for_kbit_training(model)

# ============================================================
# Step 4: 配置LoRA参数(只训练约1.2%参数)
# ============================================================
lora_config = LoraConfig(
    r=64,                                   # LoRA秩(越大越接近全参数微调)
    lora_alpha=16,                          # 缩放因子(沿用QLoRA论文:r=64, alpha=16)
    target_modules=[                        # 对哪些层应用LoRA
        "q_proj", "k_proj", "v_proj",       # 注意力层
        "o_proj",
        "gate_proj", "up_proj", "down_proj" # FFN层
    ],
    lora_dropout=0.05,                      # Dropout防止过拟合
    bias="none",                            # 不训练bias
    task_type="CAUSAL_LM"
)

# ============================================================
# Step 5: 应用LoRA到量化模型
# ============================================================
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
# 输出示例:
# trainable params: 828,375,040 || all params: 69,805,023,232 || trainable%: 1.1867

# ============================================================
# Step 6: 准备训练数据
# ============================================================
dataset = load_dataset("timdettmers/openassistant-guanaco")

# ============================================================
# Step 7: 配置训练参数
# ============================================================
training_args = SFTConfig(
    output_dir="./qlora-llama-70b",
    num_train_epochs=3,
    per_device_train_batch_size=1,         # 70B 模型单卡只能放下很小的 batch
    gradient_accumulation_steps=16,        # 等效batch_size=16
    gradient_checkpointing=True,           # 激活重计算,进一步省显存
    max_length=2048,                       # 最大序列长度
    dataset_text_field="text",             # guanaco 数据集的文本字段
    learning_rate=2e-4,                    # QLoRA典型学习率
    lr_scheduler_type="cosine",
    warmup_ratio=0.03,
    logging_steps=10,
    save_strategy="epoch",
    optim="paged_adamw_8bit",              # 分页优化器(防止OOM)
    fp16=False,
    bf16=True,                             # 使用BF16(A100推荐)
)

# ============================================================
# Step 8: 开始训练
# ============================================================
trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    processing_class=tokenizer,            # 新版 TRL 用 processing_class 取代 tokenizer 参数
)

trainer.train()

# ============================================================
# Step 9: 保存LoRA适配器(仅~200MB!)
# ============================================================
model.save_pretrained("./qlora-adapter")

# ============================================================
# Step 10: 部署时合并LoRA(可选)
# ============================================================
from peft import PeftModel

# 合并时以 BF16 加载基座:直接合并进 4-bit 权重会引入额外的舍入误差
base_model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 加载并合并LoRA,之后可按需重新量化用于部署
model = PeftModel.from_pretrained(base_model, "./qlora-adapter")
model = model.merge_and_unload()  # 合并LoRA权重到基座
8.4.1.5 QLoRA 显存占用分析
以 LLaMA-2-70B 为例:
| 组件 | BF16 全参数微调 | QLoRA(4-bit,r=64 覆盖全部线性层) |
|---|---|---|
| 模型权重 | 140 GB | ~35 GB(NF4 + 双重量化) |
| 梯度 | 140 GB | ~1.7 GB(仅 8.3 亿 LoRA 参数) |
| 优化器状态 | 840 GB(FP32 主权重 + m + v) | ~2–7 GB(仅 LoRA 参数,精度取决于优化器) |
| 激活值 | 取决于 batch 与序列长度 | 开启梯度检查点后通常数 GB |
| 总计 | > 1.1 TB | ~45–50 GB |
结论:70B 模型的全参数微调至少需要 16 张 A100-80G 并配合 ZeRO 分片;QLoRA 把它压到了单张 A100/H100-80G(QLoRA 论文的 65B 实验用的是单张 48GB GPU)。
8.4.2 BitNet:1.58-bit极限量化
BitNet 将量化推向极限:每个权重只用1.58 bit(三值:-1, 0, +1)。
8.4.2.1 核心设计
三值权重:
\[W \in \{-1, 0, +1\}\]激活值:8-bit量化(保持一定精度)
为什么是1.58 bit?
三个取值 ${-1, 0, +1}$ 所能携带的最大信息量为 $\log_2 3 \approx 1.58$ bit(三值等概率时取到)。实际存储时通常把 5 个三值权重打包进 1 个字节($3^5 = 243 \le 256$),即每权重 1.6 bit。
8.4.2.2 训练方法
- 前向传播:使用三值权重
即先用权重绝对值的均值(absmean)归一化,再四舍五入并裁剪到 ${-1, 0, +1}$。
-
反向传播:对浮点权重计算梯度(STE技巧)
-
权重更新:更新浮点权重,再投影到三值
8.4.2.3 性能表现
BitNet b1.58 论文(Ma et al., 2024)的主要结论:
- 3B 起追平全精度:3B 规模的 BitNet b1.58 困惑度与零样本精度与同尺寸 FP16 LLaMA 相当,同时推理快 2.71×、显存省 3.55×
- 越大越划算:70B 规模时推理速度约为 LLaMA 70B 的 4.1×
- 前提:必须从头训练(量化感知训练),不能把已有的 FP16 模型直接转换成 1.58-bit;微软后续开源了 BitNet b1.58 2B4T(2B 参数、4T tokens)
适用场景:
- 📱 端侧部署(手机、IoT设备)
- ⚡ 超低延迟推理
- 💰 极致成本优化
8.5 🛠️ 量化工程实践
8.5.1 量化工具生态
| 工具 | 支持方法 | 特点 | 推荐场景 |
|---|---|---|---|
| Unsloth | LoRA, QLoRA, 4-bit, 16-bit, FP8, GRPO | 2×加速,减少70% VRAM,兼容HF生态 | 消费级GPU高效微调 |
| bitsandbytes | QLoRA, 8-bit, 4-bit | 易用,Hugging Face集成 | QLoRA微调 |
| GPTQModel(AutoGPTQ 继任者) | GPTQ | 成熟,广泛支持 | PTQ部署 |
| llm-compressor(vLLM) | GPTQ, AWQ, SmoothQuant, FP8 | 一套配方覆盖多种算法,产物可直接给 vLLM | 生产部署 |
| llama.cpp | GGUF/GGML | CPU推理优化 | 本地CPU部署 |
| vLLM | FP8, INT8 | 高吞吐推理 | 生产部署 |
| TensorRT-LLM | INT8, INT4, FP8 | NVIDIA优化 | NVIDIA GPU部署 |
8.5.2 量化流程最佳实践
8.5.2.1 选择量化方法的决策树
graph TD
    A[需要量化?] -->|是| B{有训练资源?}
    A -->|否| Z[使用FP16/BF16]

    B -->|有| C{追求极致精度?}
    B -->|无| D[使用PTQ]

    C -->|是| E[QLoRA/QAT<br>4-bit训练]
    C -->|否| F[LoRA微调<br>BF16]

    D --> G{目标比特数?}

    G -->|INT8| H[SmoothQuant<br>权重+激活]
    G -->|INT4| I{优先级?}

    I -->|精度| J[AWQ]
    I -->|速度| K[GPTQ]

    style E fill:#c8e6c9
    style J fill:#ffe0b2
    style K fill:#ffe0b2
    style H fill:#fff9c4
8.5.2.2 量化前后的精度对比
先在量化前建立 FP16 基线,再用同一套任务评估量化模型。使用 EleutherAI 的 lm-evaluation-harness:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from lm_eval import simple_evaluate
from lm_eval.models.huggingface import HFLM

TASKS = ["hellaswag", "winogrande", "arc_easy", "arc_challenge"]

def evaluate(path, **load_kwargs):
    model = AutoModelForCausalLM.from_pretrained(path, device_map="auto", **load_kwargs)
    tokenizer = AutoTokenizer.from_pretrained(path)
    out = simple_evaluate(model=HFLM(pretrained=model, tokenizer=tokenizer),
                          tasks=TASKS, num_fewshot=0)
    return {t: out["results"][t]["acc,none"] for t in TASKS}

base = evaluate("meta-llama/Llama-2-7b-hf", torch_dtype=torch.float16)  # FP16 基线
quant = evaluate("./llama-2-7b-gptq-4bit")  # GPTQ 权重,需安装 gptqmodel

for t in TASKS:
    drop = (base[t] - quant[t]) / base[t] * 100
    print(f"{t}: {base[t]:.4f} → {quant[t]:.4f} (-{drop:.2f}%)")
可接受的精度损失:
- ✅ INT8:<2%
- ✅ INT4:<5%(GPTQ/AWQ)
- ⚠️ INT4:5-10%(简单量化)
- ❌ INT4:>10%(量化失败,需调整策略)
8.5.2.3 处理量化失败的层
某些层对量化格外敏感:输出层 lm_head、Embedding,以及激活离群值特别大的层(常见于 MLP 的 down_proj)。
策略:混合精度量化——敏感层保持 16-bit,其余层照常量化。
- GPTQ/AWQ 类工具默认只量化 Transformer Block 内的
Linear层,Embedding 和lm_head本来就保持原精度 - 需要额外跳过某些层时,llm-compressor 的配方可以写
ignore=["lm_head", "re:.*down_proj"](支持正则);bitsandbytes 则通过BitsAndBytesConfig(llm_int8_skip_modules=[...])指定 - 代价是少量额外显存;判断是否值得,就看上一节的精度对比
8.5.3 量化的常见陷阱
8.5.3.1 ❌ 陷阱1:使用过少的校准数据
# 错误示例
calibration_data = dataset[:10]  # 只用10个样本 ❌

# 正确做法
calibration_data = dataset[:512]  # 至少128-1024个样本 ✅
8.5.3.2 ❌ 陷阱2:校准数据分布不匹配
# 错误示例:用代码数据校准对话模型 ❌
calibration_data = load_dataset("codeparrot/github-code")

# 正确做法:用目标任务相似的数据 ✅
calibration_data = load_dataset("allenai/c4", split="train[:1000]")  # 通用文本
# 或
calibration_data = load_dataset("OpenAssistant/oasst1")  # 对话数据
8.5.3.3 ❌ 陷阱3:直接对激活做 per-tensor INT8 量化
大模型的激活中少数通道的幅值可比其他通道大两个数量级。对激活做 per-tensor 的朴素 INT8 量化时,这些离群值会拉大缩放因子,把其余通道压缩到只剩几个量化级,精度随之崩溃。
正确做法:先用 SmoothQuant 把离群值迁移到权重,或对激活改用 per-token 动态量化;实在不行就把敏感层保留为 16-bit(见 8.5.2.3 节)。
8.6 📊 量化方案选型总结
| 场景 | 推荐方法 | 量化精度 | 精度影响 | 权重显存节省(相对 FP16) |
|---|---|---|---|---|
| 微调训练 | QLoRA | 4-bit 基座 + 16-bit LoRA | 与 16-bit LoRA 基本持平 | ~75% |
| 推理部署(精度优先) | AWQ | 4-bit | 小 | ~75% |
| 推理部署(生态优先) | GPTQ | 4-bit | 小 | ~75% |
| 生产高吞吐 | SmoothQuant W8A8 / FP8 | 8-bit | 基本无损 | ~50% |
| 边缘设备 | INT8 QAT | 8-bit | 基本无损 | ~50% |
| 端侧极限 | BitNet b1.58 | 1.58-bit | 需从头训练,3B 起与 FP16 相当 | ~90% |
精度影响随模型规模、任务和校准数据变化很大:一般规律是模型越大越耐量化,数学与代码等需要精确推理的任务比常识问答更敏感。上线前务必在自己的任务上按 8.5.2.2 节做对比。
8.7 🔮 量化技术的未来趋势
8.7.1 混合精度量化(Mixed-Precision Quantization)
不同层使用不同比特数:
- 敏感层(注意力层):INT8
- 普通层(FFN):INT4
- 不敏感层:INT2
8.7.2 训练后零样本量化(Zero-Shot PTQ)
无需校准数据,直接从权重分布推断量化参数。
8.7.3 硬件-算法协同设计
- NVIDIA Hopper:原生支持 FP8 训练与推理
- NVIDIA Blackwell:原生支持 FP4(NVFP4 / MXFP4)等微缩放(micro-scaling)格式,4-bit 推理与低比特训练进一步硬件化
- 专用NPU:二值/三值神经网络专用芯片
8.7.4 大模型特定优化
- 稀疏性+量化:结合剪枝,进一步压缩
- KV Cache量化:长上下文场景的关键优化(详见下节)
- 动态量化:根据输入自适应调整量化精度
8.7.5 KV Cache 显存管理
8.7.5.1 为什么 KV Cache 会占用大量显存?
大模型推理包含两个阶段:
- Prefill(预填充):将整个输入序列一次性并行处理,生成初始 K/V 矩阵
- Decode(解码):每次只生成一个 token,但需要访问所有历史 token 的 K/V
为避免重复计算历史 token 的 K/V,推理时将其缓存,这就是 KV Cache。随着序列变长,缓存持续增长,成为长上下文场景下显存的主要消耗来源。
flowchart LR
    subgraph prefill["① Prefill(并行处理)"]
        direction TB
        p1["输入序列<br/>token₁ token₂ … tokenₙ"] --> p2["Transformer<br/>并行计算所有 token"]
        p2 --> p3["KV Cache 初始化<br/>K₁V₁, K₂V₂, …, KₙVₙ"]
        p3 --> p4["输出第一个新 token"]
    end

    subgraph decode["② Decode(逐 token 自回归)"]
        direction TB
        d1["新 token<br/>tokenₙ₊₁"] --> d2["读取 KV Cache<br/>(跳过历史重算)"]
        d2 --> d3["追加<br/>Kₙ₊₁Vₙ₊₁ 到缓存"]
        d3 --> d4["输出下一个 token"]
        d4 -->|"继续循环"| d1
    end

    prefill -->|"缓存传递"| decode

    style p3 fill:#e3f2fd,stroke:#01579b
    style d2 fill:#e3f2fd,stroke:#01579b
    style d3 fill:#e8f5e9,stroke:#1b5e20
显存计算公式:
\[\text{KV Cache大小} = 2 \times L \times H_{kv} \times d \times n \times b \times \text{bytes\_per\_element}\]其中 $L$ = 层数,$H_{kv}$ = KV 头数(MHA 下等于注意力头数),$d$ = 每头维度,$n$ = 序列长度,$b$ = batch size,系数 2 对应 K 和 V。
以 LLaMA-2-7B 为例(32 层,32 个 KV 头,128 维,FP16):
- 每 token 占用:$2 \times 32 \times 32 \times 128 \times 2\ \text{bytes} = \mathbf{0.5 \text{ MB}}$
- 一条 4K 上下文的请求约占 2GB;batch=32 时 KV Cache 达到 64GB,远超模型权重本身(约 13.5GB)
对比 LLaMA-2-70B(80 层,但用 GQA 只保留 8 个 KV 头):每 token 为 $2 \times 80 \times 8 \times 128 \times 2 \approx 0.31$ MB,参数量是 7B 的 10 倍,KV Cache 反而更小——这正是下文 GQA 的作用。
8.7.5.2 KV Cache 量化
直接对缓存的 K/V 矩阵进行低精度量化,无需修改模型结构:
| 精度 | 方法 | 显存节省 | 精度影响 |
|---|---|---|---|
| INT8 | Per-token 动态量化 | ~50% | 极小 |
| INT4 | Per-group 量化 | ~75% | 小 |
| FP8 | 硬件原生(H100) | ~50% | 极小 |
8.7.5.3 GQA / MQA:从架构层面减少 KV Cache
比量化更根本的优化:减少 KV 头的数量。
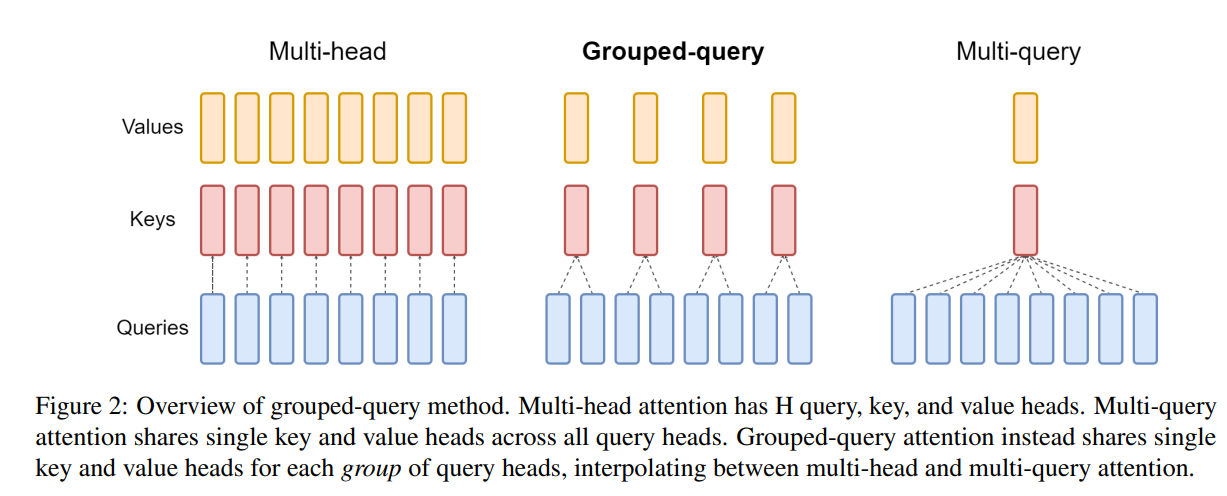
MHA: [Q1 K1V1] [Q2 K2V2] [Q3 K3V3] [Q4 K4V4]  ← KV头数 = Q头数
GQA: [Q1 Q2] [K1V1]  [Q3 Q4] [K2V2]            ← KV头数 = Q头数 / 组大小
MQA: [Q1 Q2 Q3 Q4]   [K1V1]                    ← 所有 Q 共享 1 个 KV 头
| 方式 | 全称 | KV Cache 大小 | 代表模型 |
|---|---|---|---|
| MHA | Multi-Head Attention | 基准(1×) | GPT-2, BERT, LLaMA-2-7B |
| GQA | Grouped-Query Attention | 减少为 1/组大小 | LLaMA-2-70B, LLaMA-3 全系列, Mistral |
| MQA | Multi-Query Attention | 减少为 1/H | PaLM, Falcon-7B |
GQA 是目前主流大模型的首选方案,在显存节省与模型质量之间取得较好平衡。
8.7.5.4 MLA(Multi-head Latent Attention):DeepSeek-V2/V3 的进一步压缩
GQA/MQA 通过减少 KV 头的数量来压缩缓存,但本质上仍是”存储原始 K/V 向量”。DeepSeek-V2 提出的 MLA(多头潜在注意力) 换了一个思路:不存储原始 K/V,而是将其联合压缩为一个低维潜在向量(Latent Vector),推理时再实时还原。
核心原理:
\[\mathbf{c}_t^{KV} = W^{DKV} \mathbf{h}_t \quad (\text{压缩为低维潜在向量,维度 } d_c \ll d_h \times n_h)\] \[\mathbf{k}_t = W^{UK} \mathbf{c}_t^{KV}, \quad \mathbf{v}_t = W^{UV} \mathbf{c}_t^{KV} \quad (\text{推理时上投影还原})\]其中只有压缩后的潜在向量 \(\mathbf{c}_t^{KV}\) 被缓存,K/V 的上投影矩阵 $W^{UK}, W^{UV}$ 在推理时实时计算,因此缓存的数据量与”KV 头数”完全无关,只取决于潜在维度 $d_c$。
| 方式 | KV Cache 存储内容 | 每 token 每层缓存的元素数 |
|---|---|---|
| MHA | 完整 K、V 向量 | $2 n_h d_h$ |
| GQA | 分组共享的 K、V 向量 | $2 n_g d_h$($n_g$ 为组数) |
| MLA | 低维联合潜在向量 + 解耦 RoPE 键 | $d_c + d_h^R$ |
DeepSeek-V2 取 $d_c = 4d_h$、$d_h^R = d_h/2$,每 token 每层只缓存 $4.5\,d_h$ 个元素,相当于只有 2.25 组的 GQA;而其 MHA 有 128 个头,同样的缓存要 $256\,d_h$。与上一代 DeepSeek 67B 相比,DeepSeek-V2 的 KV Cache 减少了 93.3%,最大生成吞吐提升到 5.76 倍。
关键工程细节:
- 解耦旋转位置编码(Decoupled RoPE):由于潜在向量经过低秩压缩后无法直接套用 RoPE(RoPE 要求对每个 K 头独立旋转),MLA 额外引入一组不参与压缩的”位置感知”维度专门承载 RoPE 信息,与压缩后的内容维度拼接使用。
- 训练时无损,推理时大幅省显存:上投影矩阵可以与后续的注意力计算矩阵吸收合并,因此 MLA 在效果上接近标准 MHA(甚至在 DeepSeek-V2/V3 的报告中略优于 GQA),而显存占用接近甚至优于 MQA。
意义:MLA 是 DeepSeek-V2/V3/R1 能够支持超长上下文、同时把推理成本压到很低的关键架构创新之一,与 MoE、FP8 训练并列为 DeepSeek 系列最具影响力的三项工程贡献。
8.7.5.5 其他 KV Cache 节省技术
- Sliding Window Attention:每层只保留最近 $w$ 个 token 的 KV,多层堆叠后感受野仍可覆盖较长上下文
- Streaming LLM:保留最近窗口 + 最初几个 token 的 KV(初始 token 的注意力分数对整体分布有锚定作用)
- Prefix Caching(跨请求复用):相同前缀(如系统提示)的请求共享 KV Cache,在 API 服务场景中可节省 50%+ 成本
9. 数据工程
数据是大模型训练的基石。高质量的训练数据直接决定了模型的能力上限。本章系统介绍大模型训练中的数据工程技术。
🎯 本章导读
“Garbage in, garbage out”——数据质量直接决定模型上限。本章介绍数据采集、质量评估、去重、配比、Tokenization等完整数据处理流程。核心理念:高质量 > 大规模,多样性 > 单一来源。数据工程往往被低估,但它是训练成功的关键。
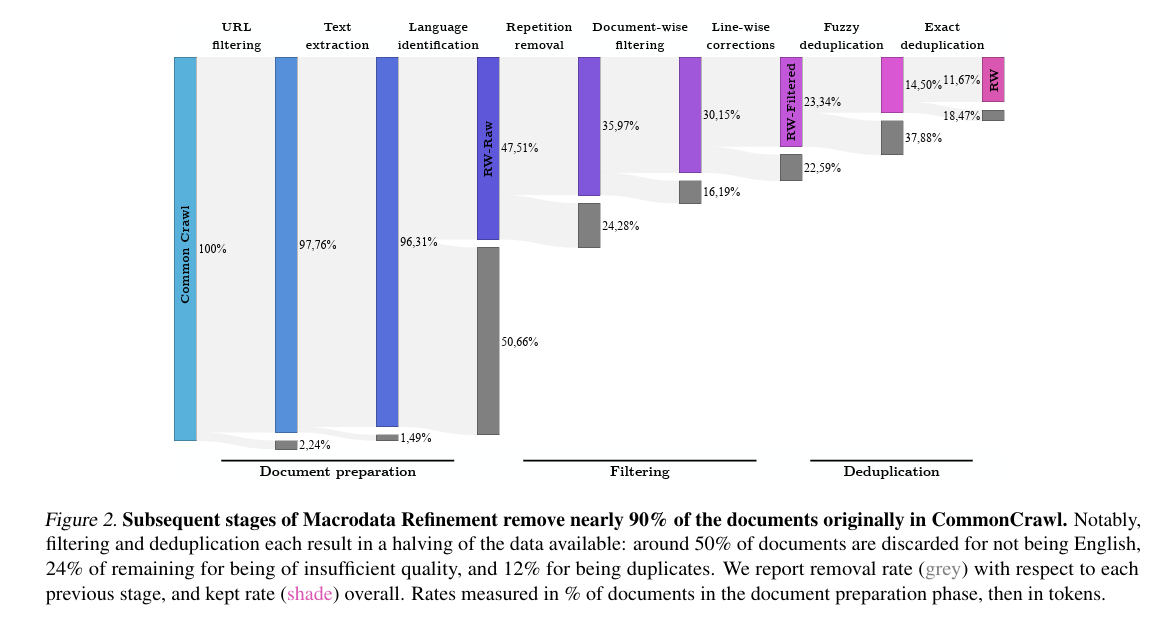
9.1 数据采集与来源
9.1.1 预训练数据来源
9.1.1.1 网页数据
- Common Crawl:最大的开放网页爬取数据集,每月爬取数十亿网页,包含多语言、多领域内容
- C4(Colossal Clean Crawled Corpus):基于Common Crawl清洗后的数据集,~750GB文本
- RedPajama:开源的LLaMA训练数据复现(1.2万亿token)
- FineWeb / FineWeb-Edu(Hugging Face, 2024):从 96 个 Common Crawl 快照中清洗出约 15T tokens;FineWeb-Edu 再用教育价值分类器筛出约 1.3T tokens 的高质量子集
9.1.1.2 代码数据
- GitHub:开源代码仓库(过滤星标、license)
- Stack Overflow:高质量代码问答
- The Stack:3TB源代码,30+编程语言
9.1.1.3 学术与书籍
- arXiv、PubMed:学术论文
- Books3、BookCorpus:书籍数据集
9.1.1.4 对话与社交媒体
- Reddit:高质量讨论和问答
- Wikipedia:结构化知识
- StackExchange:各领域专业问答
9.2 数据质量评估
9.2.1 启发式规则过滤
9.2.1.1 文本长度与格式
- 最小/最大长度过滤
- 特殊字符、数字、标点比例控制
- 大写字母密度检测
- 语言检测(fastText、langdetect)
9.2.1.2 重复内容检测
- 行级重复、段落重复
- 模板识别(网页模板、页眉页脚)
9.2.2 基于模型的质量评分
9.2.2.1 困惑度(Perplexity)过滤
- 使用小型语言模型评分
- 过滤困惑度过高的文档(需谨慎)
9.2.2.2 质量分类器
- 训练数据:人工标注高质量 vs 低质量样本
- 特征:文本流畅度、信息密度、语法正确性
- 模型:FastText、BERT分类器
9.2.2.3 教育价值评分
- Phi系列的启发:评估”教科书质量”
- 典型做法(FineWeb-Edu):先用强模型(Llama-3-70B-Instruct)给约 45 万个网页按 0–5 分打”教育价值”分,再用这些标注训练一个轻量分类器,对全量数据打分并保留高分文档
- 用这种方式筛出的数据,在 MMLU、ARC 等知识与推理类基准上能以更少的 token 达到同等效果
9.2.3 毒性与有害内容检测
9.2.3.1 毒性检测
- Perspective API:Google毒性评分API
- Detoxify:开源毒性检测模型
9.2.3.2 PII(个人身份信息)去除
- 姓名、地址、电话、邮箱
- 使用NER模型识别
- 密码、密钥:正则表达式匹配
9.3 数据去重
去重是最关键的数据处理步骤,可显著提升模型性能并减少记忆效应。
9.3.1 精确去重
- 文档级:基于MD5/SHA256 hash
- 段落/行级:对每个段落计算哈希,删除在语料中重复出现的段落(CCNet 的做法),可顺带去掉页眉页脚等模板文本
- URL去重:处理重定向和规范化
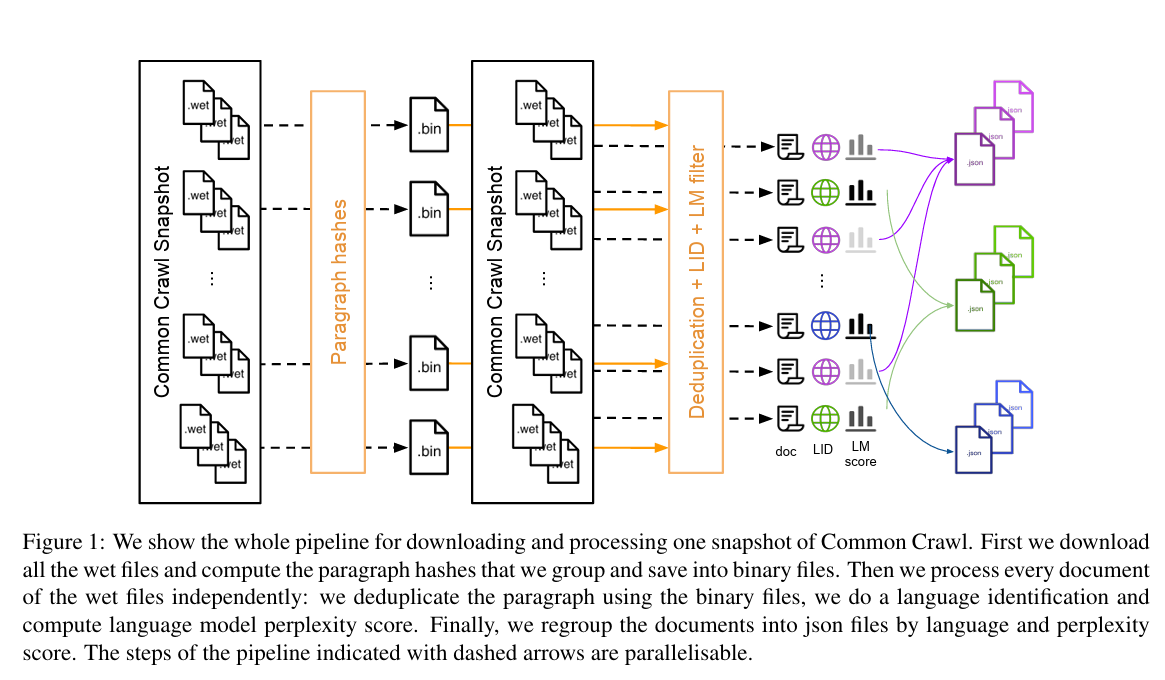
9.3.2 模糊去重
9.3.2.1 MinHash + LSH
- 估计Jaccard相似度
- 步骤:生成shingles → MinHash签名 → LSH找相似对
- 工具:datasketch库
9.3.2.2 SimHash
- 快速计算文档指纹
- 汉明距离判断相似度
9.3.2.3 Suffix Array
- 用后缀数组找出在语料中重复出现的长子串(Lee et al., 2022 以 50 个 token 为阈值),删除子串而非整篇文档
- 适合去掉跨文档复制粘贴的长段落(许可证文本、模板化内容),这类重复用文档级去重发现不了
9.3.3 跨数据集去重
9.3.3.1 训练集与测试集去重
- 至关重要:避免数据泄露
- 13-gram重叠检测(GPT-3)
- 影响评测可信度
9.3.4 去重Trade-off
- 过度去重:损失多样性
- 欠去重:浪费资源、增加记忆风险
- 平衡点:根据任务调整
9.4 数据配比与采样
9.4.1 静态配比策略
GPT-3配比示例:
pie title GPT-3预训练数据配比
    "Common Crawl" : 60
    "WebText2" : 22
    "Books" : 16
    "Wikipedia" : 3
LLaMA-1 配比(采样比例,总计约 1.4T tokens):
| 数据源 | 采样比例 | 对应 Token 数(×1.4T) | 说明 |
|---|---|---|---|
| CommonCrawl | 67.0% | ~938B | 网页数据,多样性最高 |
| C4 | 15.0% | ~210B | 清洗后的网页数据 |
| GitHub | 4.5% | ~63B | 代码数据 |
| Wikipedia | 4.5% | ~63B | 高质量百科知识(约训练 2.45 个 epoch) |
| Books | 4.5% | ~63B | 长文本,叙事能力(约 2.23 个 epoch) |
| ArXiv | 2.5% | ~35B | 数学、科学推理 |
| StackExchange | 2.0% | ~28B | 专业问答 |
Llama 3 的最终配比(按内容类型划分):约 50% 通用知识、25% 数学与推理、17% 代码、8% 多语言。与 LLaMA-1 相比,数学与代码的比例大幅提高,这与推理能力成为竞争焦点直接相关。
按配比构建批次(示意):
data_mixture = {
    'common_crawl': 0.67,    # 网页数据 - 通用语言能力
    'c4': 0.15,              # 清洗后的网页数据
    'github': 0.045,         # 代码 - 编程能力
    'wikipedia': 0.045,      # 百科 - 事实知识
    'books': 0.045,          # 书籍 - 长文本
    'arxiv': 0.025,          # 论文 - 科学推理
    'stackexchange': 0.02,   # 问答 - QA能力
}

def sample_batch(data_mixture, batch_size):
    """按配比构建训练批次"""
    batch = []
    for source, weight in data_mixture.items():
        n_samples = int(batch_size * weight)
        batch.extend(sample_from_source(source, n_samples))
    return batch
配比原则:
- 高质量数据提权:Wikipedia、Books、ArXiv虽然占比小,但会重复采样多个 epoch
- 代码与数学单独控制:从 LLaMA-1 的约 5% 提升到 Llama 3 的四成以上(代码 + 数学推理),提升推理能力但要避免挤占通用知识
- 问答数据少量但重要:StackExchange等问答数据培养问答能力
- 多样性优先:网页数据占主导,保证知识广度
9.4.2 动态配比策略
9.4.2.1 训练阶段调整
- 早期(0-70%):均衡配比
- 中期(70-90%):提升高质量数据
- 后期(90-100%):专注专业数据
9.4.2.2 基于损失的调整
- 监控不同数据源loss
- 动态再平衡
9.4.3 课程学习(Curriculum Learning)
- 从易到难:按困惑度排序
- 从通用到专业
9.4.4 Temperature Sampling
采样概率计算公式:
\[p_i = \frac{n_i^{\alpha}}{\sum_j n_j^{\alpha}}\]其中:
- $n_i$:数据源 $i$ 的原始样本数量
- $\alpha$:温度参数
- $\alpha < 1$:提升小数据源采样概率(up-sampling)
- $\alpha > 1$:降低小数据源采样概率(down-sampling)
- $\alpha = 1$:按原始比例采样
9.5 Tokenization
9.5.1 算法选择
- BPE(Byte Pair Encoding):GPT系列、LLaMA 全系列
- 从字符(或字节)开始迭代合并高频pair
- 字节级 BPE(GPT-2 起、Llama 3 的 tiktoken 分词器)以字节为基本单元,天然没有未登录词
- WordPiece:BERT,按合并后能最大提升语料似然的原则选择合并对
- Unigram:T5,从大词表出发按似然逐步剪枝
- SentencePiece:不是一种新算法,而是同时实现 BPE 与 Unigram 的工具库;直接在原始文本上训练、不依赖空格分词,适合中日文等多语言场景(LLaMA-1/2、T5 均使用)
9.5.2 词表大小
- 英语为主:32k - 50k
- 多语言:100k - 256k(Llama 3 为 128K,Qwen 约 151K,Gemma 为 256K)
- 代码模型:更大词表
Trade-off:
- 词表过小:序列长,训练慢
- 词表过大:embedding参数多,稀疏
9.5.3 特殊Token
- 标准:
<bos>,<eos>,<pad>,<unk> - 对话:
<|user|>,<|assistant|>,<|system|> - 多模态:
<image>,<video>
9.5.4 最佳实践
- 预训练、微调、推理使用相同tokenizer
- 预先tokenize并缓存
- 使用fast tokenizer(Rust实现)
- 多语言平衡token数量
10. 评估与基准测试
评估体系是衡量训练效果和指导训练方向的重要工具。本章介绍大模型训练中常用的评测基准。
10.1 语言理解与知识
10.1.1 MMLU(Massive Multitask Language Understanding)
- 内容:57个学科的多选题(数学、历史、法律、医学等)
- 规模:~16,000道题目
- 评估维度:知识广度、跨学科理解
- 难度:大学到专业水平
- 意义:衡量模型的通用知识储备
10.1.2 HellaSwag
- 任务:常识推理句子补全
- 方法:从4个选项中选择最合理的句子结尾
- 特点:对人类简单(~95%),对早期模型困难
- 评估:常识理解和情境推理
10.1.3 TruthfulQA
- 目标:评估模型输出的真实性
- 设计:包含常见误解和虚假信息的问题
- 评估维度:
- 模型是否会重复训练数据中的错误
- 是否会产生幻觉(Hallucination)
- 重要性:衡量模型可靠性
10.1.4 ARC(AI2 Reasoning Challenge)
- 内容:小学科学考试题
- 难度:Easy和Challenge两个版本
- 评估:科学推理和知识应用
10.2 推理能力
10.2.1 GSM8K(Grade School Math 8K)
- 任务:小学数学应用题
- 规模:8,500道题
- 特点:需要多步推理
- 评估方法:
- Direct答案评估
- Chain-of-Thought推理过程评估
- 意义:衡量基础数学推理能力
10.2.2 MATH
- 难度:高中到大学竞赛级别数学
- 规模:12,500道题
- 学科:代数、几何、概率、数论等
- 评估:复杂数学推理和问题解决
- 挑战:即使最强模型也难以达到高分
10.2.3 HumanEval
- 任务:Python函数实现
- 规模:164个编程问题
- 评估方法:单元测试通过率(pass@k)
- 特点:
- 独立函数,不涉及复杂系统
- 明确的输入输出规范
- 变体:HumanEval+(更严格测试)
10.2.4 MBPP(Mostly Basic Python Problems)
- 规模:1,000个Python编程问题
- 难度:入门到中级
- 评估:实用编程能力
10.2.5 BigCodeBench
- 特点:更复杂的真实世界编程任务
- 评估:工具使用、API调用、复杂逻辑
10.2.6 推理模型时代的新基准
GSM8K、HumanEval 等经典基准已被前沿模型”刷满”(准确率普遍超过 90%),区分度下降,也更容易受训练数据污染影响。推理模型与 Agent 的评测转向更难、更新的基准:
- AIME:美国数学邀请赛真题,每年 30 题,常以当年新题评测以避免污染
- GPQA Diamond:198 道研究生水平的物理、化学、生物选择题,专门设计为无法靠搜索引擎作答(Google-proof)
- LiveCodeBench:持续从编程竞赛平台收集新题,按题目发布时间筛选,缓解数据污染
- SWE-bench Verified:500 个经人工确认可解的真实 GitHub issue,要求模型修改代码仓库并通过测试,是编程 Agent 的主流基准
- Humanity’s Last Exam(HLE):约 2,500 道覆盖数十个学科的专家级难题,发布时前沿模型的准确率普遍不到 10%
10.3 多语言能力
10.3.1 FLORES(Facebook Low Resource Translation)
- 任务:机器翻译
- 覆盖:200+语言对
- 评估:跨语言理解和生成
- 重要性:衡量多语言模型能力
10.3.2 XNLI(Cross-lingual Natural Language Inference)
- 任务:自然语言推理(蕴含、矛盾、中立)
- 语言:15种语言
- 评估:零样本跨语言迁移能力
10.3.3 Belebele
- 任务:阅读理解
- 覆盖:122种语言
- 评估:广泛的多语言理解
10.4 长文本能力
10.4.1 RULER(Rule-based Evaluation of Long Context Understanding)
- 任务类型:
- 信息检索(Needle in a Haystack)
- 多跳推理
- 聚合统计
- 长度:4k到128k+ tokens
- 评估:长上下文建模能力
10.4.2 LongBench
- 任务:单文档/多文档QA、摘要、代码等
- 长度:平均5-15k tokens
- 语言:英文和中文
- 评估:真实长文本应用场景
10.4.3 Needle in a Haystack(大海捞针)
- 设计:在长文本中插入关键信息
- 测试:模型能否准确检索
- 变体:
- 单needle
- 多needle
- 不同位置和深度
10.5 安全性评估
10.5.1 ToxiGen
- 目标:检测有害内容生成倾向与隐性仇恨言论识别能力
- 方法:由 GPT-3 对抗式生成的约 27 万条关于 13 个少数群体的陈述(有毒与无毒各半),多数不含显式脏话
- 评估维度:
- 毒性
- 仇恨言论
- 暴力内容
10.5.2 BBQ(Bias Benchmark for QA)
- 任务:检测社会偏见
- 维度:
- 性别
- 种族
- 宗教
- 年龄
- 性取向等
- 方法:模糊和明确上下文对比
10.5.3 SafetyBench
- 覆盖:多类安全风险
- 语言:中英文
- 评估:拒绝回答不当请求的能力
10.5.4 红队测试方法论(Red Teaming)
静态安全基准测试(ToxiGen、BBQ、SafetyBench)只能覆盖测试集中已知的风险模式,而红队测试(Red Teaming)是主动寻找模型未知漏洞的过程,是安全对齐流程中与”训练”同等重要的”对抗性测试”环节。
10.5.4.1 人工红队 vs 自动化红队
| 方式 | 做法 | 优势 | 局限 |
|---|---|---|---|
| 人工红队 | 招募专业测试人员,手动构造攻击性 Prompt | 创造力强,能发现新颖的攻击模式 | 成本高、覆盖面有限、难以规模化 |
| 自动化红队 | 用另一个 LLM 自动生成攻击 Prompt(Red Team LLM vs Target LLM) | 可大规模并行、持续迭代 | 攻击模式可能局限于 Red Team LLM 自身的”想象力” |
10.5.4.2 自动化红队的典型流程
1. Red Team LLM 根据攻击目标(如"诱导模型输出制毒方法")生成候选 Prompt
2. Target LLM 对候选 Prompt 生成回答
3. 分类器/判别模型判断回答是否"越狱成功"(输出了不该输出的内容)
4. 将越狱成功的 (Prompt, 回答) 对作为负样本,用于后续安全 SFT/DPO 训练
5. 重复迭代:Red Team LLM 根据成功率调整攻击策略(如换用更隐蔽的话术、角色扮演包装)
这一流程与 4.7 节的”验证器驱动数据飞轮”思路一致——只是验证器从”答案对错”换成了”是否越狱成功”,红队测试本质上也是一种数据飞轮:自动发现漏洞 → 生成针对性训练数据 → 修补模型 → 红队继续寻找新漏洞。
10.5.4.3 常见越狱(Jailbreak)攻击模式
- 角色扮演诱导:要求模型”扮演一个没有任何限制的 AI”或虚构场景绕过安全限制
- 指令注入:在长上下文或多轮对话中逐步引导,使模型在后续轮次放松警惕
- 编码混淆:用 Base64、拼音、生僻字等编码方式绕过基于关键词的安全过滤
- 多语言攻击:用模型安全对齐覆盖较弱的小语种提出有害请求
- 学术/虚构包装:将有害请求包装成”小说创作”“学术研究”“安全研究”等看似合理的场景(呼应 4.5.5 节”对齐税与推理冲突”中提到的精准拒绝难题)
10.5.4.4 防御训练闭环
红队测试发现的漏洞最终要回流到训练流程中修补,常见做法:
- 将越狱样本加入 DPO/RLHF 的负样本(chosen=拒绝回答,rejected=被诱导的有害回答)
- 在 SFT 阶段加入”识别伪装意图”的样本,训练模型穿透包装识别真实请求性质
- 持续红队测试 + 周期性安全回归评估,防止修补一类漏洞后在其他维度退化(参见第5章”灾难性遗忘”中安全能力崩溃的案例)
行业实践:Anthropic、OpenAI 等公司在模型发布前都会引入第三方红队测试(External Red Teaming),其逻辑与软件安全测试中的渗透测试(Penetration Testing)类似——内部团队往往存在思维定式,外部视角更容易发现意料之外的攻击面。
10.6 对齐评估
10.6.1 MT-Bench
- 任务:多轮对话评估
- 评判:使用GPT-4作为评委
- 维度:
- 写作
- 角色扮演
- 推理
- 数学
- 编程等
10.6.2 AlpacaEval
- 方法:与参考模型的回答两两比较,由 LLM 评委判断胜负(AlpacaEval 2.0 以 GPT-4 Turbo 为参考与评委)
- 评估:指令跟随质量
- 输出:胜率(Win Rate);2.0 版本额外报告长度控制胜率(LC Win Rate),抵消评委偏爱长回答的偏差
10.6.3 Chatbot Arena(LMArena)
- 方法:真实用户对两个匿名模型的回答盲评投票,用 Bradley-Terry 模型计算 Elo 式评分
- 特点:持续更新的实时排行榜,2025 年起更名为 LMArena
- 意义:反映真实用户偏好(但也会受回答风格、长度与格式影响)
10.7 综合评测平台
10.7.1 LM Evaluation Harness
- 维护:Eleuther AI
- 特点:
- 统一接口
- 支持几十个基准测试
- 标准化评测流程
- 使用:研究社区广泛采用,Hugging Face Open LLM Leaderboard 即基于它;用法示例见 8.5.2.2 节
10.7.2 HELM(Holistic Evaluation of Language Models)
- 维度:
- 准确性
- 鲁棒性
- 公平性
- 偏见
- 效率
- 特点:多维度全面评估
10.7.3 OpenCompass
- 维护:上海AI Lab
- 特点:
- 中文优化
- 支持大规模评测
- 可视化排行榜
10.8 评测的最佳实践
10.8.1 避免数据泄露
- 训练数据与测试集严格去重
- 使用新发布的基准测试
- 定期更新评测集
10.8.2 多维度评估
- 不依赖单一指标
- 综合考虑性能、安全、效率
- 关注长尾能力和边界情况
10.8.3 评测与训练的关系
- 评测结果指导训练方向
- 避免过度针对基准优化(刷榜)
- 关注实际应用场景表现
11. 实践指南与最佳实践
本章提供实际训练大模型的工程指导,包括硬件配置、成本估算、监控调试和代码示例。
11.1 硬件配置建议
11.1.1 不同规模模型的推荐配置
| 模型规模 | 参数量 | 推荐GPU | 数量 | 显存需求 | 互联网络 | 适用场景 |
|---|---|---|---|---|---|---|
| 极小(MiniMind) | 26M-500M | RTX 3060/4060 | 1 | 8GB+ | PCIe 3.0 | 学习原理、极速验证 |
| 小型 | 1-3B | RTX 4090 | 4-8 | 24GB | PCIe 4.0 | 研究、原型开发 |
| 中型 | 7-13B | A100 | 16-32 | 40GB/80GB | InfiniBand | 企业应用 |
| 大型 | 30-70B | A100/H100 | 64-256 | 80GB | InfiniBand | 生产级模型 |
| 超大型 | 175B+ | H100 | 512-4096 | 80GB | InfiniBand/NVLink | 前沿研究 |
11.1.2 GPU选择指南
训练场景:
- 入门/个人实践:RTX 3060 (12GB) / 4060 Ti (16GB) —— 能够完整跑通 MiniMind 等 SLM 项目。
- 预算有限:RTX 4090(24GB,性价比高,适合小模型和LoRA微调)
- 企业级训练:A100(80GB,成熟稳定,生态完善)
- 最新旗舰:H100(80GB,性能最强,FP8支持,适合大规模训练)
网络互联:
- 节点内通信:NVLink(900GB/s)> PCIe 5.0(128GB/s)
- 节点间通信:InfiniBand(200-400Gb/s)> Ethernet(100Gb/s)
11.2 训练成本估算
11.2.1 成本构成
pie title 大模型训练成本构成
    "GPU租用/折旧" : 70
    "电力与冷却" : 15
    "存储与网络" : 5
    "人力成本" : 8
    "其他" : 2
11.2.2 详细成本计算
11.2.2.1 预训练成本估算
第一步:估算算力需求
稠密 Transformer 训练一个 token 约需 6 倍参数量的浮点运算(前向 2N、反向 4N),因此:
\[C_{\text{train}} \approx 6ND \quad \text{(FLOPs)}, \qquad \text{GPU 小时} \approx \frac{6ND}{\text{单卡峰值 FLOPS} \times \text{MFU} \times 3600}\]其中 $N$ 为参数量,$D$ 为训练 token 数,MFU(Model FLOPs Utilization)是实际达到的峰值算力比例,大规模训练通常在 35%–55%。
第二步:换算成本
\[\text{总成本} = \text{GPU 小时} \times \text{单价} + \text{存储、人力等其他成本}\]案例1:训练一个7B模型
模型规模:7B参数
训练数据:1T tokens
算力需求:6 × 7e9 × 1e12 ≈ 4.2e22 FLOPs
参考值:  LLaMA-1 7B 训练 1T tokens 实际用了约 82,432 A100 GPU 小时
GPU配置:256 × A100 (80GB)
训练时长:约2周(82,432 / 256 ≈ 322小时)

成本估算:
- GPU成本:$1.8/小时/卡(2026年云服务 A100 按需价,较2023年的$2.5/小时已明显下降)
- GPU总成本:82,432 × $1.8 ≈ $148,000
- 存储成本:10TB数据 × $0.02/GB/月 ≈ $200/月
- 网络成本:忽略不计
- 人力成本:1人 × 2周 × $5000/周 = $10,000
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
总成本:约 $160,000
案例2:训练一个70B模型
模型规模:70B参数
训练数据:2T tokens
算力需求:6 × 70e9 × 2e12 ≈ 8.4e23 FLOPs
GPU配置:512 × H100 (80GB),BF16 稠密峰值约 989 TFLOPS,按 MFU ≈ 45% 估算
训练时长:约6周(8.4e23 / (512 × 989e12 × 0.45) ≈ 3.7e6 秒 ≈ 1030小时)

成本估算:
- GPU成本:$2.2/小时/卡(2026年云服务 H100 按需价;H200/B200 更新机型价格更高,约$3.2-5.5/小时)
- GPU总成本:512 × $2.2 × 1030 ≈ $1,160,000
- 存储成本:50TB × $0.02/GB/月 × 1.5 ≈ $1,500
- 人力成本:3人 × 6周 × $5000/周 = $90,000
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
总成本:约 $1,250,000 (约125万美元)
真实案例对比:DeepSeek-V3(671B 参数,MoE 架构)
DeepSeek-V3 技术报告公开了其训练成本:使用 2048 张 H800 GPU,预训练、上下文扩展与后训练累计 278.8 万 GPU 小时,按每 GPU 小时 2 美元估算,总成本约 557.6 万美元(报告特别说明,这只是正式训练的成本,不含此前的架构、算法与数据消融实验)——对于一个性能接近 GPT-4 级别的 671B 参数模型而言,这一成本远低于行业预期,核心原因正是 FP8 混合精度训练 + MLA 架构 + 高效 MoE 路由 三项工程优化的叠加效果(详见本文「FP8 训练工程实践」与「MLA」相关章节)。这也是”低成本高性能”成为 2025-2026 年大模型训练新竞争维度的标志性案例。
案例3:微调(LoRA)成本
基础模型:70B参数
微调方法:QLoRA
数据规模:50k样本
GPU配置:1 × A100 (80GB)
训练时长:约12小时

成本估算:
- GPU成本:$1.8/小时
- GPU总成本:1 × $1.8 × 12 = $22
- 数据标注:50k × $0.5 = $25,000
- 人力成本:$2,000
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
总成本:约 $27,022
11.2.3 成本优化策略
11.2.3.1 硬件优化
- 使用Spot/Preemptible实例(节省50-70%)
- 混合精度训练(BF16/FP8)
- Flash Attention减少显存
11.2.3.2 算法优化
- 梯度检查点(Gradient Checkpointing)
- 激活重计算(Activation Recomputation)
- ZeRO优化器(DeepSpeed)
11.2.3.3 数据优化
- 高质量数据 > 海量数据
- 提前进行数据清洗和去重
- 使用数据缓存和预处理
11.2.3.4 训练策略
- 从小模型开始验证(消融实验)
- 使用Learning Rate Finder
- 早期终止(Early Stopping)
⚠️ 成本陷阱
- 过度预训练:收益递减,建议监控validation loss
- 盲目扩大规模:先验证小模型效果
- 忽视数据质量:垃圾数据浪费计算资源
- 缺乏监控:未及时发现训练异常导致浪费
11.3 训练监控与调试
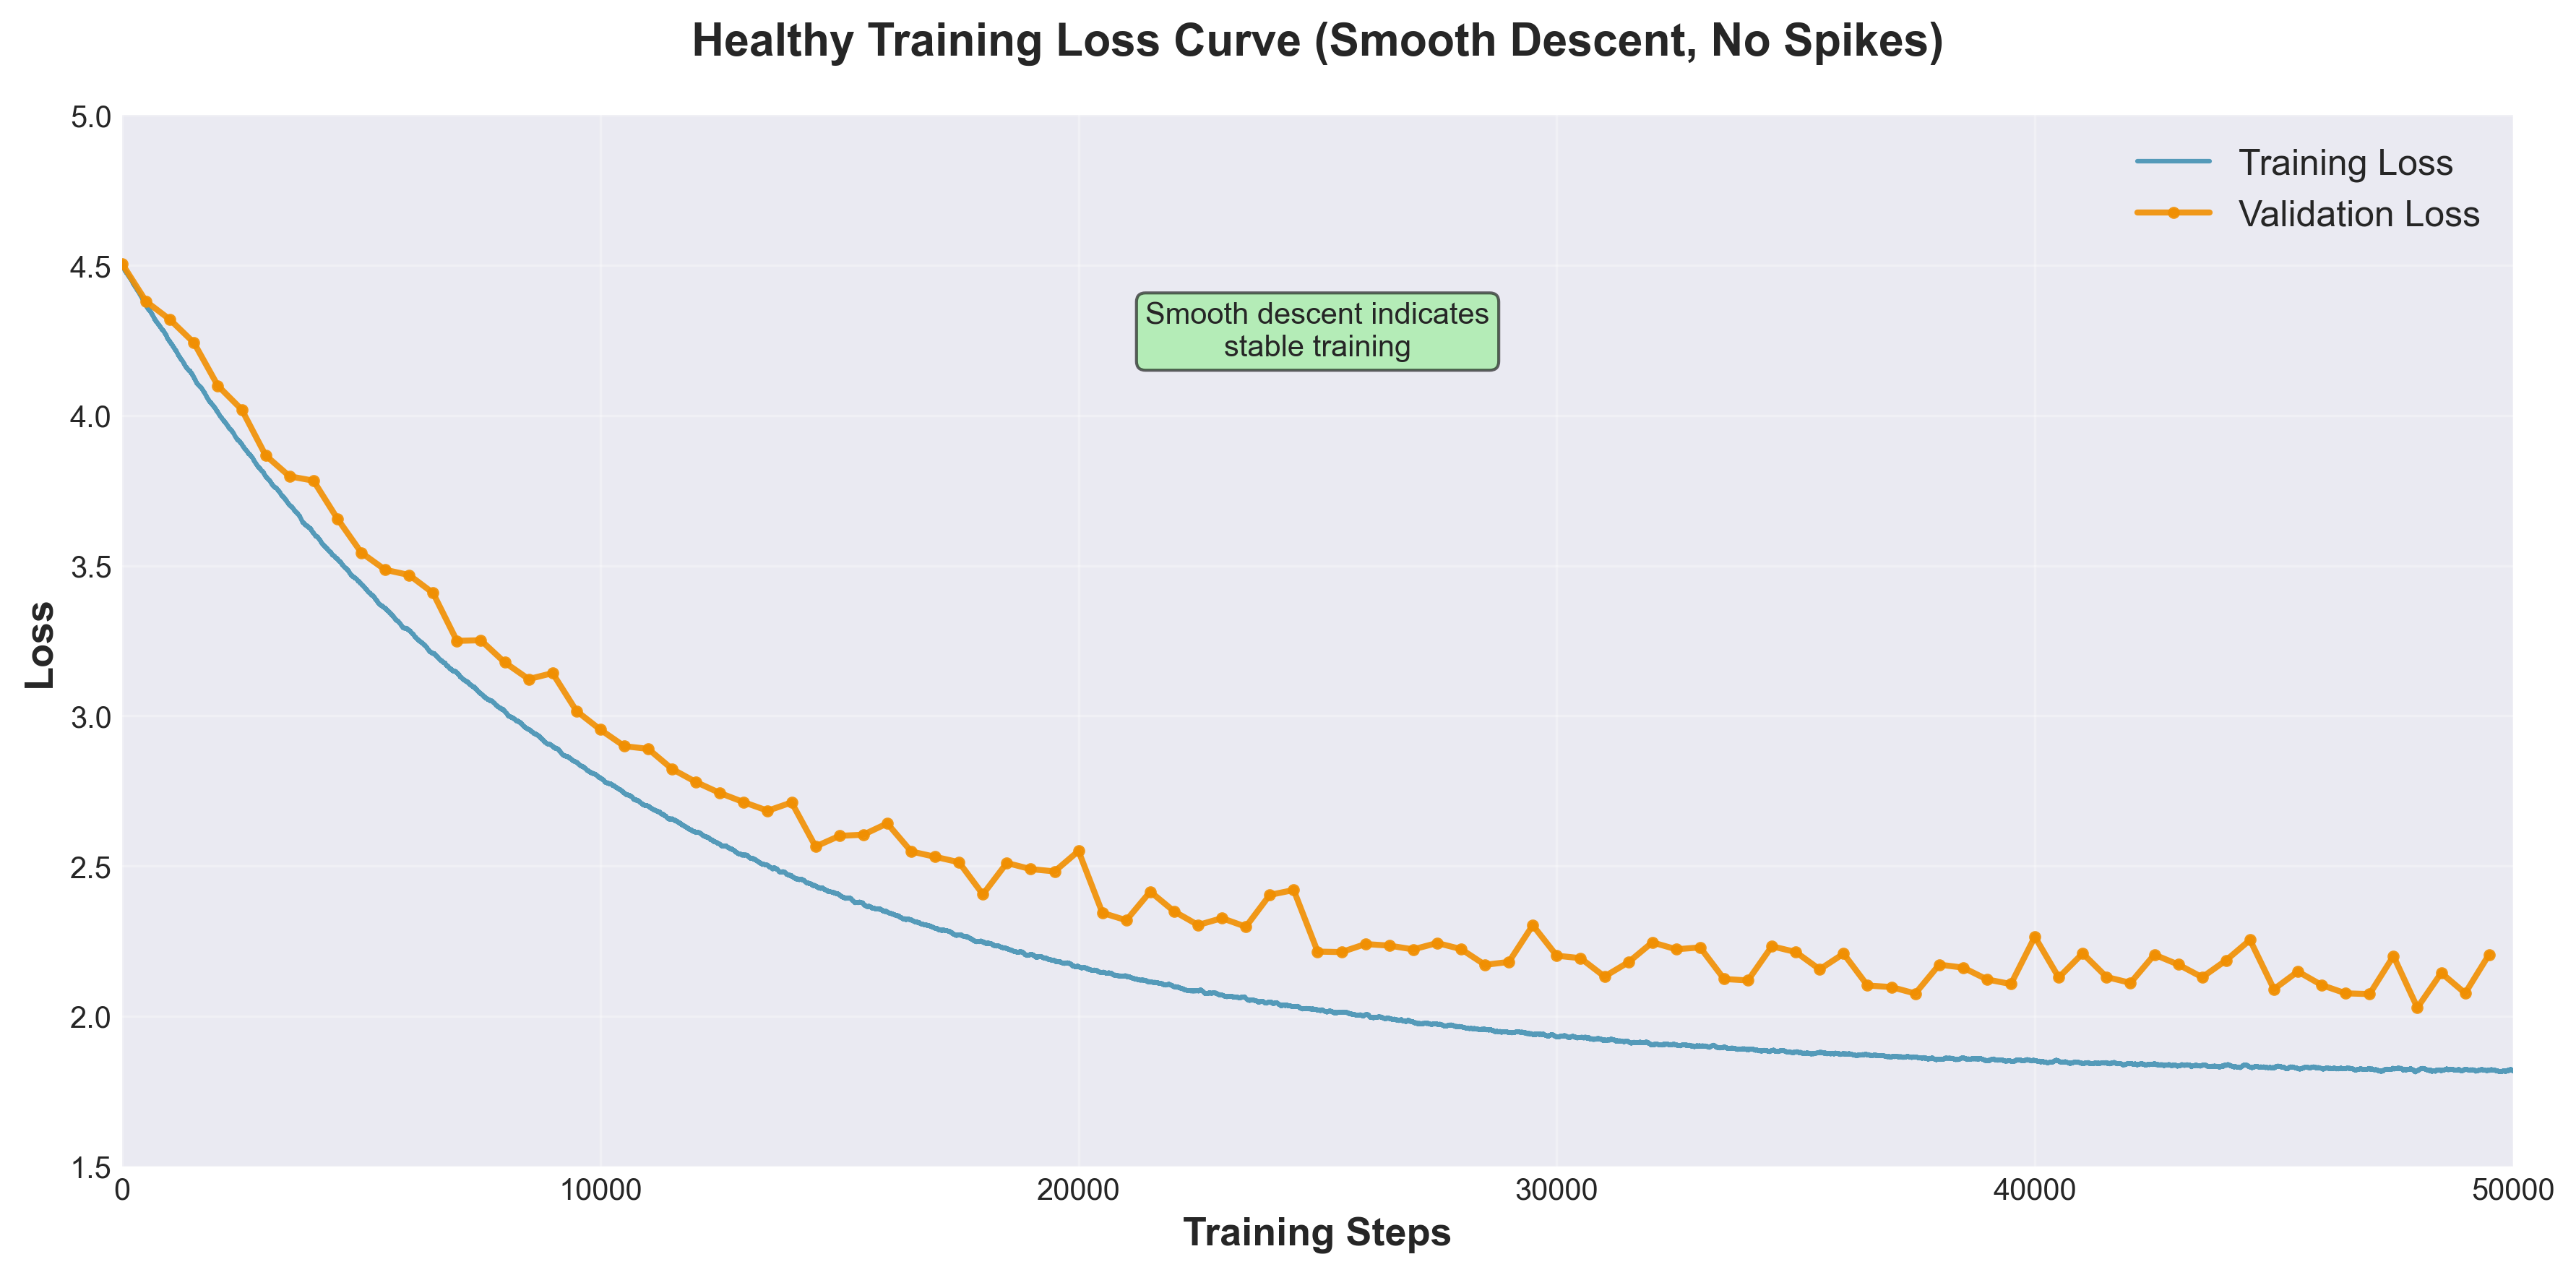
11.3.1 关键监控指标
11.3.1.1 损失函数(Loss)
graph LR
    A[Training Loss] --> B{下降趋势?}
    B -->|正常下降| C[✅ 继续训练]
    B -->|突然上升| D[⚠️ Loss Spike]
    B -->|震荡不稳| E[⚠️ 不稳定]
    B -->|不再下降| F[⚠️ 收敛/过拟合]

    D --> G[降低学习率]
    E --> H[调整batch size<br/>或学习率]
    F --> I[早停或调整]

    style C fill:#c8e6c9
    style D fill:#ffcdd2
    style E fill:#ffcdd2
    style F fill:#fff9c4
正常Loss曲线特征:
- 稳定下降,无剧烈波动
- 预训练loss:初始值约为 $\ln(\text{词表大小})$(32K 词表约 10.4),训练后通常降至 2 左右
- 预训练通常不足 1 个 epoch,训练 loss 与验证 loss 应基本重合;两者明显分叉往往说明数据重复或验证集与训练集分布不一致
异常Loss模式:
| 异常现象 | 可能原因 | 解决方案 |
|---|---|---|
| Loss Spike | 坏数据、学习率过大、数值不稳定 | 回退checkpoint,降低LR,检查数据 |
| Loss不下降 | 学习率过小、模型容量不足 | 增大LR,检查模型架构 |
| Loss震荡 | Batch size过小、LR过大 | 增大batch或降低LR |
| Loss=NaN | 梯度爆炸、数值溢出 | 梯度裁剪、混合精度、检查数据 |
11.3.1.2 梯度相关指标
监控指标:
- 梯度范数(Gradient Norm):应在0.1-10之间
- 梯度裁剪比例:<5%表示健康
- 参数更新比例:更新量应为参数值的0.1-1%
def monitor_gradients(model):
    """计算梯度的L2范数,用于监控训练稳定性"""
    total_norm = 0
    for p in model.parameters():
        if p.grad is not None:
            param_norm = p.grad.data.norm(2)
            total_norm += param_norm.item() ** 2
    return total_norm ** 0.5

# 每100步记录一次梯度范数
if step % 100 == 0:
    grad_norm = monitor_gradients(model)
    logger.log({"gradient_norm": grad_norm})
    # 健康范围:0.1-10,超过100需要警惕
11.3.1.3 学习率监控
# 记录当前学习率(追踪调度器是否正确工作)
current_lr = optimizer.param_groups[0]['lr']
logger.log({"learning_rate": current_lr})
# 期望曲线:Warmup↗ → Stable— → Decay↘
11.3.1.4 性能指标
- 吞吐量(Tokens/second):衡量训练速度
- GPU利用率:应保持在80-95%
- 显存占用:避免OOM,保留10-15%缓冲
- 通信时间占比:<20%为佳
11.3.2 常见问题诊断与解决
11.3.2.1 问题1:Out of Memory (OOM)
症状:CUDA out of memory 错误
解决方案 (按效果排序,逐步尝试):
# 方案1: 启用梯度检查点(节省50-80%激活值显存)
model.gradient_checkpointing_enable()

# 方案2: 减小batch size + 梯度累积(保持等效batch size)
per_device_batch_size = 1
gradient_accumulation_steps = 32

# 方案3: CPU卸载优化器状态(节省Adam的8字节/参数)
from deepspeed.ops.adam import DeepSpeedCPUAdam
optimizer = DeepSpeedCPUAdam(model.parameters())

# 方案4: ZeRO-3全参数分片(最强,但训练速度会降低)
deepspeed_config = {
    "zero_optimization": {
        "stage": 3,
        "offload_optimizer": {"device": "cpu"},
        "offload_param": {"device": "cpu"}
    }
}
11.3.2.2 问题2:训练速度慢
诊断步骤:
# 1. 检查GPU利用率
nvidia-smi dmon -s u

# 2. 系统级时间线:看计算、通信、数据加载是否重叠
nsys profile -o train_profile python train.py

# 3. 算子级分析:在训练脚本中用 torch.profiler 包住若干步,
#    再用 TensorBoard 或 chrome://tracing 查看
常见瓶颈及解决:
- 数据加载慢:增加
num_workers,使用预处理 - 通信慢:检查网络,使用NCCL优化
- 计算慢:检查Flash Attention是否启用
11.3.2.3 问题3:Loss Spike
应对流程:
graph TD
    A[发现Loss Spike] --> B[立即停止训练]
    B --> C[回退到上一个good checkpoint]
    C --> D{分析原因}
    D --> E[检查数据]
    D --> F[检查学习率]
    D --> G[检查梯度]
    E --> H[过滤坏数据]
    F --> I[降低学习率50%]
    G --> J[启用梯度裁剪]
    H --> K[恢复训练]
    I --> K
    J --> K

    style B fill:#ffcdd2
    style C fill:#fff9c4
    style K fill:#c8e6c9
预防措施:
# 技巧1: 梯度裁剪(防止梯度爆炸)
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

# 技巧2: WSD学习率调度(Warmup-Stable-Decay,比纯Cosine更稳定)
# 在peak LR保持一段时间,而非立即衰减

# 技巧3: Loss Spike自动应对机制
if current_loss > moving_avg_loss * 1.5:  # loss突增50%
    print(f"⚠️ Loss spike detected: {current_loss:.4f}")
    for param_group in optimizer.param_groups:
        param_group['lr'] *= 0.5  # 自动降低学习率
    # 可选:自动回退到上一个checkpoint
11.3.3 Checkpoint管理策略
11.3.3.1 保存策略
# Checkpoint保存配置(平衡安全性和存储成本)
checkpoint_config = {
    "save_interval": 1000,           # 每1000步保存(约1-2小时)
    "save_total_limit": 5,           # 保留最近5个(防止磁盘爆满)
    "save_on_each_node": False,      # 只在主节点保存
    "save_optimizer_state": True,    # 必须保存,否则无法恢复
}

# 额外保存最佳模型(按validation loss)
if current_loss < best_loss:
    save_checkpoint(model, "best_model.pt")
    best_loss = current_loss
11.3.3.2 恢复训练
# 从checkpoint恢复
def resume_training(checkpoint_path):
    checkpoint = torch.load(checkpoint_path)

    model.load_state_dict(checkpoint['model_state_dict'])
    optimizer.load_state_dict(checkpoint['optimizer_state_dict'])

    start_step = checkpoint['step']
    start_epoch = checkpoint['epoch']

    # 恢复学习率调度器
    scheduler.load_state_dict(checkpoint['scheduler_state_dict'])

    # 恢复随机数生成器状态(只重设种子无法复现中断前的数据顺序)
    torch.set_rng_state(checkpoint['torch_rng_state'])
    torch.cuda.set_rng_state_all(checkpoint['cuda_rng_state'])

    return start_step, start_epoch
💡 最佳实践
- 在训练开始前进行小规模试运行(100-1000步)
- 设置自动化监控告警(Loss异常、GPU故障等)
- 保留多个历史checkpoint,不要只保留最新的
- 定期手动检查训练日志和可视化图表
11.4 个人级实践案例:MiniMind
11.4.1 项目地址
https://github.com/jingyaogong/minimind
如果说训练 Llama-3 是一场“烧钱”的豪赌,那么 MiniMind 项目则向我们展示了大模型训练的“平民化”可能。
11.4.2 为什么关注 MiniMind?
MiniMind 是一个极简的开源 LLM 训练项目,旨在让开发者在单张消费级显卡上,从零开始完成 LLM 的全流程训练。
11.4.3 核心数据对比
| 维度 | MiniMind (26M版) | Llama-3 (8B版) |
|---|---|---|
| 参数量 | 2.6千万 | 80亿 |
| 硬件要求 | 1 × RTX 3090 | 预训练约 130 万 H100 GPU 小时(Meta 官方模型卡) |
| 训练时长 | ~2 小时 | 数周(在 H100 集群上) |
| 数据规模 | 数 GB 级精选语料 | 15T+ Tokens |
| 成本 | 约 3 元(按云 GPU 租用计) | 数百万美元量级 |
11.4.4 给初学者的启示
- 掌握全流程比堆算力更重要:通过 MiniMind,你可以亲手训练分词器、编写 Transformer 结构、执行从预训练到 DPO 对齐的每一个 Python 脚本。
- 快速验证的想法:如果你有一个新的 Loss 函数或一种新的位置编码,在 MiniMind 这样的小模型上验证速度是极快的。
- SLM 的潜力:在垂直领域(如特定格式转换、逻辑提取),经过精调的超小模型(Small Language Model)同样能爆发惊人的表现。
12. 常见问题(FAQ)
本章汇总大模型训练中最常遇到的问题及解答,帮助快速解决实践中的困惑。
💡 使用技巧:善用 Ctrl+F 搜索关键词快速定位问题
12.1 🏗️ 预训练相关
12.1.1 Q1: 需要多少数据才能训练一个有用的模型?
A: 取决于模型规模和目标:
- 小模型(1-3B):
- 最少:10-50B tokens可得到基本能力
- 推荐:100-300B tokens获得较好效果
- 例如:Phi-1(1.3B)只用约 7B tokens 的高质量数据,就在代码任务上表现很强
- 中型模型(7-13B):
- 推荐:500B-1T tokens
- LLaMA-1 7B使用1T tokens
- 大型模型(70B+):
- 推荐:1.5-2T tokens
- LLaMA-2 70B使用2T tokens
💎 关键洞察:
- 算力最优 vs 推理最优:Chinchilla 的算力最优配比约为每参数 20 tokens(70B 模型约 1.4T tokens)。但部署时推理成本占大头,现代模型普遍远超这个比例”过度训练”小模型——Llama 3 8B 用了 15T tokens,约每参数 1,900 tokens,换取同等推理成本下更强的能力
- 质量 > 数量:Phi-1(1.3B)只用约 7B tokens 的”教科书级”数据,HumanEval pass@1 就达到 50.6%,超过参数量大 10 倍以上的 StarCoder-15B
12.1.2 Q2: 如何判断预训练是否收敛?
A: 观察以下指标:
- Training Loss:
- 不再明显下降(变化<0.01/1000步)
- 典型收敛值:2.0-3.0(取决于数据)
- Validation Loss:
- 与training loss趋势一致
- 如果validation loss上升但training loss下降 → 过拟合
- 下游任务性能:
- 在基准测试上的表现不再提升
- 这是最终判断标准
- 训练步数:由数据量和 batch 决定,而不是模型规模——总步数 ≈ 总 token 数 / 每步 token 数。例如 LLaMA-2 以每步 4M tokens 训练 2T tokens,7B 到 70B 都是约 50 万步
建议:预训练通常不追求完全收敛,因为成本极高且收益递减。在loss曲线趋缓后即可停止。
12.1.3 Q3: 出现Loss Spike怎么办?
A: Loss突然上升的应对流程:
立即行动:
1. 停止训练
2. 回退到spike前的checkpoint(通常回退2-3个checkpoint)
3. 分析spike原因
常见原因及解决:
| 原因 | 症状 | 解决方案 |
|---|---|---|
| 坏数据 | 单次大幅上升 | 跳过该batch,增强数据过滤 |
| 学习率过大 | 逐步上升 | 降低LR至原来的50% |
| 数值不稳定 | 随机出现 | 启用BF16,增加梯度裁剪 |
| 梯度爆炸 | 伴随grad norm飙升 | 降低LR,启用gradient clipping |
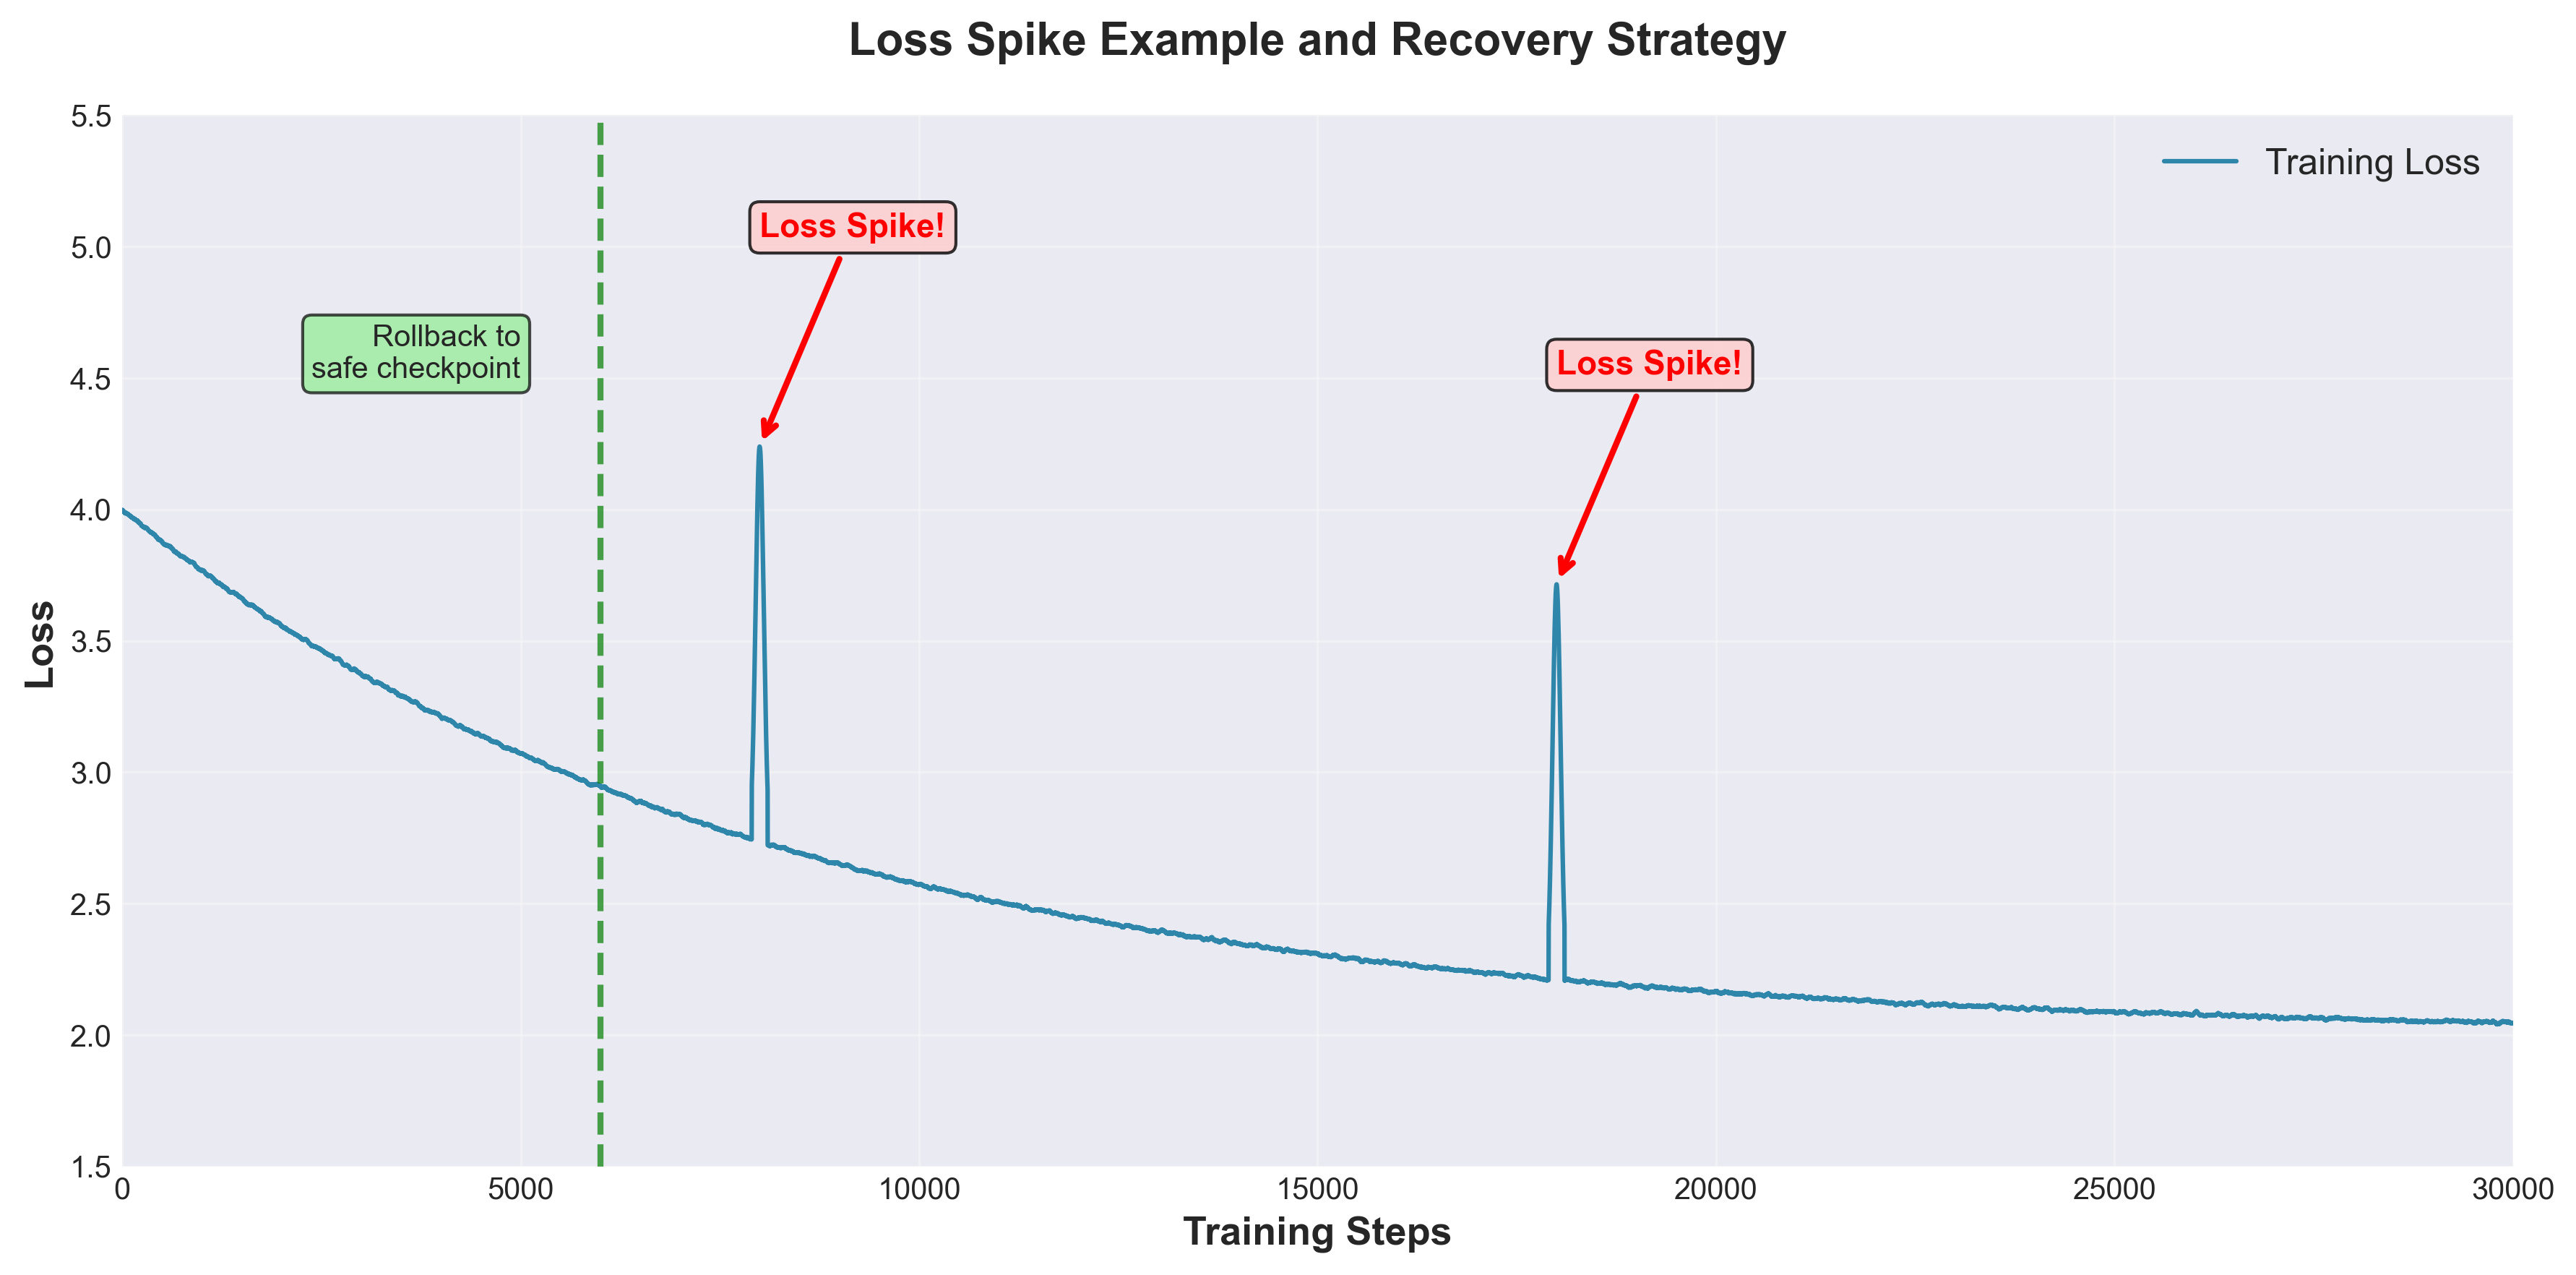
预防手段:梯度裁剪(max_norm=1.0)、BF16 替代 FP16、把 Adam 的 $\beta_2$ 从 0.999 调到 0.95、跳过引发尖峰的数据批次。完整的应对流程与自动检测代码见 11.3.2.3 节;PaLM 报告的经验是,回退到尖峰前约 100 步的 checkpoint 并跳过其后的 200–500 个数据批次,尖峰通常不再复现。
12.1.4 Q4: 预训练可以超过1个epoch吗?
A: 数据充足时不推荐,但数据受限时适度重复是可以的:
- 记忆效应:重复次数过多,模型会记住训练数据,降低泛化能力
- 收益递减:Muennighoff et al.(2023)发现,同一批数据重复训练到约 4 个 epoch,效果与使用全新数据几乎相当;继续重复则收益迅速衰减,最终再增加算力也几乎没有价值
- 行业惯例:主流大模型的网页主体数据都不足 1 个 epoch,但会对 Wikipedia、书籍等高质量小数据源重复 2-3 次(如 LLaMA-1 的 Wikipedia 约 2.45 个 epoch)
例外情况:
- 数据量极小(<10B tokens)时可以多epoch
- 领域专用模型(如医疗、法律)可以在少量高质量数据上多次训练
- 但即使如此,也很少超过3-5 epochs
替代方案:如果数据有限,优先考虑:
- 提升数据质量和多样性
- 增加模型容量
- 采用更好的数据配比策略
12.2 🎨 监督微调(SFT)相关
12.2.1 Q5: LoRA和全参数微调如何选择?
A: 根据场景选择:
全参数微调(Full Fine-Tuning):
- ✅ 适用场景:
- 有充足GPU资源
- 需要最佳性能
- 任务与预训练差异大
- ❌ 劣势:
- 显存需求大(需存储完整梯度和优化器状态)
- 训练速度慢
- 每个任务需要完整模型副本
LoRA微调:
- ✅ 适用场景:
- GPU资源有限
- 需要训练多个任务adapter
- 快速实验和迭代
- ❌ 劣势:
- 学习新知识的能力弱于全参数微调,数据量越大差距越明显
- 需要调整额外超参数(r, alpha,以及比全参数微调更大的学习率)
差距有多大? 取决于任务和数据量:
- LoRA Learns Less and Forgets Less(Biderman et al., 2024):在代码、数学的大规模继续预训练上,LoRA 明显落后于全参数微调;在指令微调上差距较小,同时遗忘更少
- LoRA Without Regret(Thinking Machines, 2025):只要覆盖全部线性层、学习率设为全参数微调的约 10 倍,LoRA 在常规规模的 SFT 和强化学习上可以与全参数微调持平;只有当数据量超出 LoRA 的容量时才会落后
推荐策略:
- 资源受限或快速实验 → LoRA
- 生产环境追求极致性能 → 全参数微调
- 折中方案 → QLoRA(量化+LoRA)
12.2.2 Q6: 需要多少SFT数据?
A: 远少于预训练,质量比数量重要:
数据量指南:
| 数据规模 | 效果 | 适用场景 |
|---|---|---|
| 1k-5k | 基本遵循指令 | 快速原型、特定任务 |
| 10k-30k | 良好对话能力 | 通用助手 |
| 50k-100k | 优秀多任务能力 | 生产级模型 |
| 100k+ | 边际收益递减 | 追求极致性能 |
真实案例:
- Alpaca:52k合成数据,达到不错效果
- Vicuna:70k ShareGPT对话,接近ChatGPT
- LLaMA-2-Chat:27.5k数据,效果优异
关键洞察:
1000条高质量、多样化的数据 > 10000条低质量重复数据
数据质量标准:
- ✅ 指令清晰明确
- ✅ 回答准确、有帮助
- ✅ 覆盖多种任务类型
- ✅ 格式统一规范
- ❌ 避免模板化回答
- ❌ 避免错误信息
- ❌ 避免有害内容
12.2.3 Q7: 如何避免微调时的过拟合?
A: 多种策略组合使用:
1. 控制训练轮数
# 通常1-3个epoch足够
num_train_epochs = 2  # 推荐起点

# 监控validation loss,早停
early_stopping_patience = 3
2. 使用较小学习率
# SFT学习率应远小于预训练
learning_rate = 2e-5  # 而不是3e-4
3. 数据增强
# 释义改写
# 指令变化
# 回答风格多样化
4. Dropout和正则化
model_config = {
    "dropout": 0.1,
    "attention_dropout": 0.1,
    "weight_decay": 0.01
}
5. 混合训练数据
# 加入10-20%预训练数据
mixed_dataset = {
    "sft_data": 0.8,
    "pretrain_data": 0.2  # 防止灾难性遗忘
}
过拟合的症状:
- Training loss持续下降,但validation loss上升
- 在训练集上表现完美,但测试集表现差
- 模型开始”背诵”训练样本
诊断命令:
# 定期评估
if step % eval_steps == 0:
    train_loss = evaluate(model, train_dataset)
    val_loss = evaluate(model, val_dataset)

    if val_loss > best_val_loss:
        patience_counter += 1
        if patience_counter >= early_stopping_patience:
            print("Early stopping triggered!")
            break
12.3 🔁 Post-Training 相关
12.3.1 Q8: Post-Training 后模型旧能力下降怎么办?
A: 这是灾难性遗忘(Catastrophic Forgetting),Post-Training 最常见的问题。
核心原因:训练时只优化目标任务 loss,模型会”忘记”旧知识。即使数据完全无害,即使使用 LoRA,遗忘仍然会发生。
解决方案(优先级从高到低):
方案1:Self-Output 训练(推荐,无需历史数据)
# 对每条训练数据,先用 Foundation Model 自己生成答案
foundation_output = foundation_model.generate(question)

# 如果模型能回答正确,用自己的答案训练
# 如果回答错误,用人类标注答案训练
answer = foundation_output if is_correct(foundation_output) else human_answer
方案2:经验回放(Experience Replay)
# 混入约 3-5% 的旧任务数据(或 Foundation Model 自生成的数据)
mixed_dataset = {
    "new_task_data": 0.97,
    "replay_data": 0.03,  # 历史数据 or Magpie 自生成数据
}
方案3:Magpie 伪经验回放(拿不到历史数据时)
# 让 Foundation Model 自问自答,生成伪历史数据
pseudo_data = []
for _ in range(n):
    q = foundation_model.generate("<|user|>")      # 自己生成问题
    a = foundation_model.generate(q + "<|assistant|>")  # 自己回答
    pseudo_data.append((q, a))
关键结论:
- LoRA 不能真正防止遗忘(只是学得少所以忘得少)
- 即使训练数据无害,Safety Alignment 也会崩溃
- 训练后必须在多个 benchmark 上评估原有能力
12.4 🎯 偏好对齐相关
12.4.1 Q9: RLHF和DPO如何选择?
A: DPO通常是更好的选择:
DPO优势(推荐):
- ✅ 训练更稳定(无RL的探索-利用困境)
- ✅ 实现更简单(不需要PPO、Reward Model)
- ✅ 计算效率高(只需2个模型 vs 4个模型)
- ✅ 效果相当或更好
- ✅ 超参数更鲁棒
RLHF优势:
- ✅ 理论基础深厚
- ✅ 可以在线收集新数据
- ✅ 适合复杂奖励信号
性能对比:
评估维度         RLHF    DPO     备注
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
训练稳定性       ⭐⭐⭐   ⭐⭐⭐⭐⭐  DPO明显更稳定
实现复杂度       ⭐⭐     ⭐⭐⭐⭐⭐  DPO简单很多
计算效率         ⭐⭐     ⭐⭐⭐⭐⭐  DPO快2-3倍
最终效果         ⭐⭐⭐⭐  ⭐⭐⭐⭐   效果相当
推荐策略:
- 首选DPO:适合绝大多数场景
- 考虑RLHF:需要在线学习或复杂奖励函数
- 新方法:ORPO、SimPO等DPO变体
12.4.2 Q10: 偏好数据如何构建?
A: 三种主要方法:
方法1:人工标注(最高质量)
流程:
1. 采样prompts(从真实用户或构造)
2. 生成多个回答(通常4-8个)
3. 人工排序或对比标注
4. 构建偏好对:(prompt, chosen, rejected)

成本:$0.5-2/样本
规模:10k-50k偏好对
质量:⭐⭐⭐⭐⭐
方法2:AI标注(性价比极高,推荐)
# RLAIF: 使用GPT-4等强模型作为"评判者"
prompt = f"""
Given the question: {question}

Response A: {response_a}
Response B: {response_b}

Which response is better? Consider helpfulness, accuracy, and safety.
Answer: A or B
"""
# 实践中要交换 A/B 顺序各评一次,抵消评委的位置偏好
成本:$0.01-0.05/样本(vs 人工的$0.5-2/样本)
规模:轻松扩展到100k+
质量:⭐⭐⭐⭐(RLAIF 论文中 AI 标注与人类偏好的一致率约 78%,与人类标注者之间的一致率相近)
方法3:合成构建(快速启动)
# 从已有SFT数据自动构造偏好对
chosen = high_quality_response
rejected = synthesize_negative(chosen)  # 负样本来源:
    # - 截断回答(模拟不完整)
    # - 注入事实错误
    # - 违反指令要求
    # - 添加有害内容
成本:几乎免费(无需API或人工)
规模:无限(自动生成)
质量:⭐⭐⭐(有效,但负样本太"假"时模型学到的区分能力有限)
混合策略(推荐):
核心数据(20%):人工标注,确保高质量
扩展数据(60%):AI标注,快速扩展规模
补充数据(20%):合成数据,增加多样性
12.5 ⚙️ 工程实践相关
12.5.1 Q11: 如何选择合适的并行策略?
A: 遵循决策树:
graph TD
    A[开始选择] --> B{模型能否<br/>放入单GPU?}
    B -->|能| C[使用数据并行 DP]
    B -->|不能| D{单层参数<br/>是否过大?}

    D -->|是| E[启用张量并行 TP]
    D -->|否| F{层数<br/>是否很多?}

    E --> F
    F -->|是| G[启用流水线并行 PP]
    F -->|否| H[评估总GPU数]

    G --> H
    H --> I{还有<br/>剩余GPU?}
    I -->|是| J[增加数据并行度]
    I -->|否| K[完成配置]

    J --> K

    style C fill:#c8e6c9
    style E fill:#ffcdd2
    style G fill:#fff9c4
    style K fill:#e3f2fd
实用配置表:
| GPU总数 | 模型规模 | 推荐配置 | 说明 |
|---|---|---|---|
| 8 | 7B | DP=8 | 纯数据并行 |
| 16 | 13B | TP=2, DP=8 | 轻量TP |
| 64 | 30B | TP=4, PP=2, DP=8 | 2D并行 |
| 128 | 70B | TP=8, PP=4, DP=4 | 3D并行 |
| 512 | 175B | TP=8, PP=16, DP=4 | 深度3D并行 |
配置验证公式:
# 关键公式:总GPU数 = 数据并行 × 张量并行 × 流水线并行
total_gpus = DP * TP * PP

# 示例:128张GPU跑70B模型
DP = 4   # 4组独立训练(提升吞吐)
TP = 8   # 每层切成8份(单层放不下)
PP = 4   # 分成4段流水线(层太多)
assert 4 * 8 * 4 == 128  # ✓ 刚好用满
12.5.2 Q12: 显存不够怎么办?
A: 多层优化策略:
Level 1:基础优化 💡 (零副作用,必开)
# 技巧1: 混合精度(FP32→FP16/BF16,直接减半)
use_fp16 = True  # 或 bf16(大模型更推荐)

# 技巧2: 梯度检查点(时间换空间,重算激活值)
model.gradient_checkpointing_enable()

# 技巧3: Flash Attention(IO优化,又快又省)
use_flash_attention = True
💾 节省显存:~30-40% ⚡ 性能影响:几乎无(Flash甚至更快)
Level 2:中级优化 ⚙️ (轻微性能trade-off)
# 技巧4: 减小batch + 梯度累积(等效batch不变)
per_device_batch_size = 1      # 从4降到1
gradient_accumulation_steps = 32  # 累积32步更新一次

# 技巧5: ZeRO-2(分片优化器状态,省8字节/参数)
zero_stage = 2  # 优化器状态分布到多GPU
💾 节省显存:额外30-40% ⚡ 性能影响:~10-20%慢(通信开销)
Level 3:激进优化 ⚡ (显著性能损失)
# 技巧6: ZeRO-3全分片 + CPU卸载(参数也分片)
# 技巧7: 激活检查点也卸载到CPU(终极省显存)
deepspeed_config = {
    "zero_optimization": {
        "stage": 3,                              # 分片参数、梯度、优化器
        "offload_optimizer": {"device": "cpu"},  # 优化器→CPU
        "offload_param": {"device": "cpu"}       # 参数→CPU
    },
    "activation_checkpointing": {
        "partition_activations": True,
        "cpu_checkpointing": True                # 检查点激活→CPU
    }
}
💾 节省显存:额外40-50%(可训练超大模型) ⚡ 性能影响:~2-5x慢(CPU-GPU传输瓶颈)
Level 4:终极方案 🔧 (改变训练方式)
# 技巧8: 量化训练(QLoRA: 4-bit量化)
load_in_4bit = True  # 7B模型从14GB→3.5GB

# 技巧9: 降低模型规模(最直接)
model_size = "13B"  # 从70B→13B,显存降5倍
💾 节省显存:量化4x,降模型规模按比例 ⚡ 性能影响:量化略降(<2%),小模型能力降低
显存占用分解:
总显存 = 模型参数 + 优化器状态 + 梯度 + 激活值

示例(70B模型,BF16 混合精度 + AdamW):
- 模型参数(BF16):70B × 2字节 = 140GB
- 梯度(BF16):70B × 2字节 = 140GB
- 优化器状态(FP32 主权重 + m + v):70B × 12字节 = 840GB
- 激活值:取决于batch size和序列长度
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
总计:~1,120GB + 激活值(未优化)

应用ZeRO-3:
- 每个GPU的模型状态:1,120GB / GPU数量
- 8×A100 (80GB):每卡需 140GB → 放不下,必须叠加 CPU/NVMe Offload
- 16×A100 (80GB):每卡需 70GB → 勉强放下模型状态,激活值仍需梯度检查点
12.5.3 Q13: 训练中断如何恢复?
A: 完整的恢复流程:
1. 自动恢复机制
def save_checkpoint(model, optimizer, scheduler, step, epoch):
    checkpoint = {
        'step': step,
        'epoch': epoch,
        'model_state_dict': model.state_dict(),
        'optimizer_state_dict': optimizer.state_dict(),
        'scheduler_state_dict': scheduler.state_dict(),
        'torch_rng_state': torch.get_rng_state(),
        'cuda_rng_state': torch.cuda.get_rng_state_all(),
        'numpy_random_state': np.random.get_state(),
        'python_random_state': random.getstate(),
    }
    torch.save(checkpoint, f'checkpoint_step_{step}.pt')

def load_checkpoint(path, model, optimizer, scheduler):
    checkpoint = torch.load(path)

    model.load_state_dict(checkpoint['model_state_dict'])
    optimizer.load_state_dict(checkpoint['optimizer_state_dict'])
    scheduler.load_state_dict(checkpoint['scheduler_state_dict'])

    # 恢复随机数状态(重要!只重设种子无法复现中断前的数据顺序)
    torch.set_rng_state(checkpoint['torch_rng_state'])
    torch.cuda.set_rng_state_all(checkpoint['cuda_rng_state'])
    np.random.set_state(checkpoint['numpy_random_state'])
    random.setstate(checkpoint['python_random_state'])

    return checkpoint['step'], checkpoint['epoch']
2. 训练脚本支持恢复
python train.py --resume_from_checkpoint ./checkpoint_step_50000.pt
# 训练循环
if args.resume_from_checkpoint:
    start_step, start_epoch = load_checkpoint(...)
    print(f"Resuming from step {start_step}")
else:
    start_step, start_epoch = 0, 0

for step in range(start_step, total_steps):
    # 训练逻辑
    ...
3. 验证恢复正确性
恢复后,loss 曲线应该平滑衔接,不应该有突变或跳跃。检查清单:
- ✓ Loss值连续
- ✓ 学习率正确
- ✓ 随机数状态与数据加载位置恢复(数据顺序一致)
- ✓ Step计数正确
4. DeepSpeed恢复
# DeepSpeed自动处理恢复
model_engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    config=ds_config
)

# 恢复
_, client_sd = model_engine.load_checkpoint(checkpoint_dir)
step = client_sd['step']
⚠️ 注意事项
- 定期保存checkpoint(每1000-5000步)
- 保留多个历史checkpoint(至少最近3-5个)
- 恢复后先验证几步,确保loss正常
- 记录每个checkpoint的验证指标
12.5.4 Q14: 如何判断训练是否正常?
A: 多维度监控清单:
✅ 健康训练的特征:
- Loss曲线
- ✓ 平稳下降,无大幅波动
- ✓ 预训练阶段训练 loss 与验证 loss 基本重合
- ✓ 下降速度符合预期
- 梯度指标
- ✓ Gradient norm在0.1-10范围
- ✓ 梯度裁剪率<5%
- ✓ 无NaN或Inf
- 性能指标
- ✓ GPU利用率>80%
- ✓ 吞吐量稳定
- ✓ 通信时间<20%
- 学习率
- ✓ 按调度正常变化
- ✓ Warmup期平稳上升
❌ 异常训练的症状:
| 症状 | 可能原因 | 检查项 |
|---|---|---|
| Loss不下降 | 学习率过小、数据问题 | 检查LR、查看数据样本 |
| Loss震荡 | 学习率过大、batch小 | 降低LR或增大batch |
| Loss=NaN | 梯度爆炸、数值溢出 | 启用梯度裁剪和混合精度 |
| GPU利用率低 | 数据加载慢、通信瓶颈 | 增加workers、检查网络 |
实战监控代码(W&B):
import wandb

# 记录核心训练指标(每步记录)
wandb.log({
    "train/loss": loss,                     # 📉 最重要,应持续下降
    "train/grad_norm": grad_norm,           # 📊 监控训练稳定性
    "train/learning_rate": lr,              # 📈 验证调度器
    "system/gpu_utilization": gpu_util,     # ⚡ 应保持80-95%
    "system/tokens_per_second": throughput, # 🚀 吞吐量指标
    "step": step
})
智能告警系统(避免半夜被叫醒):
# 设置告警阈值(根据实际情况调整)
if loss > moving_avg * 1.5:
    send_alert(f"🚨 Loss spike! Current: {loss:.4f}, Avg: {moving_avg:.4f}")

if gpu_util < 50:
    send_alert(f"⚠️ GPU利用率低! 当前: {gpu_util}%(可能数据IO瓶颈)")

if grad_norm > 100:
    send_alert(f"💥 梯度爆炸! Norm={grad_norm:.2f}(正常<10)")
13. 迈向多模态与智能体:VLM 架构与 Agent 训练
在纯文本 LLM 的基础上,如何让模型“看见”世界、再进一步自主使用工具完成任务?本章前半部分介绍 Vision Language Model(VLM):融合架构、动态分辨率处理、视觉 Token 编码、两阶段训练流程与一个极简 PyTorch 实现;后半部分介绍 Agent 的工具调用训练。更完整的 VLM 模型梳理见本站的《VLM 综述》。
13.1 视觉-语言融合架构(VLM Architecture)
主流 VLM(如 LLaVA、PaliGemma、Qwen-VL)主要由三个部分组成:
graph LR
    IMG[图像输入] --> VE[Visual Encoder<br/>如 SigLIP / ViT]
    VE --> PROJ[Projection Layer<br/>MLP / Perceiver]
    PROJ --> LLM[LLM Backbone<br/>如 Llama / Qwen]
    TXT[文本 Prompt] --> LLM
    LLM --> OUT[文本回答]

    style VE fill:#e1f5ff,stroke:#01579b
    style PROJ fill:#fff9c4,stroke:#f57f17
    style LLM fill:#c8e6c9,stroke:#1b5e20
13.1.1 视觉编码器 (Visual Encoder)
负责将原始图像转化为特征张量。当前主流选择是预训练好的 ViT-L/14(如 CLIP 或 SigLIP)。
- SigLIP vs. CLIP:早期的 VLM 多使用 CLIP,但近年 SigLIP (Sigmoid Language-Image Pre-training) 已成为主流。CLIP 使用 Softmax 损失进行全局对比学习,需要极大的 Batch Size 且对噪声敏感;而 SigLIP 将图文匹配视为独立的二分类任务,使用 Sigmoid 损失,在较小 Batch Size 下训练更稳定,且具有更强的零样本(Zero-Shot)图像分类与细粒度表征能力。
13.1.2 粘合投影层 (Projection Layer)
负责将视觉编码器输出的特征维度(如 ViT 的 1024 维)映射到大语言模型的词表向量维度(如 Llama-3 的 4096 维),并将视觉特征转化为 LLM 能够理解的“虚拟视觉 Tokens”。
- 线性投影/多层感知机 (Linear/MLP Projection):LLaVA 采用的极简方案,计算开销极低,但会将 ViT 的所有特征全部送入 LLM(如 576 个 Token),随着图像增加,极易占满 LLM 的上下文窗口。
- Perceiver 重采样器 (Perceiver Resampler):Flamingo 采用的方案,第一代 Qwen-VL 也用了类似的单层交叉注意力重采样器。使用一组固定数量的“查询向量(Queries)”通过交叉注意力(Cross-Attention)对 ViT 的海量特征进行聚合,将任意分辨率/任意数量的视觉特征压缩为固定长度(Flamingo 为 64 个,Qwen-VL 为 256 个),极大节省了 LLM 的上下文窗口。(PaliGemma 则与 LLaVA 一样,只用一个线性层把 SigLIP 特征投影到 Gemma 的词嵌入空间。)
- Q-Former:BLIP-2 提出的基于两阶段预训练的 Query 变换器,结构较重但表征能力强。
13.1.3 语言模型基座 (LLM Backbone)
接收交织的视觉 Token 和文本 Token,输出最终的文本回答。训练时可以通过 LoRA 或全参数微调让其学习图文理解。
13.2 动态分辨率处理技术(Dynamic Resolution / Image Patching)
传统的视觉模型会将输入的任意尺寸图像强行缩放到固定分辨率(如 $224 \times 224$ 或 $336 \times 336$)。这对于普通分类任务可行,但对于大模型中的 OCR(字符识别)、图表分析或细粒度目标检测是灾难性的,缩放会导致小文字直接模糊不可读。
为了解决该痛点,现代 VLM(如 LLaVA-NeXT, Monkey, InternVL)采用了动态切片(Image Patching)技术:
flowchart TD
    IMG["原始高分辨率图像<br>如 672×672"] -->|"网格切分"| T1["子图 1<br>336×336"]
    IMG -->|"网格切分"| T2["子图 2<br>336×336"]
    IMG -->|"网格切分"| T3["子图 3<br>336×336"]
    IMG -->|"网格切分"| T4["子图 4<br>336×336"]
    IMG -->|"整体缩放"| G["全局缩略图<br>336×336"]
    T1 & T2 & T3 & T4 & G --> VE["Visual Encoder 分别编码"]
    VE --> SEQ["拼接为一串视觉 Tokens<br>送入 Projection 与 LLM"]

    style IMG fill:#e3f2fd,stroke:#01579b,color:#000
    style G fill:#fff9c4,stroke:#f57f17,color:#000
    style SEQ fill:#c8e6c9,stroke:#1b5e20,color:#000
- 处理流程:
- 将一张高分辨率图像(如 $672 \times 672$)无重叠地切割为 $2 \times 2$ 个子图,每个子图为 $336 \times 336$。
- 另外将原始图强行缩放到 $336 \times 336$,作为“全局缩略图”,用于提供图像全局宏观布局。
- 将这 5 张图分别送入 Visual Encoder 提取特征,由 Projection Layer 映射后拼接为一串视觉 Tokens。
- 这种方式能让大模型看清大图中的小字和细节,代价是视觉 Token 数随切片数成倍增加(上例为 5 × 576 = 2,880 个)。
另一条路线是原生动态分辨率:Qwen2-VL 起不再把图像缩放或切成固定尺寸,而是让 ViT 直接处理任意分辨率的图像(配合 2D 位置编码),视觉 Token 数随图像面积变化,再把相邻 2×2 个 Token 合并以控制序列长度。
13.3 视觉 Token 编码与序列交织
在 VLM 中,图像特征向量在送入 LLM 之前,必须在序列维度与文本进行拼接或交织(Interleaving)。
- 序列表示格式:
在 Token 级别,图像通常会被一对特殊的标志符包裹。例如,一张图映射为 $N$ 个视觉 Token(例如 $N=576$),在对话模板中的形式大致为:
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
<image> v_1 v_2 ... v_N </image> Please describe this image.<|im_end|>
<|im_start|>assistant
其中
v_1 ... v_N并不是词表中的 token,而是投影层输出的向量,在 Embedding 层之后直接替换占位符位置(见 13.5 节代码)。 - Attention Mask 控制: 多数 VLM(如 LLaVA、Qwen-VL 系列)直接沿用 LLM 的因果注意力(Causal Attention),视觉 Token 与文本 Token 一视同仁。也有模型采用 Prefix-LM:PaliGemma 让图像 Token 与前缀文本之间双向可见,只对要生成的回答部分使用因果掩码。
13.4 VLM 的两阶段训练
以 LLaVA-1.5 为代表的主流 VLM 采用两阶段训练,先”对齐模态”,再”学会指令”:
| 阶段 | 训练哪些参数 | 数据 | 目标 |
|---|---|---|---|
| 阶段一:特征对齐预训练 | 只训练投影层;视觉编码器与 LLM 冻结 | 约 55.8 万对图文描述数据(LCS-558K) | 让视觉特征落到 LLM 能理解的词嵌入空间 |
| 阶段二:视觉指令微调 | 投影层 + LLM(全参数或 LoRA);视觉编码器通常仍冻结 | 约 66.5 万条混合指令数据(视觉对话、VQA、OCR、区域描述与纯文本对话) | 让模型能按指令完成多种视觉任务 |
- 为什么先冻结 LLM:随机初始化的投影层一开始输出的是”噪声 Token”,此时放开 LLM 会破坏其语言能力(呼应第 5 章的灾难性遗忘)
- 纯文本数据仍然重要:阶段二混入纯文本对话(LLaVA-1.5 混入了 ShareGPT 数据),可以维持 LLM 原有的对话和推理能力
- 更新的做法:InternVL、Qwen2-VL 等后续模型会在阶段一之后加入大规模图文交错数据的继续预训练,并在后期解冻视觉编码器,以提升 OCR 和高分辨率理解能力
13.5 极简 VLM 前向传播 PyTorch 实现
以下代码演示了如何使用 PyTorch 从零构建一个支持 Vision-Language 融合的极简 VLM 模型:
import torch
import torch.nn as nn
from transformers import AutoModelForCausalLM, AutoConfig

class SimpleVLM(nn.Module):
    def __init__(self, llm_model_name_or_path, visual_dim=1024, embed_dim=4096):
        super().__init__()
        # 1. 实例化 LLM Backbone(此处使用Llama/Qwen架构)
        self.llm = AutoModelForCausalLM.from_pretrained(llm_model_name_or_path)
        self.word_embeddings = self.llm.get_input_embeddings()

        # 2. 简易视觉特征提取器 (可以使用预训练 ViT/SigLIP 代替,此处用随机初始化模拟)
        # 假设输入图像为 336x336x3,ViT 提取后输出的 patch 特征数为 576,每个 patch 维度为 1024
        self.visual_encoder = nn.Sequential(
            nn.Linear(visual_dim, visual_dim),
            nn.GELU()
        )

        # 3. 粘合多层感知机 (MLP Projector)
        # 将 1024 维的视觉向量,映射到 LLM 词嵌入空间的 4096 维
        self.projector = nn.Sequential(
            nn.Linear(visual_dim, embed_dim),
            nn.GELU(),
            nn.Linear(embed_dim, embed_dim)
        )

    def forward(self, text_input_ids, image_features, visual_token_start_idx):
        """
        Args:
            text_input_ids: 文本的 Token IDs, shape: [batch_size, seq_len]
            image_features: 视觉编码器提取的原始特征, shape: [batch_size, 576, 1024]
            visual_token_start_idx: 文本中插入图像占位符的起始索引位置
        """
        # Step 1: 将文本 Token IDs 转化为 LLM 的 Embedding 向量
        # text_embeds shape: [batch_size, seq_len, 4096]
        text_embeds = self.word_embeddings(text_input_ids)

        # Step 2: 提取图像特征并进行模态对齐投影
        # vis_features shape: [batch_size, 576, 1024] -> [batch_size, 576, 4096]
        vis_features = self.visual_encoder(image_features)
        vis_tokens = self.projector(vis_features)

        # Step 3: 在指定位置将视觉 Token 插入并替换文本序列中的占位符
        # 假设在 text_input_ids 中我们预留了长度为 576 的占位符(如特殊的 <image> token)
        batch_size, seq_len, embed_dim = text_embeds.shape
        num_vis_tokens = vis_tokens.shape[1]

        # 构建混合的输入 Embedding 序列
        mixed_embeds = []
        for i in range(batch_size):
            # 将第 i 个样本的视觉 Token,替换到预留的占位位置
            prefix = text_embeds[i, :visual_token_start_idx]
            suffix = text_embeds[i, visual_token_start_idx + num_vis_tokens:]

            # 拼接: prefix (文本) + vis_tokens (图像映射) + suffix (文本)
            sample_embeds = torch.cat([prefix, vis_tokens[i], suffix], dim=0)
            mixed_embeds.append(sample_embeds)

        # mixed_embeds shape: [batch_size, seq_len, 4096]
        mixed_embeds = torch.stack(mixed_embeds, dim=0)

        # Step 4: 送入 LLM 基座进行计算,得到输出 Logits
        outputs = self.llm(inputs_embeds=mixed_embeds)
        return outputs.logits
13.6 Agent 训练:从对话到自主完成任务
2025-2026 年大模型竞争的新焦点已从”对话质量”转向”能否自主使用工具、完成多步任务“(Agentic 能力),如 Kimi K2 等模型即以此为核心卖点。Agent 训练在数据格式和奖励设计上与前几章的对话/推理模型训练有显著差异,本节作为补充。
13.6.1 工具调用 SFT 数据格式
Agent 训练的第一步是让模型学会按固定格式发起工具调用,常见做法是在对话格式中插入专门的工具调用/返回轮次:
<|user|> 帮我查一下北京明天的天气,然后帮我订一张去上海的机票
<|assistant|> <tool_call>{"name": "get_weather", "arguments": {"city": "北京", "date": "明天"}}</tool_call>
<|tool_response|> {"weather": "晴", "temp": "18-26°C"}
<|assistant|> <tool_call>{"name": "book_flight", "arguments": {"from": "北京", "to": "上海"}}</tool_call>
<|tool_response|> {"status": "success", "flight_no": "MU5137"}
<|assistant|> 北京明天天气晴,18-26°C;已为您订好 MU5137 航班前往上海。
与标准 SFT(3.2.2 节)一样,只对 <|assistant|> 部分计算 loss,<|tool_response|> 部分(来自外部环境,非模型生成)不参与梯度计算。这类数据通常采用 ReAct(Reasoning + Acting)格式——模型在每次工具调用前先输出一段简短的思考(为什么调用这个工具、参数怎么定),再输出结构化的调用指令,从经验上看比”直接输出调用”更不容易出现参数错误。
13.6.2 多轮工具调用的 RL 奖励设计
SFT 只能让模型学会”模仿”工具调用的格式,真正提升任务完成率依赖 RL 训练,奖励设计是核心难点:
| 奖励类型 | 设计方式 | 适用场景 |
|---|---|---|
| 任务结果奖励 | 任务最终是否完成(如机票是否订成功)给 0/1 奖励 | 有明确成功标准的任务 |
| 格式/调用合法性奖励 | 工具调用 JSON 格式是否合法、参数是否符合 Schema | 训练初期防止模型输出格式崩坏 |
| 步骤效率惩罚 | 对多余的工具调用、重复调用施加轻微负奖励 | 防止模型”乱试”刷正确率 |
| 过程合理性奖励(可选 PRM) | 中间步骤是否符合逻辑(如先查天气再订票顺序合理) | 复杂多步任务,标注成本高 |
与 4.5.3 节的 ORM/PRM 类似,多步 Agent 任务的”信用分配”问题更突出——一个长达 10 步工具调用的任务失败,很难判断是哪一步出的错。工业界常见做法是优先使用任务结果奖励 + GRPO 组内相对优势(4.5.1 节),让模型通过组内对比自行学习哪些调用序列更优,而非依赖昂贵的步骤级标注。
13.6.3 与现有章节的衔接
Agent 训练并非全新的技术栈,而是对前文技术的组合应用:
- 冷启动:用人工或强模型蒸馏的工具调用轨迹做 SFT(呼应 3.3.2、4.8 节蒸馏方法)
- RL 提升:用 GRPO + 任务结果奖励训练(呼应 4.5、4.6 节 RL 基础设施)
- 环境交互的工程挑战:Rollout 阶段需要真实或模拟的工具环境(API 沙箱、浏览器环境等),比纯文本推理任务的 Rollout 更复杂,通常是 Agent RL 训练中最大的工程瓶颈
14. 参考资源(References & Reading List)
为了帮助深入探索和落地大语言模型训练,本章梳理了本综述提及的核心学术论文、开源社区标杆项目以及推荐的实践学习路径。
14.1 必读经典论文
- 模型架构与注意力:
- Vaswani et al. Attention is All You Need (Transformer 奠基作)
- Dao et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (FlashAttention v1 原理)
- 缩放法则 (Scaling Laws):
- Kaplan et al. Scaling Laws for Neural Language Models (OpenAI 早期缩放理论)
- Hoffmann et al. Training Compute-Optimal Large Language Models (Chinchilla 缩放公式,证明数据量与参数同等重要)
- 主流基座模型:
- Touvron et al. LLaMA: Open and Efficient Foundation Language Models (现代开源 LLM 的基石)
- Llama Team, AI @ Meta. The Llama 3 Herd of Models (数据配比、长上下文扩展与后训练流程的完整工程报告)
- 预训练数据:
- Penedo et al. The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale (15T tokens 网页数据的清洗、去重与教育价值过滤)
- 偏好对齐与强化学习:
- Ouyang et al. Training language models to follow instructions with human feedback (InstructGPT / RLHF)
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model (DPO 算法)
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO 算法首次提出)
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (推理模型的大规模 RL 训练范式与蒸馏)
- 高效微调与分布式训练:
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models (参数高效微调的事实标准)
- Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs (NF4 + 双重量化 + 分页优化器)
- Rajbhandari et al. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (ZeRO 分片)
- Shoeybi et al. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism (张量并行)
- 2024-2026 关键技术报告(架构创新、FP8 训练工程、超大规模 MoE 的一手资料):
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model (MLA 多头潜在注意力首次提出)
- DeepSeek-AI. DeepSeek-V3 Technical Report (FP8 混合精度训练工程细节、671B MoE 架构与真实训练成本披露)
- Qwen Team. Qwen2.5 Technical Report (阿里通义千问系列模型架构与训练方法,关注后续 Qwen3 思考/非思考混合推理模式更新)
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale (GRPO 改进算法,动态采样过滤)
14.2 标杆开源项目
- 分布式训练底座:
- DeepSpeed (微软开源,ZeRO 系列并行技术的最佳载体)
- Megatron-LM (NVIDIA 官方出品,超大规模 3D 混合并行与 GPU 底层优化库)
- 微调与推理对齐工具:
- TRL - Transformer Reinforcement Learning (Hugging Face 出品,内置 SFTTrainer, DPOTrainer 与 GRPOTrainer)
- Unsloth (最强单卡微调加速库,CUDA kernel 重写,可将微调与 GRPO 训练的显存降低达 70-80%)
- RL 训练与 Rollout 推理引擎(呼应 4.6 节 RL 训练工程基础设施):
- 小模型教学实战:
- MiniMind (超轻量大模型全栈训练项目,非常适合在个人显卡上快速跑通预训练到 RL 完整 Pipeline)
14.3 推荐实践学习路径
[步骤1: 理论打底] -> 学习 Stanford CS224n 课程,读懂 Transformer、Causal Masking 机制与自回归解码。
      |
[步骤2: 玩转推理部署] -> 使用 llama.cpp 或 vLLM 部署主流开源模型(如 Qwen-7B),熟悉 INT4/INT8 量化后的显存占用变化。
      |
[步骤3: 玩具模型实训] -> 运行 MiniMind 项目,在单张消费级显卡(如 RTX 3090/4090)上跑通一次百兆参数模型的 Tokenizer 训练、Pre-train、SFT、DPO。
      |
[步骤4: 分布式工程进阶] -> 学习使用 DeepSpeed 配置文件,在多卡环境(如 8x A100)下配置 ZeRO-2/3、Offload 等策略,训练 7B-70B 规模模型。